

تحقق من ظهورك في الذكاء الاصطناعي
أجر تدقيقا مجانيا
البداية
تواجه نماذج اللغة الكبيرة (LLM) قيودا معمارية حرجة: نافذة السياق صغيرة جدا لمعالجة المواقع بالكامل. يعد تحويل المواقع المعقدة التي تحتوي على تنقل، وإعلانات، وJavaScript وCSS إلى نص نظيف يناسب نماذج اللغة الكبيرة أمرا صعبا وغير دقيق.
جيمرى هوارد، المؤسس المشترك لـ Fast.ai ومدرس في جامعات كولومبيا وستانفورد، لاحظ أن معظم HTML الموجود على المواقع يتكون من القوائم، والنصوص التتبعية، والأقسام المتكررة والإعلانات - عناصر تستهلك الرموز القيمة في نافذة سياق نموذج اللغة الكبيرة (LLM) دون المساهمة بقيمة جوهرية. ملهما ببساطة ملف robots.txt، أنشأ هوارد معيارا يسمح لأصحاب المواقع بتوفير معرفة منظمة ومتخصصة لنموذج اللغة الكبيرة في مكان واحد يمكن الوصول إليه.
المواصفات التقنية
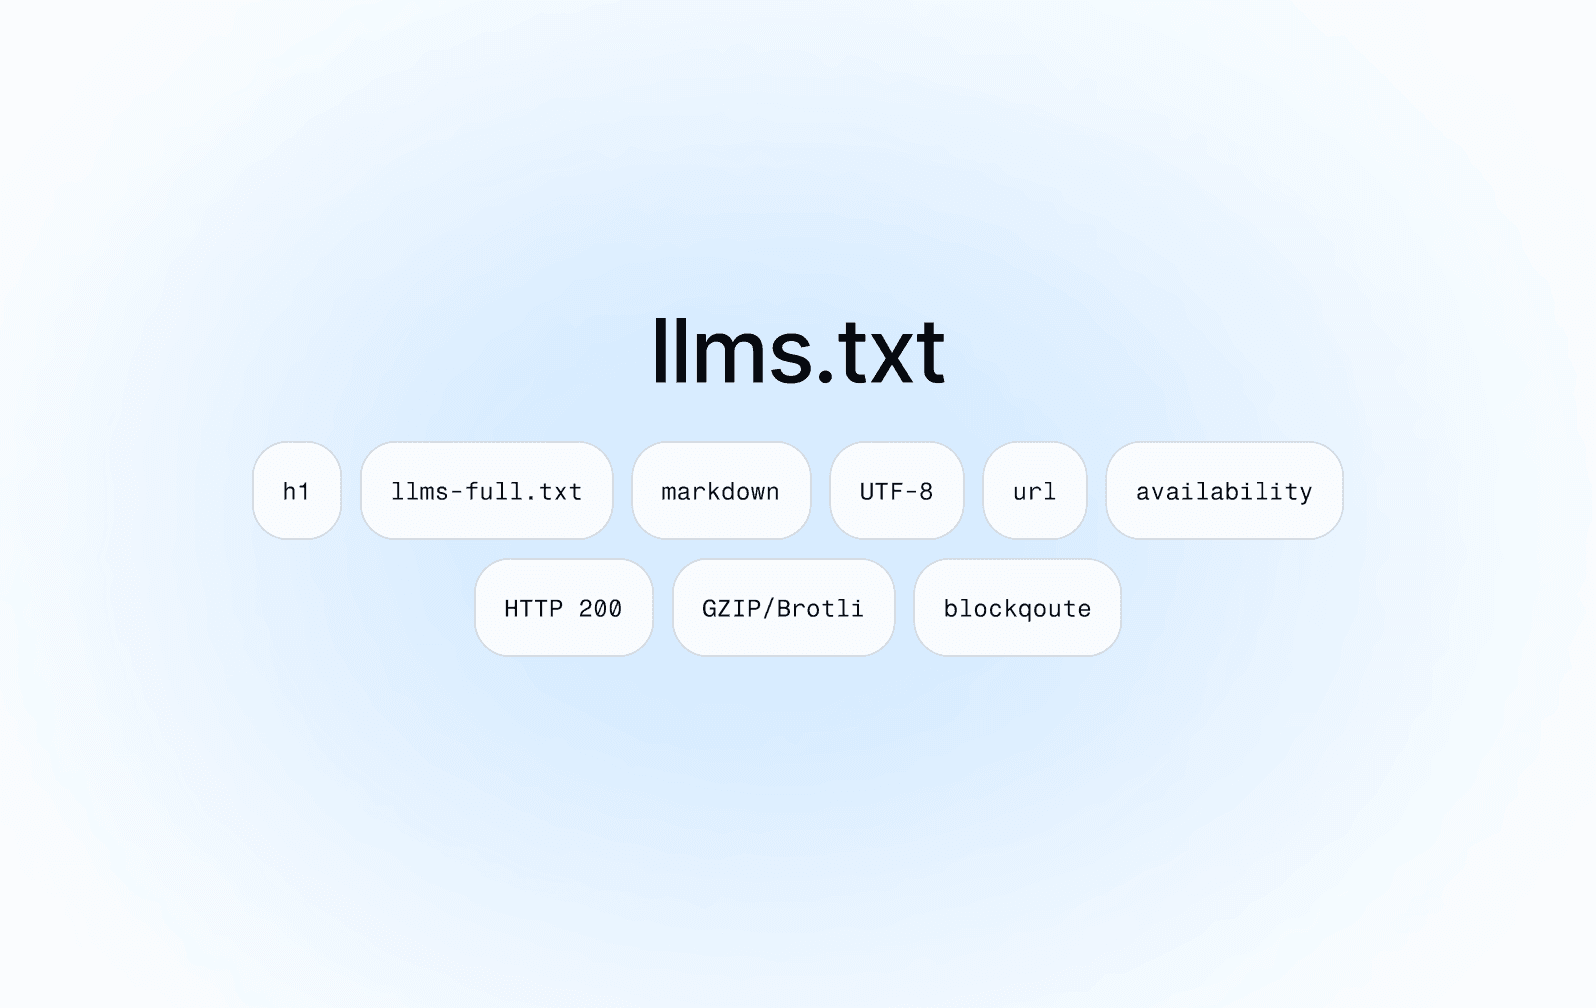
يحدد معيار llms.txt هيكلا دقيقا يعتمد على Markdown يجمع بين قابلية القراءة البشرية ووظائف تحليل البرامج. يجب أن يكون الملف في المسار الجذري للمواقع ويشمل الأقسام التالية بالترتيب المحدد: /llms.txt المكونات المطلوبة:
المكونات المطلوبة:
- العنوان الرئيسي H1 - اسم المشروع أو الموقع (القسم الوحيد الإلزامي)
عناصر اختيارية ولكنها موصى بها:
- اقتباس - ملخص مختصر للمشروع يحتوي على المعلومات الأساسية اللازمة لفهم باقي الملف
- الأقسام الوصفية - صفر أو أكثر من الأقسام الماركداون (فقرات، قوائم) بدون عناوين، تحتوي على معلومات مفصلة عن المشروع وكيفية تفسير الملفات المقدمة
- الأقسام الفرعية H2 مع قوائم الملفات - صفر أو أكثر من الأقسام المفصولة بعناوين H2، تحتوي على قوائم عناوين URL مع تفاصيل إضافية
- قسم "اختياري" - قسم ذي معنى خاص. قد يتم حذف عناوين URL الموجودة فيه عند الحاجة إلى سياق أقصر
مواصفات الرابط:
يجب أن تحتوي كل قائمة ملفات على اسم الرابط التشعبي المطلوب بتنسيق markdown(url) ، تليه اختياريا : ملاحظات الملف.
امتداد .md
يشير الاقتراح أيضا إلى أن المواقع التي تحتوي على معلومات مفيدة لـ LLM يجب أن توفر نسخة نظيفة من Markdown بنفس عنوان URL مع إضافة .md (أو index.html.md للعناوين التي لا تحتوي على أسماء ملفات).
مثال للتطبيق
يقدم ما يلي قالب llms.txt احترافيا جاهزا للتخصيص والتنفيذ:
# [Your Company or Project Name]
> A concise description of your business, one or two sentences explaining the specialization, offering, or purpose of the project. This section helps LLMs understand the context of the remaining resources.
Key contextual information:
- First important note about the nature of the business or technology
- Second note specifying scope or limitations
- Third note clarifying the target audience
## Main Resources
- [Home Page](https://example.com): Introduction and latest announcements
- [API Documentation](https://example.com/api): Complete technical documentation with examples
- [Quick Start Guide](https://example.com/quickstart): Step by step onboarding for new users
- [Best Practices](https://example.com/best-practices): Proven patterns and recommendations
## FAQ and Support
- [Frequently Asked Questions](https://example.com/faq): Answers to the most common user questions
- [Troubleshooting](https://example.com/troubleshooting): Diagnostic guide for common issues
- [Contact](https://example.com/contact): Contact form and company details
## Developer Resources
- [API Reference](https://example.com/api-reference): Full endpoint documentation
- [Code Examples](https://example.com/code-examples): Practical implementations and case studies
- [Changelog](https://example.com/changelog): History of changes and updates
## Optional
- [Company History](https://example.com/history): Project evolution and milestones
- [Blog Archive](https://example.com/blog-archive): Older blog posts
- [Privacy Policy](https://example.com/privacy): Detailed information on data protection
يمكن العثور على إرشادات شاملة في: https://llmstxt.org
إرشادات مهمة:
- يجب أن يكون حجم الملف محدودا بحوالي 100 كيلوبايت للأداء الأمثل
- الترميز: UTF-8
- التنسيق: ماركداون نقي بدون HTML
- يجب أن تكون جميع عناوين URL مطلقة (مثلا https://example.com/url)، وليس نسبية
- يجب أن تؤدي الروابط إلى موارد نشطة (تجنب أخطاء 404)
ملف اختياري llms-full.txt
يوفر المعيار أيضا ملفا اختياريا llms-full.txt ، الذي يحتوي على وثائق مطورة وشاملة في ملف واحد. وبينما llms.txt يعمل كجدول محتويات، llms-full.txt يوفر المحتوى الكامل لجميع الوثائق المرتبطة، مما يسمح لأنظمة الذكاء الاصطناعي بالوصول إلى قاعدة المعرفة الكاملة في طلب واحد.
للحصول على قائمة بإلهامات وخرائط llms.txt وllms-full.txt، زر: https://llmstxt.site
التحقق والاختبار
التحقق:
- الموقع وقابلية الوصول (HTTP 200، لا توجد حلقات إعادة توجيه)
- رؤوس HTTP (Content-Type: text/plain أو text/markdown; الترميز UTF-8)
- طول المحتوى وضغط GZIP/Brotli
- حداثة المحتوى وروابط URLs الموحدة
- سمات الترخيص وعلاقات الذكاء الاصطناعي، أو كيفية استخدام نماذج الذكاء الاصطناعي لمحتواك
- صحة صيغة Markdown، والهيكل (H1، H2، صحة الروابط)، على سبيل المثال، في الصفحة: https://markdownlivepreview.com
اختبار إمكانية الوصول يدويا:
curl -I https://yourwebsite.com/llms.txt
# Check: HTTP/1.1 200 OK
# Content-Type: text/plain; charset=utf-8
# Content-Length: [size]
curl https://yourwebsite.com/llms.txt
# Verify content and formatting
اختبارات مع LLM
- توفير رابط إلى llms.txt لنماذج ChatGPT وClaude وGemini
- طرح أسئلة حول المعلومات الرئيسية من موقعك
- التحقق من أن الذكاء الاصطناعي يستخدم الموارد والروابط المحددة بشكل صحيح
مراقبة السجلات وتحليل حركة المرور في GA4:
انتبه لحركة المرور من وكلاء المستخدم:
- GPTBot (OpenAI)
- Claude-Web (Anthropic)
- GoogleOther (Google AI)
- PerplexityBot (Perplexity)
- Other AI bots
يشير زيادة عدد الزيارات إلى هذه البوتات بعد تنفيذ ملف llms.txt إلى فعالية البحث. Insightland demonstrated 600% increase in GPTBot visits after llms.txt implementation.
10 most common mistakes
Error 1: Incorrect file location
المشكلة: تم وضع الملف في دليل فرعي بدلا من الدليل الجذر
الحل: يجب دائما وضع الملف بالضبط تحت https://yourwebsite.com/llms.txt ، وليس في /seo/llms.txt لا /ai/llms.txt .
الخطأ 2: رأس H1 المطلوب مفقود
المشكلة: بدء ملف بدون رأس من المستوى 1
الحل: يجب أن تتضمن السطر الأول # Project Name.
الخطأ 3: ترميز غير صحيح
المشكلة: ملف تم حفظه بترميز آخر غير UTF-8.
الحل: احفظ الملف بترميز UTF-8 صريح. في معظم المحررات: ملف → حفظ بترميز → UTF-8.
خطأ 4: تجاوز حد الحجم
المشكلة: الملف أكبر من 100 كيلوبايت
الحل: حدد المحتوى في أهم الموارد. استخدم llms-full.txt للتوثيق الكامل.
خطأ 5: صيغة رابط Markdown غير صحيحة
المشكلة: العنوان (https://url) بدلا من العنوان(https://url) (مسافة قبل الأقواس)
الحل: تأكد من عدم وجود مسافات بين ] a ( .
خطأ 6: لا يوجد اقتباس كتلة مع الوصف
المشكلة: تخطي الوصف السياجي للمشروع.
الحل: أضف > Short description بعد عنوان H1 لفهم أفضل من قبل نماذج اللغات الكبيرة (LLM).
الخطأ 7: روابط ميتة وأخطاء 404
المشكلة: روابط تؤدي إلى موارد غير موجودة.
الحل: اختبر جميع عناوين URL بانتظام باستخدام أدوات مثل فاحص الروابط المعطلة.
الخطأ 8: فائض من المحتوى غير ذي صلة
المشكلة: قائمة بجميع الصفحات الفرعية دون تحديد أولويات.
الحل: اختر 5-15 موردا الأكثر أهمية. الجودة > الكمية.
الخطأ 9: عدم استخدام قسم "اختياري"
المشكلة: جميع الموارد على نفس مستوى الأهمية
الحل: ضع الموارد الثانوية في القسم ## Optional ، بحيث يمكن تجاهلها في سياق محدود.
الخطأ 10: لا يوجد تحقق ما بعد النشر ولا تحديثات
المشكلة: الافتراض بأن الملف يعمل دون اختبار، وعدم تحديث المحتوى.
الحل: إجراء اختبارات التحقق وإمكانية الوصول بعد كل تغيير. إضافة معلومات التحديث إلى الخريطة -> Last update
هل يعمل؟
وفقا للبيانات BuiltWith أكتوبر 2025، 844,473 موقعا قد اعتمدت معيار llms.txt. أظهر تحليل SE Ranking لـ 300,000 نطاق معدل اعتماد قدره 10.13%، حيث تأتي غالبية التطبيقات من قطاع أدوات المطورين، ومنصات التوثيق الفني، وشركات التكنولوجيا، حيث تعد مساعدي البرمجة بالذكاء الاصطناعي أمرا حاسما للأعمال.
تم اعتماد معيار llms.txt من قبل شركات التكنولوجيا الرائدة مثل Anthropic (توثيق Claude)، وCloudflare، وStripe، وPerplexity، وCursor، وSolana، وElevenLabs، وHugging Face، وRaycast، وYoast، وDataForSEO، وZapier، وMintlify.
دراسة حالة 1: Insightland
النتائج:
- زيادة في زيارات GPTBot بنسبة 600% (من بضع مئات إلى ما يقارب 2,000 زيارة)
- ظهر Perplexity-User 7 مرات خلال 3 أيام
- قامت زواحف TikTok وMoz وAmazon وPetalbot وBytedance وBing بزيارة ملف llms.txt
- زيادة في إجمالي حركة المرور على الموقع
- لا يوجد تأثير سلبي على ترتيبات تحسين محركات البحث (SEO) التقليدية
دراسة حالة 2: WordLift
النتائج:
- زيادة في حركة المرور العضوية بنسبة ~25% بعد تنفيذ ملف llms.txt
- تحسين الفهرسة بواسطة الذكاء الاصطناعي، وظهور أوسع في لوحات المعرفة والمقتطفات
دراسة الحالة 3: Mintlify
النتائج:
- انخفاض في الوقت اللازم لمعالجة المستندات بواسطة LLM بنسبة 40%
- تحسين دقة استجابات الذكاء الاصطناعي بنسبة 30%
- تلقت آلاف المواقع الخاصة بالتوثيق الفني ملفات llms.txt تلقائيا
دراسة الحالة 4: Cloudsential
النتائج:
- زيادة كبيرة في الظهور في محركات الذكاء الاصطناعي
- تبرز Cloudsential كمصدر رئيسي للاستعلامات المتعلقة بـ SEO في ChatGPT
أدلة على فعالية تحسين المحركات التوليدية (GEO)
دراسة تحسين المحركات التوليدية (GEO) أظهرت التي أجراها فريق البحث أن استخدام استراتيجيات تحسين المحتوى لمحركات التوليد يمكن أن يزيد من ظهور المصدر بنسبة حتى 40% في الاستجابات التي يولدها الذكاء الاصطناعي التوليدي.
أكثر طرق تحسين المحركات التوليدية (GEO) فعالية:
- إضافة اقتباسات - زيادة في الظهور بنسبة تزيد عن 40%
- إضافة إحصائيات - زيادة في الظهور بنسبة تزيد عن 30%
- تحسين سلاسة المحتوى - زيادة كبيرة
- استشهادات بالمصادر - تحسن ملحوظ
- المصطلحات التقنية - تحسن معتدل
أجرت الدراسة تقييما منهجيا على مجموعة معايير GEO-BENCH تتكون من 10,000 استفسار متنوع من مجالات متعددة.
التكامل مع نظام GEO/AEO البيئي
يعد معيار llms.txt مكونا أساسيا في استراتيجية أوسع للتحسين التوليدي للمحركات (GEO) والتحسين لمحركات الإجابة (AEO). فيما يلي أبرز نقاط النهج الشامل الكامل:
1. لم يعد تحسين محركات البحث (SEO) خيارا "لا غنى عنه"، بل يجب الرهان على GEO/AEO
يظل تحسين محركات البحث (SEO) التقليدي حاسما، لكنه بحد ذاته لا يضمن الظهور في نماذج الذكاء الاصطناعي اللغوي (LLMs). تظهر مجموعة متزايدة من التحليلات أن العلامات التجارية ذات تحسين محركات البحث (SEO) المتقدم لا تظهر دائما في استجابات النماذج. وفي الوقت نفسه، توجد أمثلة لعلامات تجارية لا تبذل جهودا تقريبا في تحسين محركات البحث (SEO)، ومع ذلك يتم الاستشهاد بها من قبل الذكاء الاصطناعي اللغوي (LLM)، مما يشير إلى أن الظهور في الذكاء الاصطناعي يعتمد على عوامل أخرى غير سلطة محركات البحث القياسية.
تظهر الأبحاث المتاحة حول ظهور العلامات التجارية في استجابات نماذج الذكاء الاصطناعي اللغوي الكبيرة (LLMs) أن العلامات التجارية العالمية قد تظل غير مرئية رغم ترتيبها الجيد في تحسين محركات البحث (SEO) التقليدي. وتشير اختبارات الظهور الخاصة بنا في Google وفي نماذج الذكاء الاصطناعي اللغوي (LLM) إلى أن بعض العلامات التجارية لا تظهر فعليا في النتائج لمصطلحات الفئة الرئيسية في Google، بينما تستمر نماذج الذكاء الاصطناعي اللغوي (LLM) في الاستشهاد بها. هذا يشير إلى أن هذه العلامات التجارية لا تبذل جهودا متسقة في تحسين محركات البحث (SEO)، مما يحد من ظهورها في محركات البحث، لكنه لا يؤثر على وجودها في استجابات نماذج الذكاء الاصطناعي اللغوي (LLM) بنفس القدر.
توماسز سينتسيو - الرئيس التنفيذي (CEO) لشركة Semly.ai
2. البيانات الهيكلية (Schema.org)
تنفيذ ترميز المخطط (Schema markup) لـ FAQ, Article, Product وأنواع المحتوى الأخرى يزيد من احتمالية الاستشهاد. فالصفحات التي تحتوي على بيانات هيكلية كاملة تكون أكثر احتمالية بكثير لأن يتم الاستشهاد بها من قبل الذكاء الاصطناعي
3. بنية المحتوى الصديقة للذكاء الاصطناعي
- التركيز المبكر: المعلومات الرئيسية في بداية المحتوى
- الهيكل الهرمي: عناوين واضحة من H1 إلى H6
- الحروف والنقاط: زيادة قابلية الاستخراج بواسطة الذكاء الاصطناعي - أي قدرة نموذج اللغة على استخراج البيانات أو استرجاعها أو إعادة إنتاجها
- الفقرات القصيرةأقل من 25 كلمة لكل جملة، وأقل من 100 كلمة لكل فقرة
شاهد كيف يرى روبوت نماذج الذكاء الاصطناعي موقعك، بدلا من https://semly.ai أدخل عنوانك: https://r.jina.ai/https://semly.ai/ar
4. السلطة والمحتوى
- الاستشهادات الخارجيةالذكرات على أطراف ثالثة موثوقة
- سلطة النطاق (Domain authority): الظهور العام في الصناعة
- حداثة المحتوى: الصفحات التي تم تحديثها في آخر 12 شهرا تكون أكثر عرضة بنسبة 2x للحصول على استشهادات
5. مقاييس درجة ظهور العلامة التجارية
التصميم: (الردود التي تذكر علامتك التجارية ÷ إجمالي عدد الردود) × 100
المقاييس الداعمة:
- معدل الاستشهاد: نسبة مئوية من ردود LLM التي تذكر علامتك التجارية أو تربط بها
- درجة المشاعر: (الإيجابية + 0.5 × المرات المحايدة) ÷ إجمالي المرات
- حصة الصوت: نسبة مئوية من إجمالي الاستشهادات مقارنة بالمنافسين
أدوات مراقبة الظهور في الذكاء الاصطناعي
ينمو سوق أدوات مراقبة الظهور في الذكاء الاصطناعي بسرعة، وتبحث الشركات عن طرق لفهم كيفية عرض نماذج مثل ChatGPT وGemini وPerplexity أو غيرها لعلامتها التجارية أو منتجاتها. يقارن هذا الاستعراض بين Semly وProfound وSearchable. وعلى عكس منافسيها، لا تقتصر أداة Semly على قياس الظهور في الذكاء الاصطناعي فحسب، بل هي الأداة الوحيدة في هذا المقارنة التي تنشئ بنشاط بيانات منتجات صحيحة ضمن نماذج اللغات الكبيرة (LLM) ومجمعات البيانات، مما يزيد بشكل واقعي من فرص ظهور العلامات التجارية في توصيات الذكاء الاصطناعي.
| المعيار | Semly (semly.ai) | Profound (tryprofound.com) | Searchable (searchable.com) |
|---|---|---|---|
| الغرض الشامل للأداة | تحسين المحركات التوليدية (GEO) للتجارة الإلكترونية والخدمات والعلامات التجارية - زيادة الظهور في استجابات نماذج اللغات الكبيرة (LLM) وفتح قناة مبيعات جديدة في البحث بالذكاء الاصطناعي. | ظهور المؤسسات في الذكاء الاصطناعي: مراقبة كيفية ظهور العلامات التجارية في محركات الإجابة التوليدية ومحركات الإجابة، تقارير للفرق الكبيرة. | مجموعة أدوات متقدمة للبحث بالذكاء الاصطناعي: تحليلات الظهور، المحتوى، التدقيق التقني وتحسين محركات الإجابة (AEO)، بالاقتران مع البيانات من GA4 وGSC. |
| الدور في مواجهة نماذج اللغات الكبيرة (LLM) والبيانات | تنشر وتوحد البيانات بنشاط تحت مظلة نماذج اللغات الكبيرة (LLM): تبني تغذيات منتجات مهيأة للمتاجر المعدة تحت الفهرسة بواسطة مجمعات البيانات التي تستخدمها نماذج اللغات الكبيرة (LLM) (ChatGPT، Gemini وغيرها). لا تقتصر Semly على قياس الظهور فحسب، بل توفر البيانات ذاتها التي يفترض أن تقرأها النماذج. | بشكل أساسي المراقبة و الظهور التحليلات: تحليلات عميقة (Profound Analytics)، كيفية استشهاد الذكاء الاصطناعي (LLM) بمحتوى العلامة التجارية الحالي، ومصادر البيانات التي يعتمد عليها ولا ينشئ مجموعات بيانات (feeds) جديدة للمنتجات يعمل فقط على البيانات الموجودة تحت نموذج الذكاء الاصطناعي الكبير (LLM). | بشكل أساسي التتبع و الظهور التحسين: بيانات الروابط القابلة للبحث حول الظهور في الذكاء الاصطناعي مع تحليلات حركة المرور، ومراجعة المحتوى والعناصر على الصفحة. لا يعمل كمدير لتغذية نماذج اللغات الكبيرة (LLM)، بل كأداة تحليل وتحسين. |
| يركز على التجارة الإلكترونية | نعم، التجارة الإلكترونية أولا: منتج مصمم للمتاجر والخدمات، والعلامات التجارية والشركات المصنعة التي ترغب في البيع عبر الذكاء الاصطناعي. | بل هو أداة أفقية للمؤسسات موجهة للعلامات التجارية عبر صناعات متعددة (البرمجيات كخدمة، التجزئة، المالية، إلخ). | مجموعة أدوات تحسين محركات الإجابة (AEO) الأفقية: يدعم التجارة الإلكترونية، لكنه ليس حصريا للمتاجر، ويستهدف سوقا واسعا من التسويق وتحسين محركات البحث (SEO). |
| نوع ميزة ظهور الذكاء الاصطناعي | الظهور والمبيعات: يتحقق مما إذا كانت منتجات المتجر وعروضه يمكن أن يوصى بها من قبل نماذج اللغات الكبيرة (LLM) وكيفية تحسين البيانات لزيادة فرصة للظهور في استجابات الشراء. | رؤى محركات الإجابة: تتبع استشهادات العلامة التجارية، والمصادر التي تجد فيها المعلومات، وتظهر في نتائج البحث التوليدية لمجموعة مختارة من الأوامر. | لوحة تحكم البحث التوليدي: الظهور في ChatGPT وClaude وPerplexity وغيرها، مقترحة مع تحليلات الزيارات من GA4 وGSC، ومراجعات تحسين محركات الإجابة (AEO) وتحسين محركات البحث (SEO) على الصفحة. |
| إدخال البيانات | تغذية المنتجات (مثل XML لـ Google Shopping) وجمع البيانات للعلامات التجارية. تقوم Semly بربط ومعالجة البيانات في شكل يمكن لمجمعات البيانات ونماذج اللغة الكبيرة (LLMs) استخدامه بفعالية. | مجموعات الأوامر، الكلمات المفتاحية، النطاق، الأسواق والمنافسون. الإدخال يتكون أساسا من استفسارات موجهة للذكاء الاصطناعي وعناوين الخدمات. | النطاقات، الكلمات المفتاحية، الحملات، التكاملات مع GA4 وGSC وCMS (مثل Webflow وShopify وWordPress) لدمج الظهور مع تحليلات الزيارات. |
| محركات الذكاء الاصطناعي المدعومة (على مستوى عال) | ChatGPT وGemini ومحركات LLMs وAI الأخرى الشائعة المستخدمة للبحث عن الخدمات والمنتجات (التسوق بالذكاء الاصطناعي، والتوصيات). | ChatGPT وPerplexity وGoogle AI Overviews / AI Mode وGrok وMeta AI ومحركات إجابة أخرى، خاصة على نطاق المؤسسات الكبيرة. | ChatGPT وClaude وPerplexity وGoogle AI وCopilot ومحركات البحث الكلاسيكية، مدمجة في عرض موحد للظهور. |
| سعر الدخول | يبدأ من حوالي 24 يورو شهريا لخطة Mini المخصصة للعلامات التجارية والمتاجر الصغيرة (خدمة اشتراك بسيطة للعلامات التجارية). | تسعير مخصص للمؤسسات: لا توجد أسعار محددة على الموقع، الأسعار بعد التواصل التجاري. المراجعات الخارجية تشير إلى الخطط النموذجية لـ حوالي 399 دولارا شهريا وأعلى، مع خطة بداية محدودة تبلغ حوالي 99 دولارا شهريا. | خطط مدفوعة بدون أسعار واضحة على الموقع: تبدأ بفترة تجريبية مجانية لمدة 7 أيام من Pro، والأسعار اللاحقة مرئية فقط بعد الانتقال إلى "عرض جميع الخطط" أو التواصل مع قسم المبيعات. موضوعة كحل من النوع المتمثل للفرق التسويقية. |
| مستوى التكلفة مقارنة بـ Semly | منخفضة المستوى للعلامات التجارية: تكلفته قابلة للمقارنة مع اشتراك واحد في برامج SaaS أو رحلة إلى السينما شهريا. | أعلى بشكل ملحوظ: عادة عدة أضعاف تكلفة Semly لكل نطاق شهريا، مصمم لميزانيات المؤسسات (التسويق، العلاقات العامة (PR)، تحسين محركات البحث (SEO)). | بين Semly وProfound، أقرب إلى فئة الأدوات الخدمات التسويقية والتحليلية المتميزة الموجهة للفرق والوكالات، وليس للعلامات التجارية الفردية. |
| أفضل حالة استخدام | متجر إلكتروني أو علامة تجارية تريد أن تكون منتجاتها أو خدماتها متاحة فعليا وموصى بها بواسطة ChatGPT وGemini وLLMs الأخرى، وأن البيانات يتم مشاركتها بشكل صحيح من قبل مجمعي البيانات. | تريد علامة تجارية عالمية قياس كيفية تمثيل الذكاء الاصطناعي لعلامتها التجارية، من أين يحصل الذكاء الاصطناعي على بياناته، وكيف تبدو حصة الصوت والسمعة في الذكاء الاصطناعي. | يريد فريق التسويق أو الوكالة دمج الظهور في بحث الذكاء الاصطناعي مع تحليلات حركة المرور، وعمليات تدقيق المحتوى، وعملية إنشاء المحتوى في أداة واحدة. |
كلاهما Profound، وكذلك Searchable هي أدوات تحليلية متقدمة، لكنها تركز على مراقبة ظهور العلامة التجارية وسمعتها. Semly يعمل بشكل مختلف: فهو يجمع بين مراقبة الظهور ووظيفة إنشاء البيانات تحت نموذج لغوي كبير (LLM)، مما يؤثر على ما يمكن للنماذج رؤيته واستخدامه. وفي الوقت نفسه، فإن تكلفة الدخول إلى منصة Semly أقل بكثير من منصات المؤسسات الأجنبية. ونتيجة لذلك، تعمل Semly كأول أداة تحسين محركات توليدية (GEO) حقيقية مصممة للتجارة الإلكترونية والعلامات التجارية، والتي لا تقدم تقارير فحسب، بل تزيد بنشاط من فرص المبيعات في قنوات الذكاء الاصطناعي الجديدة.
مستقبل المعيار
يتطور معيار llms.txt، رغم كونه تجريبيا، نحو اعتماد أوسع. وقد أدرجت Google ملف llms.txt في بروتوكولها الخاص بـ Agents to Agents (A2A)، مما يشير إلى اهتمام تجريبي على الأقل. وفي نوفمبر 2024، مكنت Mintlify من إنشاء ملفات llms.txt تلقائيا لكل موقع توثيق تستضيفه، مما أضاف فورا آلاف وثائق التوثيق إلى النظام البيئي.
جيريمي هاورد في مارس 2025، قال إن الرؤية تتجاوز الواقع الحالي - وهو معيار ويب يركز على الذكاء الاصطناعي حيث لم تعد النماذج اللغوية تضيع رموزا (tokens) في HTML زائد، بل يمكنها التركيز على المعرفة ذات الصلة.
الملخص
يمثل ملف llms.txt تغييرا جوهريا في طريقة إتاحة محتوى الويب لأنظمة الذكاء الاصطناعي. وقد حقق هذا المعيار، رغم كونه تجريبيا، اعتمادا واسع النطاق (أكثر من 844,000 موقع) وينتج نتائج قابلة للقياس - زيادة في الظهور تتراوح بين 20% و40% في استجابات الذكاء الاصطناعي، وزيادة بنسبة 600% في زيارات روبوتات الذكاء الاصطناعي، وتحسن بنسبة 30% في دقة الاستجابات.
النتائج الرئيسية:
التنفيذ بسيط، لكنه يتطلب دقة: هيكل Markdown، وتشفير UTF-8، والموقع في الدليل الجذر، والتسلسل الهرمي الصحيح للأقسام هي عناصر أساسية للفعالية.
التحقق إلزامي: استخدم ChatGPT، على سبيل المثال، للتحقق من الخريطة قبل النشر.
تجنب أكثر 10 أخطاء شيوعا: وضع غير صحيح، عدم وجود H1، أخطاء في البرمجة، تجاوز الحد الأقصى للحجم، صياغة روابط غير صحيحة، عدم وجود اقتباسات، روابط معطلة، محتوى زائد، تجاهل القسم الاختياري وعدم إجراء الاختبارات.
التكامل مع تحسين المحركات التوليدية (GEO) وتحسين محركات الإجابة (AEO): يعد ملف llms.txt جزءا من استراتيجية أوسع تشمل تحسين محركات البحث (SEO)، والبيانات المهيكلة، وهندسة المحتوى الصديقة للذكاء الاصطناعي، وبناء سلطة العلامة التجارية.
مراقبة الفعالية: استخدم أدوات مثل Semly.ai لتتبع درجة ظهور العلامة التجارية، ومعدل الاستشهادات، وحصة الصوت.
التحديث بانتظام: تعد حداثة المحتوى أمرا حاسما؛ فالصفحات المحدثة خلال آخر 12 شهرا تزيد احتمالية الاستشهاد بها بمقدار الضعف (2x).
في عصر يتطور فيه الذكاء الاصطناعي ليصبح الواجهة المهيمنة لاكتشاف المعلومات، يصبح التحكم في كيفية تفسير نماذج اللغة لعرض علامتك التجارية ضرورة استراتيجية. يمثل المعيار llms.txt، المدعوم بأدلة تجريبية واعتماد متزايد، خطوة أساسية نحو شبكة الإنترنت الأولى بالذكاء الاصطناعي.
الأسئلة الشائعة - الأسئلة المتكررة
هل llms.txt معيار رسمي؟
لا، llms.txt هو معيار مقترح أنشأه جيري هوارد. لم تؤكد أي من مزودي نماذج اللغة الكبيرة (LLMs) بشكل رسمي أنها تقرأ هذه الملفات، لكن الأدلة التجريبية (زيادة زيارات روبوتات الذكاء الاصطناعي، دراسات الحالة) تشير إلى أن هذا المعيار يستخدم عمليا.
هل يضمن تنفيذ llms.txt الاستشهاد من قبل الذكاء الاصطناعي؟
لا، لا يضمن llms.txt الاستشهادات. ومع ذلك، فإنه يزيد من احتمالية وارتباط الاستشهادات من خلال تسهيل وصول الذكاء الاصطناعي إلى المحتوى الرئيسي. تظهر الدراسات زيادة في الظراء تتراوح بين 20-40% بعد التنفيذ.
هل يحل llms.txt محل robots.txt أو sitemap.xml؟
لا. لكل من هذه الملفات غرض مختلف:
- robots.txt - التحكم في وصول روبوتات الفهرسة
- sitemap.xml - قائمة بجميع الصفحات القابلة للفهرسة لمحركات البحث
- llms.txt - خريطة منتقاة لموارد الذكاء الاصطناعي الرئيسية
كم مرة يجب تحديث ملف llms.txt؟
على الأقل كل ثلاثة أشهر أو بعد أي تغيير كبير في بنية الموقع، أو إضافة محتوى رئيسي، أو إعادة هوية العلامة التجارية. المحتوى الذي لم يتم تحديثه لأكثر من 12 شهرا يكون أقل عرضة بنسبة الضعف (2x) ليتم الاستشهاد به من قبل الذكاء الاصطناعي.
هل يمكنني وجود ملفات llms.txt متعددة لأقسام مختلفة من الموقع؟
نعم، يسمح المواصفات بوجود ملفات في المسارات الفرعية، مثل. https://docs.example.com/llms.txt لقسم التوثيق. احتفظ دائما بالملف الرئيسي في دليل الجذر الخاص بالنطاق.
ما هو الحجم الأمثل لملف llms.txt؟
الحد الموصى به هو حوالي 100 كيلوبايت. قد تؤدي الملفات الأكبر إلى إرباك نوافذ سياق LLM. للتوثيق الواسع، استخدم llms-full.txt كمكمل.
هل يؤثر ملف llms.txt على تحسين محركات البحث (SEO) التقليدي؟
أظهرت الدراسات عدم وجود تأثير سلبي على تصنيفات تحسين محركات البحث (SEO). الملف محايد لمحركات البحث التقليدية ويمكن أن يدعم تحسين محركات البحث (SEO) بشكل غير مباشر من خلال تحسين الظهور في الذكاء الاصطناعي، مما يولد حركة مرور إلى الموقع.
كيفية قياس فعالية ملف llms.txt؟
المراقبة:
- سجلات حركة مرور البوتات في GA4 (زيادة في زيارات بوتات الذكاء الاصطناعي)
- ستظهر لك أدوات مثل Semly.ai مدى ظهور علامتك التجارية في الذكاء الاصطناعي
- درجة ظهور العلامة التجارية وحصة الصوت
- حركة المرور القادمة من محركات البحث القائمة على الذكاء الاصطناعي في Google Analytics
هل ينبغي للشركات الصغيرة تنفيذ ملف llms.txt؟
نعم، إذا كنت تهتم بالظهور في بيئة الذكاء الاصطناعي. التنفيذ بسيط (من 1 إلى 4 ساعات)، وغير مكلف، ويمكن أن يحقق فوائد كبيرة بمخاطر ضئيلة.
ماذا لو لم أكن أملك الموارد لإنشاء نسخ بصيغة .md لجميع المواقع؟
ركز على أهم 5 إلى 10 موارد. الجودة والأولوية أهم من الاكتمال. يمكنك الربط مباشرة إلى صفحات HTML، على الرغم من أن صيغة Markdown مفضلة.
المصطلحات
LLM (نموذج لغوي كبير) - نموذج لغوي كبير للذكاء الاصطناعي قادر على فهم النص وتوليد نصوص من مجموعات بيانات تدريبية ضخمة
Markdown - لغة ترميز خفيفة الوزن لتنسيق النص، تتميز بالبساطة والقراءة السهلة
نافذة السياق - الحد الأقصى لعدد الرموز (وحدات النص) التي يمكن لنموذج اللغة الكبير (LLM) معالجتها في استعلام واحد
GEO (تحسين محركات البحث التوليدية) - عملية تحسين المحتوى لزيادة فرص الظهور في الاستجابات التي يولدها الذكاء الاصطناعي
تحسين محركات الإجابة (AEO) - مرادفات تحسين المحركات التوليدية (GEO)؛ التحسين لمحركات استجابة الذكاء الاصطناعي
التحليل النحوي - عملية تحليل بنية البيانات بواسطة برنامج حاسوبي
وكيل المستخدم - معرف الروبوت أو المتصفح في رؤوس HTTP
Schema.org - قاموس البيانات المهيكلة الشائع لمواقع الويب
درجة ظهور العلامة التجارية - مقياس يقيس تكرار ذكر العلامة التجارية في استجابات الذكاء الاصطناعي
المصادر
llmstxt.org - المواصفة الرسمية للمعيار
answer.AI (جيري هاوارد) - اقتراح المعيار وتبريره
llmstxt.site - فهرس للمواقع التي طبقت بالفعل llms.txt أو خريطة full-llms.txt
r.jina.ai/https://semly.ai/ar - تحقق من كيفية رؤية البوتات الخاصة بالذكاء الاصطناعي لموقعك
بحث: تحسين المحركات التوليدية (GEO) - أبحاث أكاديمية (زيادة بنسبة 40% في الظهور)
أغاروال ب. وآخرون، "تحسين المحركات التوليدية (GEO): تحسين المحركات التوليدية (GEO)،" KDD '24، 2024 - بحث جديد وإطار عمل لتحسين ظهور المحتوى في ظل أنظمة الذكاء الاصطناعي التوليدي.
مشاركة:
