تم التحديث في 20 أكتوبر 2026.
لديك مئات إجابات الذكاء الاصطناعي لمراجعتها. تريد معرفة أيها يوصي بشركتك، وأيها يذكر الاسم فقط، وأيها يقدم معلومات خاطئة عن عرضك. عدد مرات ظهور العلامة وحده لا يوضح ذلك. تحتاج إلى طريقة تقييم قابلة للتكرار.
يمكن أن يؤدي Jev من TypeSafe AI دور نموذج التقييم في هذه العملية. يتلقى المادة وأسئلة محددة بدقة، ثم يعيد نتائج يستطيع البرنامج مقارنتها وعدها وإحالتها إلى العمل التالي. وفي GEO، قد يكون أداة مساعدة لتحليل إجابات الذكاء الاصطناعي التوليدي.
التحفظ الأهم: النموذج يقيّم ما تقدمه إليه فقط. النتيجة ليست دليلاً على مستوى معين من ظهور العلامة في الإنترنت كله. يشرح هذا الدليل استخدامات محتملة وكيفية التحقق منها، ولا يقدم اختباراً لـJev أو يؤكد تكامله مع Semly.
ما Jev وما علاقته بـGEO؟
تصف TypeSafe نموذج Jev بأنه من فئة System One، ومخصص لتقييمات سريعة ومحددة النطاق. بدلاً من كتابة مقال أو تحليل مطول، يعيد إجابة منظمة عن السؤال. الأساس هو السياق، المسمى «state» في API، ووصف ما يجب تقييمه. المصدر: مقدمة Jev.
يشمل GEO، أي Generative Engine Optimization، العمل على حضور العلامة والمحتوى في إجابات الذكاء الاصطناعي التوليدي. يمكن أن يساعد Jev في تنظيم المادة التي تستند إليها قراراتك. لكنه ليس مكاناً للحصول على ترتيب كما في محركات البحث، ولا يحل محل نظام يجمع إجابات ChatGPT أو Gemini أو Perplexity.
يمكن فصل الأدوار هكذا: عملية مستقلة تجمع الإجابات والمصادر، وJev يقيّم خصائص محددة، والبرنامج يطبق القواعد، والإنسان يراجع الحالات التي تحتاج إلى تفسير. وإذا احتجت لاحقاً إلى كتابة فقرة محسنة للصفحة، فهذه مهمة تحريرية أخرى.
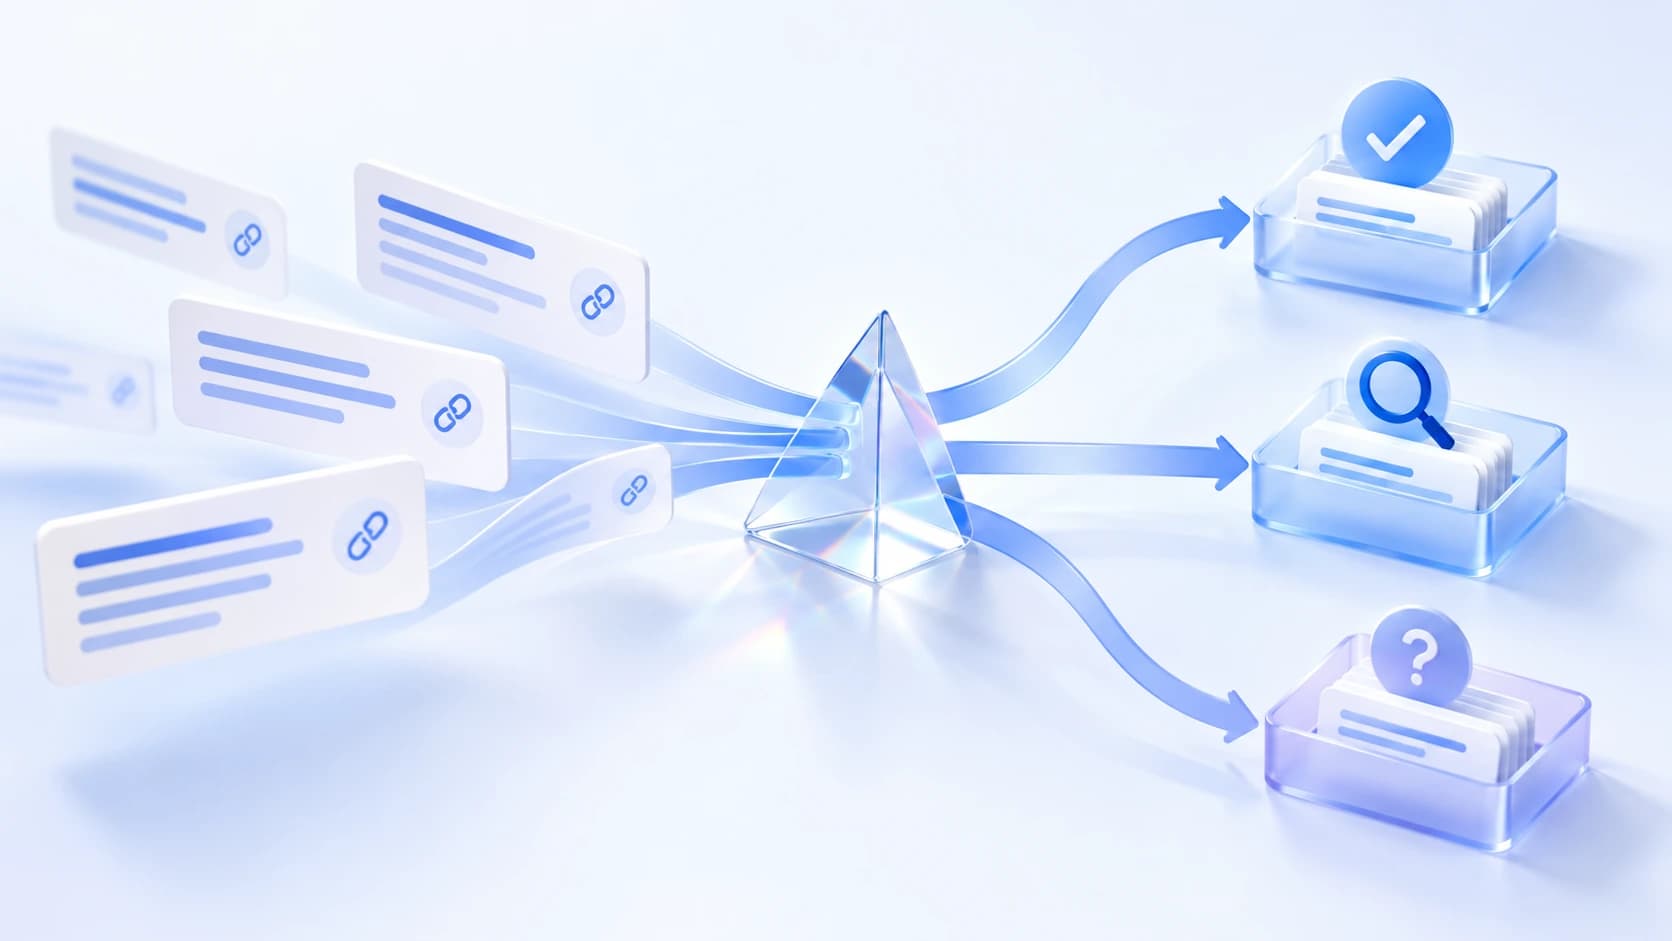
مخطط توضيحي: حفظ الإجابة، وأسئلة مستقلة، والتحقق من النتيجة. إعداد تحريري استناداً إلى وثائق TypeSafe. تعرض الحركة عملية مقترحة، لا تشغيل تكامل جاهز.
Choice وScore وNoul: ثلاث طرق لطرح الأسئلة
اختر نوع السؤال بحسب القرار الذي تريد اتخاذه فعلاً. سؤال «هل هذه إجابة جيدة؟» واسع جداً. يمكن تفكيكه إلى وجود توصية، وصحة الحقائق، واكتمال الاستجابة لاحتياج العميل.
| النوع | ما السؤال؟ | مثال في GEO |
|---|---|---|
| Choice | أي فئة من الفئات المحددة؟ | ذكر محايد أو توصية أو نصح بعدم الاختيار. |
| Score | أي مستوى من المقياس الموصوف؟ | لا إجابة، أو إجابة جزئية، أو جميع الشروط. |
| Noul | هل العبارة المحددة صحيحة؟ | هل توصي الإجابة بوضوح بالعلامة المحددة؟ |
يختار Choice فئة واحدة من مجموعة محددة. يجب أن تتميز الفئات عن بعضها، وأن تشمل المعايير الحالات الحدية. إذا قيّمت خصائص متعددة، مثل التوصية والتوافق مع العرض، فاطرح أسئلة منفصلة. وثائق Choice.
يتطلب Score وصف مستويات مرتبة. «لا يجيب»، و«يجيب جزئياً»، و«يجيب عن كل الشروط المحددة» أوضح من «الجودة من 1 إلى 10» بلا شرح للمقياس. تتعلق النتيجة بتعريفك أنت للجودة. وثائق Score.
يعيد Noul احتمال الإجابة «نعم». القيمة القريبة من 0.5 تعني عدم اليقين، لا تحقق الشرط جزئياً. يجب أن يحدد السؤال بوضوح معنى «نعم». وثائق Noul.
ما المعلومات الحالية في أكتوبر 2026؟
وفقاً للوثائق التي روجعت في 20 أكتوبر، أحدث إصدار موصوف هو Jev 1.14، المتاح منذ 14 أكتوبر 2026. تميز الوثائق بين معرفات الإصدارات والاسمين المتغيرين «latest» و«preview». عند الاختبار، سجل الإصدار الفعلي لأن تغيير الاسم المستعار قد يغير النتائج. نماذج Jev وإصداراته.
في إعلان الإصدار 1.14، تصف TypeSafe أيضاً دعماً تجريبياً للصور والسياق الأكبر والنوع «box». وتوضح الشركة أن جاهزية هذه الميزات للاستخدام الإنتاجي محدودة. لذلك لا تفترض عملية التقييم النصي هنا استخدامها. إعلان TypeSafe في 14 أكتوبر.
صحة تنسيق النتيجة لا تضمن صحة التقييم. قد يعيد النموذج فئة مسموحاً بها ويطبقها على الحالة الخطأ.
7 استخدامات لـJev في GEO وSEO
السيناريوهات التالية مقترحات لاستخدام النموذج، وليست قائمة بميزات Semly أو نتائج تطبيقات فعلية. يتطلب كل منها تحديد المعايير وفحص الدقة على مادة تلائم مهمتك.
1. التمييز بين الذكر والتوصية والنصح بعدم الاختيار
«العلامة X تعمل في هذا السوق» لا تعني «يجدر النظر في العلامة X لهذا الاستخدام». و«العلامة X لا تدعم هذا الاستخدام» لها معنى آخر. يظهر اسم الشركة في الحالات الثلاث، لكن واحدة فقط توصية ضمن السياق المذكور.
يمكن طلب تقييم موقف الإجابة من علامة محددة عبر Jev. أرفق سؤال المستخدم كاملاً، فالتوصية قد تكون مشروطة: ربما يناسب المنتج متجراً صغيراً لكنه لا يلبي متطلبات مؤسسة كبيرة.
سجل وجود الاسم والتوصية الإيجابية والرابط في حقول منفصلة. قد يصاحب رابط موقع الشركة توصية بالمنتج أو تقييماً نقدياً له.
البيانات التوضيحية تشرح الطريقة ولا تمثل نتائج أي علامة. التسميات في الحركة والأمثلة التالية أعدت تحريرياً، وليست ناتجة عن استدعاءات Jev. ونوضح المعلومة نفسها في النص: الذكر المحايد والتوصية والنصح بعدم الاختيار تقييمات مختلفة بصرف النظر عن وجود الرابط.
2. التقييم الأولي لتوافق الادعاء مع المصدر
غالباً ما يفضل اكتشاف عنوان URL بقواعد برمجية. أما السؤال الذي يتطلب حكماً فهو: هل يؤيد جزء محدد من المصدر جملة محددة في إجابة الذكاء الاصطناعي؟
قسّم الجملة التي تحمل وعوداً متعددة إلى ادعاءات منفردة. أرفق بكل منها المقتطف المناسب ونطاق العرض وتاريخ الاطلاع. إذا تعذر جلب المصدر، فسجل نقص المادة، ولا تحوله إلى حكم بأن «المصدر لا يؤيد الادعاء».
بحسب الأسئلة المصممة، قد يشير النموذج مبدئياً إلى توافق أو تناقض أو ضرورة المراجعة. نشرح التدقيق الكامل في دليل مستقل: هل تؤيد المصادر المستشهد بها المعلومات عن الشركة؟.
3. تنظيم أسئلة العملاء
أسئلة السعر والتنفيذ والقيود ومقارنة العروض تحتاج إلى إجابات مختلفة. يساعد التصنيف في إعداد قائمة التحليل وتوزيعها على المسؤولين.
حدد ما إذا كان للسؤال الواحد أكثر من قصد. «كم يكلف التنفيذ وهل يشمل الترحيل؟» يتعلق بالسعر والنطاق معاً. يمكنك تقسيمه إلى مهمتين أو تقييم البعدين منفصلين. إجباره على تصنيف واحد قد يخفي حاجة مهمة.
لا تستنتج حجم الطلب تلقائياً من عدد الأسئلة. فقد تأتي صيغ كثيرة متشابهة من المصدر نفسه وتخص احتياجاً واحداً.
4. فحص استجابة الصفحة لشروط السؤال
يسأل العميل عن حل لاستخدام معين، بتكامل محدد وحد أقصى للميزانية. تصف الصفحة المنتج لكنها لا توضح التوافق. يمكن للنموذج الإشارة مبدئياً إلى هذا النقص وفق مقياس الاكتمال المحدد.
قيّم كل شرط منفصلاً. غياب معلومات التكامل لا يعني أن المنتج لا يدعمه، بل أن المحتوى المقدم لا يحسم السؤال. الخطوة التالية هي التحقق من الحقيقة واستكمال الوصف إذا كانت المعلومة مفيدة للقارئ.
الدرجة المرتفعة في Score ليست نتيجة ترتيب في Google ولا احتمالاً للاستشهاد في ChatGPT. إنها تقييم مادة محددة بحسب معاييرك.
5. تحديد أزواج صفحات لفحص التنافس الداخلي
اختر أولاً أزواجاً مرشحة بناءً على الموضوع أو الاستعلامات أو تشابه المحتوى. ثم يمكن تقييم ما إذا كانت تجيب عن الاحتياج نفسه أم تساعد في قرارات مختلفة.
ينبغي أن يتلقى النموذج السؤال الأساسي والجمهور ومحتوى الصفحتين. تشابه كلمات العنوان لا يكفي. النتيجة قائمة للمراجعة التحريرية، وقرار الدمج يحتاج إلى مراعاة القيمة والزيارات ودور الصفحات في الموقع.
نشرح التقسيم العملي للموضوعات في دليل المدونة وقاعدة المعرفة دون تنافس داخلي.
6. تقييم فائدة رابط داخلي مقترح
اختر من الصفحات المرشحة ما يساعد القارئ في الخطوة التالية. قد يقود مقال اختيار الحل إلى تعليمات تجهيز البيانات إذا احتاجها القارئ بعد القرار.
يجب أن يسأل النموذج عن فائدة الرابط داخل فقرة محددة. التقارب الموضوعي وحده لا يكفي. يمكن للبرنامج التحقق من عمل URL، وللمحرر فحص طبيعية نص الرابط.
7. إحالة الوعود والمقارنات إلى المراجعة
قبل النشر، يمكن تحديد المقاطع التي تحتوي أسعاراً أو آجالاً أو ضمانات نتائج أو مقارنات بمنافسين. يساعد ذلك في إحالة النص إلى شخص يعرف العرض الحالي.
هذه مرحلة فحص وليست إثباتاً آلياً للصحة. لا يستطيع النموذج معرفة ما إذا كانت الشركة تشغل خدمة خلال يوم واحد بلا مصدر موثوق. وعند غياب المصدر يحتاج المقال إلى عمل تحريري.
كيف تصمم عملية قابلة للتحقق؟
ابدأ بمهمة واحدة، مثل اكتشاف التوصية بعلامة محددة. دوّن تعريف التوصية والحالات المستثناة وقواعد التعامل مع الإجابات الناقصة، ثم ابن الأتمتة.
احتفظ بالمادة الأصلية مع السؤال واسم منتج الذكاء الاصطناعي والوضع واللغة والتاريخ. قد يختلف تقييم جملة مقتطعة عن الإجابة الكاملة. يجب الفصل بين عدم وجود إجابة وخطأ الجلب وإجابة بلا علامة.
يمكن إرسال أسئلة مستقلة متعددة عن المادة نفسها في طلب واحد، ثم ربط نتائجها بقواعد البرنامج. وإذا احتاج سؤال تالٍ إلى بيانات لا تُجلب إلا بعد النتيجة الأولى، فستحتاج إلى مرحلة أخرى. مبادئ تصميم الأسئلة في TypeSafe.
المادة -> أسئلة منفصلة -> قواعد -> نتيجة أو مراجعة بشرية.
مصدر مفقود -> استكمال المادة. تقييم غير مؤكد -> تحقق. تغيير التعريف -> اختبار جديد.
احفظ التقييم وإصدار المعايير في التقرير. إذا تغير تعريف التوصية، فأعد حساب الفترات المقارنة بالقواعد نفسها أو وضح انقطاع قابلية المقارنة. وإلا فقد يبدو تحسن المصنف كأنه ارتفاع ظهور العلامة.
Confidence لا تعني ضماناً نسبياً للصحة
تصف الوثائق حقل «confidence» في Choice وScore بأنه محسوب من توزيع الاحتمالات. فهو يبين مدى حسم نتيجة النموذج، ولا ينبغي تفسير 0.9 تلقائياً كدقة مؤكدة قدرها 90% على إجاباتك. لا يعيد Noul حقل «confidence» منفصلاً. شرح TypeSafe لثقة الإجابة.
حدد عتبة الإحالة إلى المراجعة باختبار المهمة المعينة. قد تقبل مستوى لفرز قائمة العمل وتحتاج إلى مستوى آخر لاستخدام النتيجة في تقرير عميل. الثقة المرتفعة لا تلغي فحص الجودة.
لا تستبعد الحالات غير المؤكدة من القياس دون إظهار عددها. إذا عجز النموذج عن تقييم إجابات لغة معينة أكثر من غيرها، فقد يشوه تقرير الحالات السهلة فقط المقارنة.
كيف تختبر الدقة: مثال على 120 إجابة
في البيانات التوضيحية، قيّم محرر 120 إجابة. صنف النموذج 30 منها كتوصيات. وبمقارنتها بتقييم المحرر، صحت 24 وأخطأت 6، كما فوّت النموذج 8 توصيات أخرى.
| تقييم النموذج | توصية بحسب المحرر | لا توصية بحسب المحرر |
|---|---|---|
| توصية | 24 اكتشافاً صحيحاً | 6 إنذارات كاذبة |
| لا توصية | 8 توصيات فائتة | 82 تقييماً صحيحاً لغياب التوصية |
| المجموع | 32 إجابة | 88 إجابة |
دقة التوصيات هنا 24 / 30 = 80%، أي إن واحدة من كل خمس توصيات مكتشفة إنذار كاذب. والاسترجاع 24 / 32 = 75%، لأن التوصيات الفعلية بحسب المحرر مجموعها 32. فوّت النموذج ربعها.
الاتفاق الكلي 106 / 120، أي نحو 88.3%. تبدو النسبة أفضل لأن معظم الإجابات لم تتضمن توصية، لكنها وحدها لا تكفي للحكم على فائدة المصنف.
عملياً، جهز أمثلة لضبط المعايير ومجموعة مستقلة للفحص النهائي. أضف النفي والتوصيات المشروطة وأسماء الشركات المتشابهة والمصادر الناقصة. دع شخصين يقيّمان بعض المواد. قد تكشف الخلافات غموض التعريف قبل تقييم النموذج.
العدد 120 لتوضيح الحساب وليس معياراً للتحقق. حجم العينة ومستوى الخطأ المقبول يتوقفان على الهدف. اختبر المادة البولندية باللغة البولندية: تشير TypeSafe إلى أن الإنجليزية تحقق حالياً أفضل دقة لديها. دعم اللغات في الوثائق.
ما تكلفة Jev وما تكلفة عملية GEO كاملة؟
في التسعير الذي روجع في 20 أكتوبر 2026، السعر 0.042 دولار أمريكي لكل مليون رمز إدخال. الرمز وحدة نصية تستخدمها API للفوترة. ورموز الإخراج مجانية بحسب الوثائق. هذا سعر الشركة وقت المراجعة، لا ضمان لسعر مستقبلي. التسعير في وثائق النماذج.
في البيانات التوضيحية، تريد تقييم 2000 إجابة بمتوسط 1200 رمز إدخال للطلب شاملاً السياق والأسئلة. الحساب: 2000 × 1200 = 2,400,000 رمز؛ و2.4 × 0.042 دولار = 0.1008 دولار، أي نحو 0.10 دولار لهذا الجزء.
هذا حساب لحجم إدخال مفترض، لا قياس لاستدعاءات منفذة. مرور كامل ثانٍ بالحجم نفسه يضاعف التكلفة إلى نحو 0.20 دولار. والسياق الأطول وإعادة المحاولات يزيدان الاستهلاك أيضاً.
| جزء العملية | هل يشمله مبلغ 0.10 دولار؟ | ما الذي يُراعى؟ |
|---|---|---|
| التقييم في Jev | نعم، وفق افتراضات المثال | العدد الفعلي لرموز الإدخال. |
| الحصول على إجابات AI | لا | API أو خدمة جمع الإجابات أو العمل اليدوي. |
| جلب المصادر وحفظها | لا | الوصول إلى الصفحات واستخراج المحتوى وتخزينه. |
| فحص الجودة | لا | وسم العينة والخلافات والمراجعة البشرية. |
| إعداد تغييرات المحتوى | لا | التحرير والتحقق من الحقائق والتنفيذ. |
لذلك لا يعني التصنيف الرخيص مراقبة GEO كاملة ببضعة سنتات. قارن تكلفة المسار كله وتكلفة الحصول على نتيجة صحيحة ومفيدة. وقد يفقد السعر المنخفض للتقييم أهميته إذا احتاج كل تقييم إلى تصحيح يدوي.
ما الذي لا تثبته اختبارات الشركة؟
تصف صفحة التقييم العامة لـTypeSafe أربع عمليات أتمتة، وتقارن النماذج بتسميات مرجعية حددتها نماذج أخرى. هذه مقارنة في إعداد اختباري معين، وليست تقييماً مستقلاً لدقة Jev في GEO باللغة البولندية. منهجية تقييم TypeSafe.
لا تنقل رقماً واحداً من هذه الرسوم إلى توصيات العلامات أو كشف التنافس الداخلي أو تطابق الاستشهادات. ولا يثبت أن استخدام Jev سيزيد توصيات الشركة؛ فهذا يحتاج إلى تقييم مستقل لتغير الظهور وظروف قياسه.
هل يساعد Jev في الحصول على استشهادات في Google وChatGPT؟
قد يساعد في العثور على نواقص المحتوى أو تنظيم تقييم الإجابات. لكن تشغيله وحده لا يجعل محرك بحث خارجياً يقرأ الصفحة ويعدّها ذات قيمة ويستشهد بها.
توضح Google أن أساسيات SEO تنطبق على الظهور كمصدر في AI Overviews وAI Mode. يجب فهرسة الصفحة وتأهلها للعرض مع مقتطف نصي. استيفاء الشروط لا يضمن الظهور. وهذه إرشادات لميزات Google، وليست مواصفة مشتركة لكل المساعدين. Google Search Central: ميزات الذكاء الاصطناعي وموقعك.
استخدم التقييم لتحسين الإجابة للقارئ: استكمال الشروط وشرح القيود وإضافة مصدر أو التمييز بين أدلة متشابهة. توصي Google بمحتوى مفيد يركز على الجمهور. وتشمل سياسات المحتوى غير المرغوب فيه المحتوى واسع النطاق المنشأ أساساً للتلاعب بالنتائج. المحتوى المفيد وسياسات المحتوى غير المرغوب فيه.
من أين تبدأ في شركتك؟
حدد أولاً السؤال التجاري المطلوب: هل يوصي الذكاء الاصطناعي بالعلامة؟ هل يصف العرض بدقة؟ هل تؤيد المصادر ادعاءات معينة؟ لكل مهمة معايير مختلفة.
إذا كنت في البداية، افحص حضور الشركة واقرأ الإجابات كاملة. وبعد تحديد ما تريد تقييمه، جهز عينة موسومة يدوياً. يستحق Jev الاختبار عندما تتكرر المهمة وتستطيع شرح كيفية التعرف على النتيجة الصحيحة.
أسئلة شائعة عن Jev وGEO
هل يكتب Jev مقالاً مناسباً لـGEO؟
Jev مخصص للتقييمات المنظمة، لا لكتابة مقالات حرة. في العملية المقترحة، يمكنه تقييم خاصية محددة للنص. ويظل إعداد المحتوى وتحريره مهمة مستقلة.
هل يفحص Jev ما يقوله ChatGPT بنفسه؟
في العملية الموضحة، تقدم أنت الإجابة والسياق اللازم. جمع الإجابات وحفظ المصادر وتوثيق ظروف القياس يحتاج إلى معالجة مستقلة.
هل يمكن تحسين ترتيب الشركة في Jev؟
Jev ليس محرك بحث يعرض للعملاء ترتيب الشركات في هذا المقال. يمكن أن يدعم تحليل المواد المستخدمة في العمل على الظهور.
هل الثقة المرتفعة تسمح بتجاوز الإنسان؟
يعتمد القرار على الدقة المثبتة في مهمتك وعواقب الخطأ. ثقة النموذج ليست إثباتاً مستقلاً للصحة. احتفظ بمسار للمراجعة وافحص دورياً النتائج المقبولة آلياً أيضاً.
هل تستخدم Semly نموذج Jev؟
لا يؤكد هذا المقال تطبيق Jev في Semly. يعرض استخدامات محتملة لتحليل GEO وSEO مع القيود واختبار مقترح.
روجعت الوثائق والمصادر في 20 أكتوبر 2026. وصف الميزات والأسعار مستمد من مواد TypeSafe. السيناريوهات والمخططات والبيانات التوضيحية إعداد تحريري، ولا تمثل نتائج علامات Semly أو عملائها.