

Prüfe, ob KI dein Unternehmen sieht
Erhalte ein kostenloses Audit
Aktualisiert am 20. Oktober 2026.
Du hast mehrere Hundert KI-Antworten zu prüfen. Du möchtest feststellen, welche dein Unternehmen empfehlen, welche nur den Namen erwähnen und welche falsche Informationen über dein Angebot enthalten. Ein Zähler für Markennennungen erklärt das nicht. Du brauchst eine wiederholbare Bewertungsmethode.
Jev von TypeSafe AI kann dabei als Bewertungsmodell dienen. Es erhält Material und genau definierte Fragen und liefert Ergebnisse, die ein Programm vergleichen, zählen und zur weiteren Bearbeitung zuweisen kann. Im GEO kann das eine nützliche Grundlage für die Analyse generativer KI-Antworten sein.
Die wichtigste Einschränkung: Das Modell bewertet das, was du ihm übergibst. Das Ergebnis beweist keine bestimmte Sichtbarkeit der Marke im gesamten Internet. Dieser Leitfaden beschreibt mögliche Anwendungen und deren Überprüfung. Er enthält weder einen Jev-Test noch die Bestätigung einer Integration mit Semly.
Was ist Jev und was hat es mit GEO zu tun?
TypeSafe beschreibt Jev als System-One-Modell für schnelle, eng abgegrenzte Bewertungen. Statt einen Artikel oder eine ausführliche Analyse zu schreiben, liefert es eine strukturierte Antwort auf eine bestimmte Frage. Grundlage sind der Kontext, in der API „state“ genannt, und eine Beschreibung dessen, was bewertet werden soll. Quelle: Einführung in Jev.
GEO, Generative Engine Optimization, umfasst die Arbeit an der Präsenz von Marken und Inhalten in generativen KI-Antworten. Jev kann helfen, das Material für deine Entscheidungen zu ordnen. Es ist kein Ort, an dem du wie in einer Suchmaschine eine Position erreichst. Es ersetzt auch kein System, das Antworten von ChatGPT, Gemini oder Perplexity sammelt.
Eine sinnvolle Aufgabenverteilung: Ein eigener Prozess sammelt Antworten und Quellen, Jev bewertet bestimmte Merkmale, ein Programm wendet Regeln an und ein Mensch prüft Fälle, die Interpretation erfordern. Muss später ein Seitenabschnitt umgeschrieben werden, ist das eine weitere redaktionelle Aufgabe.
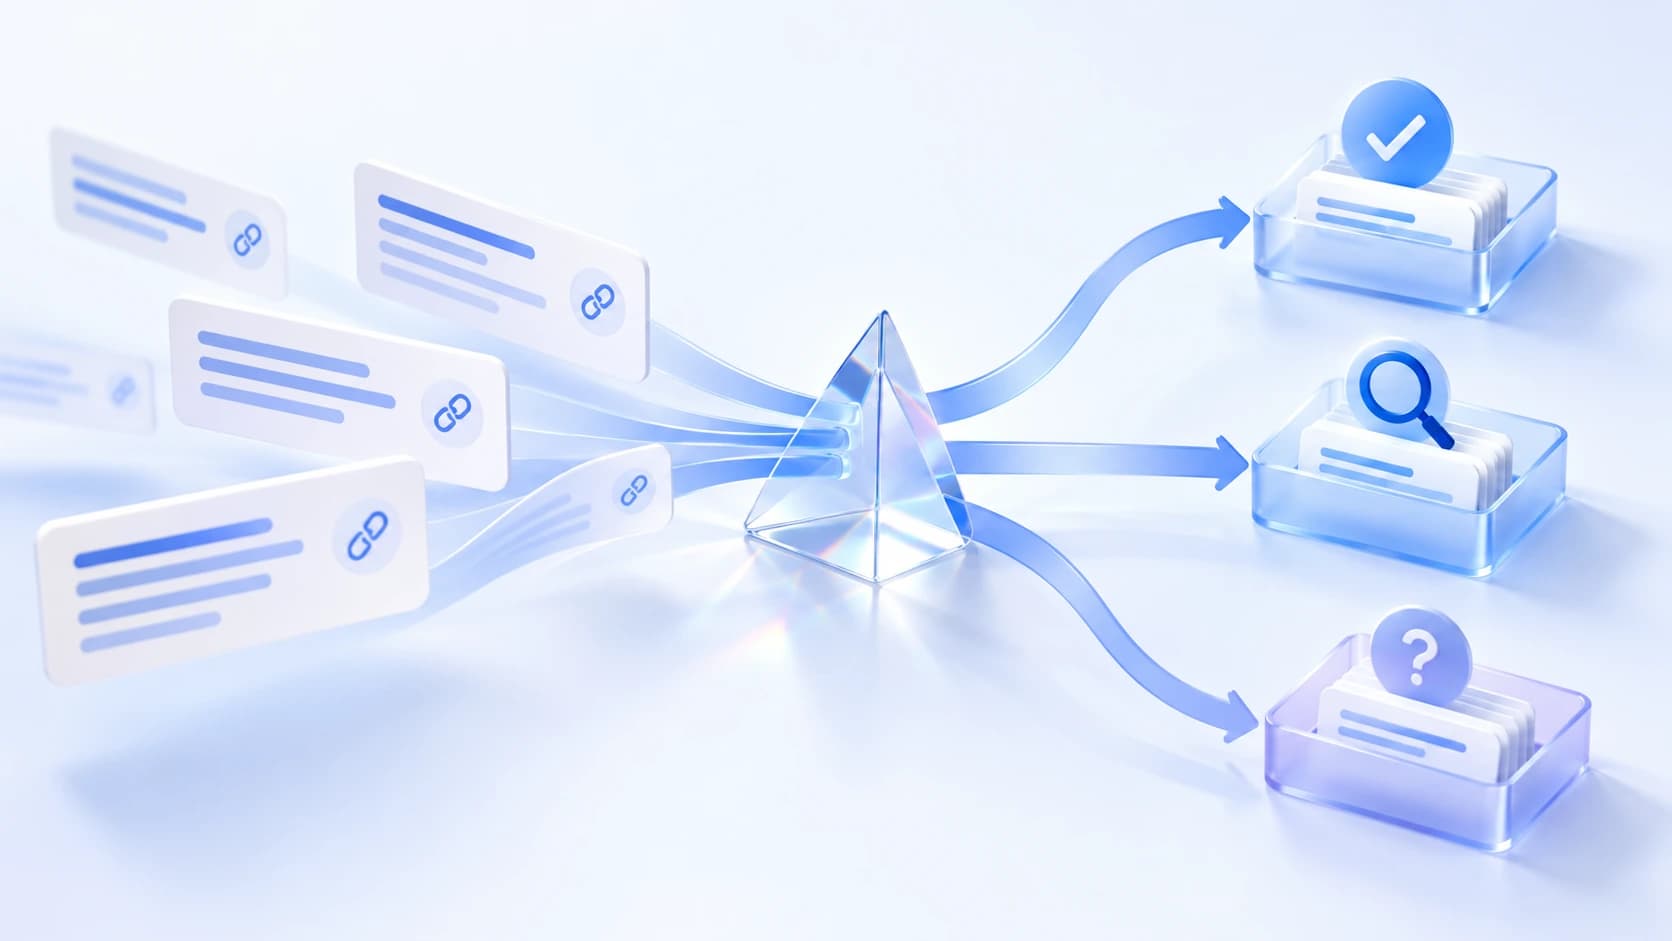
Veranschaulichendes Schema: Antworten speichern, unabhängige Fragen stellen und Ergebnisse prüfen. Eigene redaktionelle Darstellung auf Grundlage der TypeSafe-Dokumentation. Die Animation zeigt einen vorgeschlagenen Prozess, keine fertige Integration.
Choice, Score und Noul: drei Arten, Fragen zu stellen
Wähle den Fragetyp passend zu der Entscheidung, die du tatsächlich treffen möchtest. „Ist diese Antwort gut?“ ist zu allgemein. Die Frage lässt sich in Empfehlung, sachliche Richtigkeit und Vollständigkeit in Bezug auf das Kundenbedürfnis aufteilen.
| Typ | Welche Frage? | Beispiel im GEO |
|---|---|---|
| Choice | Welche beschriebene Kategorie? | Neutrale Erwähnung, Empfehlung oder Abraten. |
| Score | Welche Stufe der beschriebenen Skala? | Keine Antwort, Teilantwort oder alle Bedingungen abgedeckt. |
| Noul | Ist die genannte Aussage wahr? | Empfiehlt die Antwort ausdrücklich die angegebene Marke? |
Choice wählt eine Kategorie aus einer vorgegebenen Menge. Die Kategorien sollten sich unterscheiden; die Kriterien sollten Grenzfälle abdecken. Wenn du mehrere Merkmale bewertest, etwa Empfehlung und Übereinstimmung mit dem Angebot, stelle getrennte Fragen. Choice-Dokumentation.
Score erfordert eine Beschreibung geordneter Stufen. „Beantwortet die Frage nicht“, „beantwortet sie teilweise“ und „beantwortet alle genannten Bedingungen“ sind klarere Kriterien als „Qualität 1-10“ ohne Erklärung der Skala. Das Ergebnis bezieht sich auf deine Qualitätsdefinition. Score-Dokumentation.
Noul liefert die Wahrscheinlichkeit einer Ja-Antwort. Ein Wert nahe 0,5 signalisiert Unsicherheit und keine teilweise Erfüllung einer Bedingung. Die Frage muss klar festlegen, was „ja“ bedeutet. Noul-Dokumentation.
Was ist im Oktober 2026 aktuell?
Laut der am 20. Oktober geprüften Dokumentation ist Jev 1.14 die neueste beschriebene Version, verfügbar seit dem 14. Oktober 2026. Die Dokumentation unterscheidet Versionskennungen von den wechselnden Aliasnamen „latest“ und „preview“. Halte bei Tests die tatsächliche Modellversion fest, da eine Änderung hinter einem Alias die Ergebnisse verändern kann. Jev-Modelle und Versionen.
In der Ankündigung zu Version 1.14 beschreibt TypeSafe außerdem experimentelle Unterstützung für Bilder, größeren Kontext und den Typ „box“. Der Hersteller weist auf die eingeschränkte Produktionsreife dieser Funktionen hin. Der hier beschriebene Prozess zur Textbewertung setzt sie deshalb nicht voraus. TypeSafe-Mitteilung vom 14. Oktober.
Ein korrektes Ergebnisformat garantiert keine korrekte Bewertung. Das Modell kann eine zulässige Kategorie ausgeben und sie dem falschen Fall zuordnen.
7 Anwendungen von Jev in GEO und SEO
Die folgenden Szenarien sind Anwendungsvorschläge für das Modell, keine Liste von Semly-Funktionen oder Umsetzungsergebnissen. Jedes erfordert definierte Kriterien und eine Genauigkeitsprüfung anhand von Material, das zu deiner Aufgabe passt.
1. Erwähnung, Empfehlung und Abraten unterscheiden
„Marke X ist auf diesem Markt tätig“ bedeutet nicht dasselbe wie „Für diesen Anwendungsfall lohnt es sich, Marke X zu berücksichtigen“. „Marke X unterstützt diesen Anwendungsfall nicht“ hat wiederum eine andere Bedeutung. Alle Sätze nennen das Unternehmen, aber nur einer empfiehlt es im beschriebenen Kontext.
Du kannst Jev bitten, die Haltung einer Antwort gegenüber einer bestimmten Marke zu bewerten. Füge die vollständige Nutzerfrage zum Kontext hinzu. Empfehlungen können an Bedingungen geknüpft sein: Ein Produkt kann für einen kleinen Shop passen, aber die Anforderungen eines großen Unternehmens nicht erfüllen.
Erfasse die Namensnennung, eine positive Empfehlung und einen Link getrennt. Ein Link zur Herstellerseite kann sowohl eine Empfehlung als auch eine kritische Produktbewertung begleiten.
Die Beispieldaten erläutern die Methode und stellen keine Ergebnisse einer Marke dar. Die Kennzeichnungen in der Animation und den weiteren Beispielen wurden redaktionell erstellt und stammen nicht aus Jev-Aufrufen. Dieselbe Aussage gilt im Text: Neutrale Erwähnung, Empfehlung und Abraten sind unterschiedliche Bewertungen, unabhängig davon, ob ein Link vorhanden ist.
2. Vorprüfung, ob eine Quelle eine Behauptung stützt
Das Erkennen einer URL lässt sich meist sinnvoll mit Programmregeln lösen. Die Bewertungsfrage lautet: Stützt ein bestimmter Quellenausschnitt einen bestimmten Satz der KI-Antwort?
Zerlege einen Satz mit mehreren Versprechen in einzelne Behauptungen. Ergänze jeweils den passenden Seitenausschnitt, den Angebotsumfang und das Abrufdatum. Falls die Quelle nicht abgerufen werden konnte, kennzeichne fehlendes Material. Mache daraus nicht die Bewertung „Quelle bestätigt die Aussage nicht“.
Je nach den entworfenen Fragen kann das Modell vorläufig Übereinstimmung, Widerspruch oder Prüfbedarf anzeigen. Das vollständige Auditverfahren beschreiben wir separat: Bestätigen zitierte Quellen die Angaben über ein Unternehmen?.
3. Kundenfragen ordnen
Fragen nach Preis, Einführung, Einschränkungen und Angebotsvergleichen benötigen unterschiedliche Antworten. Eine Klassifizierung hilft, die Analyseliste zu ordnen und Fragen den zuständigen Personen zuzuweisen.
Lege fest, ob eine Frage mehrere Absichten haben kann. „Was kostet die Einführung und umfasst sie die Migration?“ betrifft Preis und Umfang zugleich. Du kannst daraus zwei Aufgaben machen oder beide Dimensionen separat bewerten. Eine erzwungene einzelne Zuordnung kann ein wichtiges Bedürfnis verdecken.
Leite aus der Anzahl der Fragen nicht automatisch die Nachfragegröße ab. Viele ähnliche Formulierungen können aus derselben Quelle stammen und ein einziges Bedürfnis betreffen.
4. Prüfen, ob eine Seite die Bedingungen der Frage beantwortet
Ein Kunde sucht eine Lösung für einen bestimmten Einsatz, mit einer konkreten Integration und einer Budgetgrenze. Die Seite beschreibt das Produkt, erklärt aber nicht dessen Kompatibilität. Das Modell kann diese Lücke anhand einer definierten Vollständigkeitsskala vorläufig markieren.
Bewerte jede Bedingung einzeln. Fehlende Angaben zu einer Integration bedeuten nicht, dass das Produkt sie nicht unterstützt. Sie bedeuten, dass der bereitgestellte Inhalt die Frage nicht klärt. Als Nächstes muss der Sachverhalt geprüft und die Beschreibung ergänzt werden, wenn die Information dem Leser hilft.
Ein hoher Score ist weder ein Google-Rankingwert noch die Wahrscheinlichkeit einer Zitierung durch ChatGPT. Er bewertet bestimmtes Material nach deinen Kriterien.
5. Seitenpaare zur Prüfung auf Kannibalisierung auswählen
Wähle zunächst mögliche Paare anhand von Themen, Suchanfragen oder Inhaltsähnlichkeit. Anschließend lässt sich bewerten, ob sie dasselbe Bedürfnis beantworten oder bei verschiedenen Entscheidungen helfen.
Das Modell sollte die Hauptfrage, Zielgruppe und Inhalte beider Seiten erhalten. Ähnliche Titelwörter reichen nicht aus. Das Ergebnis soll eine Liste zur redaktionellen Prüfung erstellen. Eine Zusammenlegung erfordert die Berücksichtigung von Wert, Traffic und Rolle der Seiten auf der Website.
Eine praktische Themenaufteilung beschreiben wir im Leitfaden Blog und Wissensdatenbank ohne Kannibalisierung.
6. Den Nutzen eines vorgeschlagenen internen Links bewerten
Wähle unter den Linkkandidaten diejenigen aus, die beim nächsten Schritt helfen. Ein Artikel zur Auswahl einer Lösung kann auf eine Anleitung zur Datenvorbereitung verweisen, wenn der Leser sie nach der Entscheidung benötigt.
Die Modellfrage sollte den Nutzen der Verbindung in einem bestimmten Absatz betreffen. Thematische Nähe allein reicht nicht aus. Das Programm kann separat prüfen, ob die URL funktioniert; die Redaktion prüft, ob der Linktext natürlich klingt.
7. Versprechen und Vergleiche zur Prüfung weiterleiten
Vor der Veröffentlichung lassen sich Abschnitte mit Preisen, Fristen, Erfolgsgarantien oder Wettbewerbsvergleichen markieren. Diese Erkennung hilft, den Text einer Person zuzuweisen, die das aktuelle Angebot kennt.
Das ist ein Prüfschritt, keine automatische Bestätigung der Wahrheit. Ohne zuverlässige Quelle kann das Modell nicht feststellen, ob ein Unternehmen einen Dienst tatsächlich an einem Tag einführt. Fehlt die Quelle, ist redaktionelle Arbeit nötig.
Wie entwirfst du einen überprüfbaren Prozess?
Beginne mit einer Aufgabe, etwa dem Erkennen von Empfehlungen einer bestimmten Marke. Notiere die Definition einer Empfehlung, ausgeschlossene Fälle und Regeln für unvollständige Antworten. Baue erst danach die Automatisierung.
Bewahre das Ausgangsmaterial mit Frage, Name des KI-Produkts, Modus, Sprache und Datum auf. Ein isolierter Satz kann anders bewertet werden als die gesamte Antwort. Keine Antwort, Abruffehler und eine Antwort ohne Markennennung sollten eigene Kennzeichnungen erhalten.
Mehrere unabhängige Fragen zum selben Material lassen sich in einer Anfrage senden. Verknüpfe ihre Ergebnisse mit Programmregeln. Benötigt eine spätere Frage Daten, die erst nach dem ersten Ergebnis abgerufen werden, ist ein weiterer Schritt erforderlich. TypeSafe-Grundsätze für die Fragengestaltung.
Material -> getrennte Fragen -> Regeln -> Ergebnis oder menschliche Prüfung.
Fehlende Quelle -> Material ergänzen. Unsichere Bewertung -> überprüfen. Geänderte Definition -> erneut testen.
Speichere im Bericht sowohl die Bewertung als auch die Version der Kriterien. Wenn du die Empfehlungsdefinition änderst, berechne die verglichenen Zeiträume nach denselben Regeln neu oder kennzeichne einen Bruch der Vergleichbarkeit. Sonst kann ein verbesserter Klassifikator wie erhöhte Markensichtbarkeit aussehen.
Confidence ist keine prozentuale Richtigkeitsgarantie
Für Choice und Score beschreibt die Dokumentation das Feld „confidence“, das aus der Wahrscheinlichkeitsverteilung berechnet wird. Es zeigt, wie eindeutig das Modellergebnis ist. Interpretiere 0,9 nicht automatisch als bestätigte 90-prozentige Genauigkeit bei deinen KI-Antworten. Noul liefert kein separates „confidence“-Feld. So beschreibt TypeSafe die Ergebnissicherheit.
Wähle den Schwellenwert für die Prüfung anhand eines Tests der konkreten Aufgabe. Für die Sortierung einer Warteschlange kann ein anderes Sicherheitsniveau genügen als für einen Kundenbericht. Hohe Sicherheit ersetzt keine Qualitätskontrolle.
Entferne unsichere Fälle nicht aus der Messung, ohne ihre Anzahl zu zeigen. Hat das Modell bei einer Sprache häufiger Bewertungsprobleme, kann ein Bericht mit ausschließlich einfachen Fällen den Vergleich verzerren.
Wie prüfst du die Genauigkeit? Ein Beispiel mit 120 Antworten
In den Beispieldaten bewertete ein Redakteur 120 Antworten. Das Modell markierte 30 als Empfehlungen. Der Vergleich mit der redaktionellen Bewertung ergab 24 richtige und 6 falsche Markierungen. Zusätzlich übersah das Modell 8 Empfehlungen.
| Modellbewertung | Empfehlung laut Redaktion | Keine Empfehlung laut Redaktion |
|---|---|---|
| Empfehlung | 24 richtige Erkennungen | 6 Fehlalarme |
| Keine Empfehlung | 8 übersehene Empfehlungen | 82 richtige Bewertungen ohne Empfehlung |
| Gesamt | 32 Antworten | 88 Antworten |
Die Präzision der Empfehlungserkennung beträgt hier 24 / 30 = 80 %. Jede fünfte erkannte Empfehlung ist also ein Fehlalarm. Die Sensitivität beträgt 24 / 32 = 75 %, da es laut Redaktion insgesamt 32 tatsächliche Empfehlungen gibt. Das Modell übersah ein Viertel davon.
Die Gesamtübereinstimmung beträgt 106 / 120, also rund 88,3 %. Diese Zahl sieht besser aus, weil die meisten Antworten keine Empfehlung enthielten. Allein genügt sie nicht zur Bewertung des praktischen Nutzens des Klassifikators.
Bereite in der Praxis getrennte Beispiele zur Verfeinerung der Kriterien und einen separaten Datensatz für die abschließende Prüfung vor. Ergänze Verneinungen, bedingte Empfehlungen, ähnliche Firmennamen und unvollständige Quellen. Lass einen Teil des Materials von zwei Personen bewerten. Abweichungen können eine unklare Definition aufdecken, bevor du das Modell prüfst.
Die Zahl 120 dient zur Veranschaulichung der Berechnungen und ist kein Validierungsstandard. Stichprobengröße und tolerierbare Fehlerquote hängen vom Ziel ab. Prüfe polnisches Material auf Polnisch: TypeSafe nennt Englisch als die Sprache, in der es derzeit die höchste Genauigkeit erreicht. Sprachunterstützung in der Dokumentation.
Was kostet Jev und was kostet der gesamte GEO-Prozess?
Die am 20. Oktober 2026 geprüfte Modellpreisliste nennt 0,042 USD pro Million Eingabetoken. Ein Token ist eine Texteinheit, die über die API abgerechnet wird. Ausgabetoken sind laut Dokumentation kostenlos. Das ist der Herstellerpreis am Prüftag, keine Garantie für künftige Preise. Preise in der Modelldokumentation.
In den Beispieldaten möchtest du 2000 Antworten bewerten; jede Anfrage umfasst durchschnittlich 1200 Eingabetoken einschließlich Kontext und Fragen. Die Rechnung: 2000 × 1200 = 2 400 000 Token; 2,4 × 0,042 USD = 0,1008 USD, also rund 0,10 USD für diesen Teil der Arbeit.
Diese Berechnung beruht auf einer angenommenen Eingabegröße, nicht auf gemessenen Aufrufen. Ein zweiter vollständiger Durchlauf derselben Größe würde den Preis auf rund 0,20 USD verdoppeln. Längerer Kontext und Wiederholungen erhöhen den Verbrauch ebenfalls.
| Prozesselement | In den genannten 0,10 USD enthalten? | Was ist zu berücksichtigen? |
|---|---|---|
| Bewertung in Jev | Ja, nach den Beispielannahmen | Tatsächliche Zahl der Eingabetoken. |
| KI-Antworten beschaffen | Nein | API, Antwortsammlung als Dienst oder manuelle Arbeit. |
| Quellen abrufen und speichern | Nein | Seitenzugriff, Inhaltsextraktion und Speicherung. |
| Qualität prüfen | Nein | Stichprobe kennzeichnen, Abweichungen und menschliche Prüfung. |
| Inhaltsänderungen vorbereiten | Nein | Redaktion, Faktenprüfung und Umsetzung. |
Günstige Klassifizierung bedeutet deshalb kein GEO-Monitoring für wenige Cent. Vergleiche die Kosten des gesamten Durchlaufs und die Kosten eines korrekten, nützlichen Ergebnisses. Ein niedriger Preis pro Bewertung kann bedeutungslos werden, wenn anschließend jede manuell korrigiert werden muss.
Was beweisen Hersteller-Benchmarks nicht?
Die öffentliche Evaluationsseite von TypeSafe beschreibt vier Automatisierungsprozesse. Modelle werden anhand von Referenzkennzeichnungen bewertet, die andere Modelle festgelegt haben. Das ist ein Vergleich in einem bestimmten Testaufbau, keine unabhängige Bewertung der Genauigkeit von Jev im polnischen GEO. Evaluationsmethodik von TypeSafe.
Übertrage keine einzelne Diagrammzahl auf Markenempfehlungen, Kannibalisierungserkennung oder Quellenrichtigkeit. Sie beweist auch nicht, dass Jev zu mehr Unternehmensempfehlungen führt. Dieser Schluss würde eine separate Bewertung der Sichtbarkeitsänderungen und ihrer Messbedingungen erfordern.
Hilft Jev dabei, in Google und ChatGPT zitiert zu werden?
Es kann helfen, Inhaltslücken zu erkennen oder die Antwortbewertung zu ordnen. Allein der Modellaufruf veranlasst jedoch keine externe Suchmaschine, eine Seite zu lesen, sie als wertvoll einzustufen und in einer Antwort anzuführen.
Google erklärt, dass für die Präsenz als Quelle in AI Overviews und AI Mode die SEO-Grundlagen gelten. Eine Seite muss indexiert und für die Anzeige mit einem Textausschnitt berechtigt sein. Das Erfüllen der Anforderungen garantiert keine Aufnahme. Dies sind Vorgaben für Google-Funktionen, keine gemeinsame Spezifikation aller Assistenten. Google Search Central: KI-Funktionen und deine Website.
Nutze die Bewertung, um die Antwort für den Leser zu verbessern: Bedingungen ergänzen, Einschränkungen erklären, eine Quelle hinzufügen oder ähnliche Leitfäden unterscheiden. Google empfiehlt hilfreiche, für Menschen erstellte Inhalte. Seine Spamrichtlinien erfassen massenhaft erstellte Inhalte, deren Hauptzweck die Manipulation der Ergebnisse ist. Hilfreiche Inhalte und Spamrichtlinien.
Womit solltest du im Unternehmen beginnen?
Kläre zuerst die geschäftliche Frage. Möchtest du wissen, ob KI deine Marke empfiehlt? Ob sie das Angebot sachlich richtig beschreibt? Ob Quellen einzelne Behauptungen stützen? Jede Aufgabe braucht andere Kriterien.
Wenn du am Anfang stehst, prüfe die Unternehmenspräsenz und lies die Antworten vollständig. Wenn klar ist, was du bewerten möchtest, erstelle eine manuell gekennzeichnete Stichprobe. Jev lohnt sich als Test, wenn die Aufgabe wiederholbar ist und du erklären kannst, woran du ein korrektes Ergebnis erkennst.
Häufige Fragen zu Jev und GEO
Schreibt Jev einen GEO-Artikel?
Jev dient strukturierten Bewertungen, nicht dem freien Schreiben von Artikeln. Im vorgeschlagenen Prozess kann es ein bestimmtes Textmerkmal bewerten. Erstellung und Redaktion der Inhalte bleiben eigene Aufgaben.
Prüft Jev selbst, was ChatGPT sagt?
Im beschriebenen Prozess lieferst du die Antwort und den erforderlichen Kontext. Antwortsammlung, Quellenaufbewahrung und Dokumentation der Messbedingungen benötigen eigene Abläufe.
Kann ein Unternehmen in Jev ranken?
Jev wird hier nicht als Suchmaschine beschrieben, die Kunden Unternehmensrankings zeigt. Es kann die Analyse des Materials unterstützen, das bei der Arbeit an der Sichtbarkeit verwendet wird.
Kann man bei hoher Sicherheit den Menschen weglassen?
Die Entscheidung hängt von der für deine Aufgabe geprüften Genauigkeit und den Fehlerfolgen ab. Die Sicherheit des Modells bestätigt nicht eigenständig die Richtigkeit. Behalte einen Prüfpfad bei und kontrolliere regelmäßig auch automatisch akzeptierte Ergebnisse.
Nutzt Semly Jev?
Dieser Artikel bestätigt keinen Einsatz von Jev in Semly. Er beschreibt mögliche Anwendungen in der GEO- und SEO-Analyse mit Einschränkungen und einem Testvorschlag.
Dokumentation und Quellen wurden am 20. Oktober 2026 geprüft. Funktions- und Preisangaben stammen aus TypeSafe-Materialien. Szenarien, Schemata und Beispieldaten sind redaktionelle Ausarbeitungen und stellen keine Ergebnisse von Semly-Marken oder -Kunden dar.
Teilen:
