

Vérifiez si l'IA voit votre entreprise
Obtenez un audit gratuit
Mis à jour le 20 octobre 2026.
Vous avez plusieurs centaines de réponses d'IA à examiner. Vous voulez savoir lesquelles recommandent votre entreprise, lesquelles citent seulement son nom et lesquelles donnent des informations erronées sur votre offre. Un simple compteur de mentions ne suffit pas. Il vous faut une méthode d'évaluation reproductible.
Jev, de TypeSafe AI, peut servir de modèle d'évaluation dans ce processus. Il reçoit un contenu et des questions précisément définies, puis renvoie des résultats qu'un programme peut comparer, compter et orienter vers les étapes suivantes. En GEO, il constitue ainsi un outil d'analyse potentiellement utile pour les réponses d'IA générative.
La réserve essentielle : le modèle évalue ce que vous lui fournissez. Son résultat ne prouve pas qu'une marque possède un niveau donné de visibilité sur l'ensemble d'Internet. Ce guide décrit des usages possibles et leur vérification. Il ne présente ni un test de Jev ni une intégration confirmée avec Semly.
Qu'est-ce que Jev et quel rapport avec le GEO ?
TypeSafe décrit Jev comme un modèle System One destiné à des évaluations rapides et ciblées. Au lieu de rédiger un article ou une longue analyse, il renvoie une réponse structurée à une question précise. Il s'appuie sur un contexte, appelé « state » dans l'API, et sur une description de ce qu'il faut évaluer. Source : présentation de Jev.
Le GEO, Generative Engine Optimization, consiste à travailler la présence des marques et des contenus dans les réponses d'IA générative. Jev peut aider à organiser les éléments sur lesquels reposent vos décisions. Ce n'est pas un espace où obtenir une position comme dans un moteur de recherche. Il ne remplace pas non plus un système de collecte des réponses de ChatGPT, Gemini ou Perplexity.
Voici une répartition utile des rôles : un processus distinct collecte les réponses et les sources, Jev évalue certains critères, un programme applique des règles et une personne vérifie les cas qui nécessitent une interprétation. Si un passage de page doit ensuite être réécrit, il s'agit d'une autre tâche éditoriale.
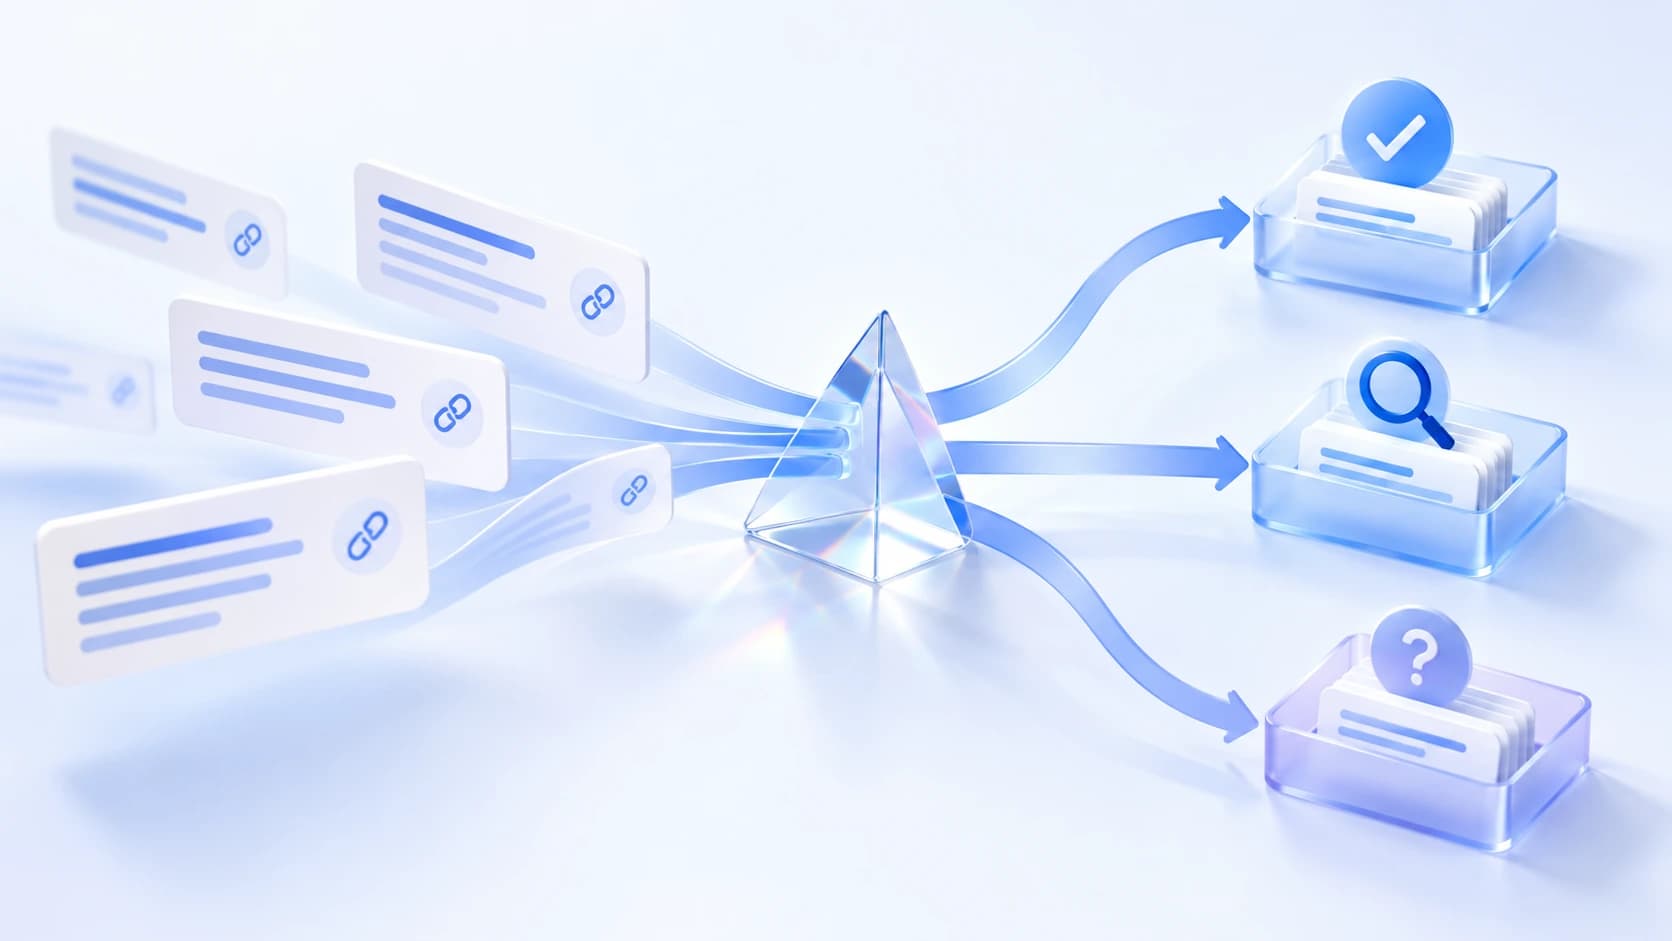
Schéma explicatif : conserver les réponses, poser des questions indépendantes et contrôler le résultat. Réalisation éditoriale originale à partir de la documentation TypeSafe. L'animation présente un processus proposé, et non une intégration opérationnelle.
Choice, Score et Noul : trois façons de poser des questions
Choisissez le type de question selon la décision à prendre. « Cette réponse est-elle bonne ? » est trop vague. Vous pouvez distinguer la présence d'une recommandation, l'exactitude des faits et la couverture du besoin du client.
| Type | Quelle question ? | Exemple en GEO |
|---|---|---|
| Choice | Quelle catégorie définie ? | Mention neutre, recommandation ou avis défavorable. |
| Score | Quel niveau de l'échelle décrite ? | Aucune réponse, réponse partielle ou toutes les conditions couvertes. |
| Noul | L'affirmation indiquée est-elle vraie ? | La réponse recommande-t-elle explicitement la marque indiquée ? |
Choice sélectionne une catégorie parmi un ensemble fourni. Les catégories doivent être distinctes et les critères couvrir les cas limites. Si vous évaluez plusieurs caractéristiques, par exemple la recommandation et la conformité à l'offre, posez des questions séparées. Documentation Choice.
Score exige des niveaux ordonnés et décrits. « Ne répond pas », « répond partiellement » et « répond à toutes les conditions indiquées » sont des critères plus clairs qu'une note de « qualité de 1 à 10 » sans explication. Le résultat dépend de votre définition de la qualité. Documentation Score.
Noul renvoie la probabilité d'une réponse « oui ». Une valeur proche de 0,5 signale une incertitude, pas la satisfaction partielle d'une condition. La question doit préciser clairement ce que signifie « oui ». Documentation Noul.
Quelles informations sont à jour en octobre 2026 ?
Selon la documentation consultée le 20 octobre, la dernière version décrite est Jev 1.14, disponible depuis le 14 octobre 2026. La documentation distingue les identifiants de version des alias évolutifs « latest » et « preview ». Pendant les tests, conservez la version réelle du modèle : une modification derrière un alias peut modifier les résultats. Modèles et versions de Jev.
Dans l'annonce de la version 1.14, TypeSafe décrit aussi la prise en charge expérimentale des images, d'un contexte plus large et du type « box ». Le fournisseur souligne leur maturité limitée pour la production. Le processus d'évaluation textuelle présenté ici ne suppose donc pas leur utilisation. Annonce TypeSafe du 14 octobre.
Un résultat correctement formaté ne garantit pas une évaluation correcte. Le modèle peut renvoyer une catégorie autorisée tout en l'attribuant au mauvais cas.
7 usages de Jev en GEO et en SEO
Les scénarios ci-dessous sont des propositions d'utilisation du modèle, et non une liste de fonctions de Semly ou de résultats de déploiement. Chacun nécessite de définir des critères et de vérifier leur précision sur des contenus adaptés à votre tâche.
1. Distinguer mention, recommandation et avis défavorable
« La marque X est présente sur ce marché » ne signifie pas « La marque X mérite d'être envisagée pour cet usage ». « La marque X ne prend pas en charge cet usage » a encore un autre sens. Chaque phrase contient le nom de l'entreprise, mais une seule constitue une recommandation dans le contexte décrit.
Vous pouvez demander à Jev d'évaluer la position d'une réponse envers une marque précise. Ajoutez la question complète de l'utilisateur au contexte, car une recommandation peut être conditionnelle : un produit peut convenir à une petite boutique sans satisfaire les exigences d'une grande organisation.
Enregistrez séparément la présence du nom, la recommandation positive et le lien. Un lien vers le site du fabricant peut accompagner aussi bien une recommandation qu'une appréciation critique du produit.
Les données d'exemple servent à expliquer la méthode et ne représentent les résultats d'aucune marque. Les étiquettes de l'animation et des exemples suivants ont été préparées par la rédaction ; elles ne proviennent pas d'appels à Jev. Le même principe figure dans le texte : mention neutre, recommandation et avis défavorable sont des appréciations différentes, indépendamment de la présence d'un lien.
2. Évaluer d'abord si une source étaye une affirmation
La détection d'une URL se traite généralement avec des règles programmées. La question qui nécessite une évaluation est la suivante : un passage précis d'une source étaye-t-il une phrase précise de la réponse d'IA ?
Décomposez une phrase contenant plusieurs promesses en affirmations individuelles. Joignez à chacune le passage pertinent, le périmètre de l'offre et la date de consultation. Si la source n'a pas pu être récupérée, signalez l'absence de contenu. Ne la transformez pas en « la source ne confirme pas ».
Selon les questions conçues, le modèle peut signaler provisoirement une concordance, une contradiction ou un besoin de vérification. La méthode complète d'audit est décrite séparément : les sources citées confirment-elles les informations sur l'entreprise ?.
3. Organiser les questions des clients
Les questions sur le prix, le déploiement, les limites et la comparaison d'offres demandent des réponses différentes. La classification aide à structurer la liste d'analyse et à l'attribuer aux personnes responsables.
Déterminez si une question peut avoir plusieurs intentions. « Combien coûte le déploiement et comprend-il la migration ? » concerne à la fois le prix et le périmètre. Vous pouvez en faire deux tâches ou évaluer séparément ces dimensions. Imposer une catégorie unique peut masquer un besoin important.
Ne déduisez pas automatiquement la taille de la demande du nombre de questions. De nombreuses formulations proches peuvent provenir d'une même source et concerner un seul besoin.
4. Vérifier si une page répond aux conditions de la question
Un client cherche une solution pour un usage précis, avec une intégration particulière et un budget limité. La page décrit le produit sans expliquer sa compatibilité. Le modèle peut signaler provisoirement cette lacune selon une échelle de complétude définie.
Évaluez chaque condition séparément. L'absence d'information sur une intégration ne signifie pas que le produit ne la propose pas. Elle signifie que le contenu fourni ne tranche pas la question. Il faut ensuite vérifier le fait et compléter la description si l'information est utile au lecteur.
Un Score élevé n'est ni un score de classement Google ni une probabilité de citation par ChatGPT. Il évalue un contenu précis selon vos critères.
5. Repérer les paires de pages à examiner pour la cannibalisation
Sélectionnez d'abord des paires candidates selon le thème, les requêtes ou la similarité des contenus. Vous pourrez ensuite évaluer si elles répondent au même besoin ou accompagnent des décisions différentes.
Le modèle doit recevoir la question principale, le public visé et le contenu des deux pages. Des mots similaires dans les titres ne suffisent pas. Le résultat doit former une liste de contrôle éditorial. Une fusion exige de prendre en compte la valeur, le trafic et le rôle des pages dans le site.
Nous expliquons une répartition pratique des sujets dans le guide blog et base de connaissances sans cannibalisation.
6. Évaluer l'utilité d'un lien interne proposé
Parmi les liens candidats, choisissez ceux qui aident le lecteur à passer à l'étape suivante. Un article sur le choix d'une solution peut renvoyer à un guide de préparation des données si le lecteur en a besoin après sa décision.
La question au modèle doit porter sur l'utilité du lien dans un paragraphe précis. La proximité thématique ne suffit pas. Le programme peut vérifier séparément le fonctionnement de l'URL, tandis que la rédaction vérifie le naturel du texte d'ancrage.
7. Soumettre les promesses et comparaisons à vérification
Avant publication, vous pouvez signaler les passages contenant des prix, des délais, des garanties de résultat ou des comparaisons concurrentielles. Cette détection aide à transmettre le texte à une personne qui connaît l'offre actuelle.
C'est une étape de contrôle, pas une confirmation automatique de véracité. Le modèle ne peut pas établir qu'une entreprise lance réellement un service en une journée sans source fiable. Sans source, l'article nécessite un travail éditorial.
Comment concevoir un processus vérifiable ?
Commencez par une tâche, par exemple reconnaître les recommandations d'une marque donnée. Consignez la définition d'une recommandation, les cas exclus et les règles applicables aux réponses incomplètes. Automatisez seulement ensuite.
Conservez le contenu original avec la question, le nom du produit d'IA, le mode, la langue et la date. Une phrase isolée peut être évaluée différemment d'une réponse complète. L'absence de réponse, un échec de récupération et une réponse sans marque doivent avoir des étiquettes distinctes.
Plusieurs questions indépendantes sur le même contenu peuvent être envoyées dans une requête. Combinez leurs résultats avec les règles du programme. Si une question ultérieure dépend de données récupérées après le premier résultat, une autre étape sera nécessaire. Principes de conception des questions TypeSafe.
Contenu -> questions séparées -> règles -> résultat ou contrôle humain.
Source absente -> compléter le contenu. Évaluation incertaine -> vérifier. Définition modifiée -> refaire le test.
Conservez dans le rapport l'évaluation et la version des critères. Si vous modifiez la définition d'une recommandation, recalculez les périodes comparées avec les mêmes règles ou signalez une rupture de comparabilité. Sinon, une amélioration du classificateur peut ressembler à une hausse de visibilité de la marque.
Confidence ne garantit pas un pourcentage de réponses correctes
Pour Choice et Score, la documentation décrit un champ « confidence », calculé à partir de la distribution de probabilités. Il indique à quel point le résultat du modèle est tranché. N'interprétez pas automatiquement 0,9 comme une précision vérifiée de 90 % sur vos réponses d'IA. Noul ne renvoie pas de champ « confidence » distinct. Comment TypeSafe décrit la confiance.
Choisissez le seuil de contrôle à partir d'un test de la tâche précise. Le niveau requis pour trier une file peut différer de celui exigé pour utiliser l'évaluation dans un rapport client. Une confiance élevée ne dispense pas du contrôle qualité.
N'excluez pas les cas incertains de la mesure sans en indiquer le nombre. Si le modèle peine davantage dans une langue, un rapport limité aux cas faciles peut fausser la comparaison.
Comment vérifier la précision : un exemple sur 120 réponses
Dans les données d'exemple, un rédacteur a évalué 120 réponses. Le modèle en a classé 30 comme recommandations. La comparaison avec l'évaluation du rédacteur montre 24 classifications correctes et 6 erreurs. Le modèle a également manqué 8 recommandations.
| Évaluation du modèle | Recommandation selon la rédaction | Pas de recommandation selon la rédaction |
|---|---|---|
| Recommandation | 24 détections correctes | 6 fausses alertes |
| Pas de recommandation | 8 recommandations manquées | 82 évaluations correctes sans recommandation |
| Total | 32 réponses | 88 réponses |
La précision des recommandations vaut ici 24 / 30 = 80 %. Une recommandation détectée sur cinq est donc une fausse alerte. Le rappel vaut 24 / 32 = 75 %, car le rédacteur identifie 32 recommandations réelles au total. Le modèle en a manqué un quart.
L'accord global vaut 106 / 120, soit environ 88,3 %. Ce chiffre paraît meilleur parce que la plupart des réponses ne contenaient pas de recommandation. À lui seul, il ne permet pas d'évaluer l'utilité du classificateur.
En pratique, préparez des exemples pour affiner les critères et un jeu distinct pour la vérification finale. Ajoutez des négations, des recommandations conditionnelles, des noms d'entreprises proches et des sources incomplètes. Faites évaluer une partie du contenu par deux personnes. Leurs désaccords peuvent révéler une définition ambiguë avant l'évaluation du modèle.
Le nombre 120 illustre les calculs ; ce n'est pas une norme de validation. La taille de l'échantillon et le niveau d'erreur acceptable dépendent de l'objectif. Testez les contenus polonais en polonais : TypeSafe indique que l'anglais est actuellement la langue offrant la meilleure précision. Prise en charge des langues.
Combien coûte Jev, et combien coûte tout le processus GEO ?
Le tarif des modèles consulté le 20 octobre 2026 affiche 0,042 USD par million de tokens d'entrée. Un token est une unité de texte facturée par l'API. D'après la documentation, les tokens de sortie sont gratuits. Il s'agit du prix fournisseur à la date de vérification, pas d'une garantie de prix futur. Tarifs dans la documentation des modèles.
Dans les données d'exemple, vous souhaitez évaluer 2 000 réponses et chaque requête contient en moyenne 1 200 tokens d'entrée, contexte et questions compris. Le calcul est : 2 000 × 1 200 = 2 400 000 tokens ; 2,4 × 0,042 USD = 0,1008 USD, soit environ 0,10 USD pour cette partie du travail.
Ce calcul repose sur une taille d'entrée supposée, pas sur la mesure d'appels effectués. Un second passage complet de même taille doublerait le coût à environ 0,20 USD. Un contexte plus long et les nouvelles tentatives augmentent aussi la consommation.
| Élément du processus | Inclus dans les 0,10 USD indiqués ? | Que prendre en compte ? |
|---|---|---|
| Évaluation dans Jev | Oui, selon les hypothèses de l'exemple | Le nombre réel de tokens d'entrée. |
| Collecte des réponses d'IA | Non | API, service de collecte ou travail manuel. |
| Récupération et conservation des sources | Non | Accès aux pages, extraction et stockage. |
| Contrôle qualité | Non | Annotation de l'échantillon, désaccords et contrôle humain. |
| Préparation des modifications | Non | Rédaction, vérification des faits et mise en œuvre. |
Une classification peu coûteuse ne signifie donc pas un suivi GEO pour quelques centimes. Comparez le coût du processus complet et celui d'un résultat correct et utile. Le faible prix d'une évaluation perd son intérêt si chacune doit être corrigée manuellement.
Que ne prouvent pas les benchmarks du fournisseur ?
La page publique d'évaluation de TypeSafe décrit quatre processus d'automatisation. Elle compare les modèles à des étiquettes de référence déterminées par d'autres modèles. Il s'agit d'une comparaison dans un dispositif précis, pas d'une évaluation indépendante de Jev pour le GEO en polonais. Méthodologie d'évaluation TypeSafe.
Ne transposez pas un chiffre d'un tel graphique aux recommandations de marque, à la détection de cannibalisation ou à la conformité des citations. Il ne prouve pas non plus que Jev augmente les recommandations d'une entreprise. Cette conclusion nécessiterait une évaluation distincte de l'évolution de la visibilité et de ses conditions de mesure.
Jev aide-t-il à obtenir des citations dans Google et ChatGPT ?
Il peut aider à repérer des lacunes dans les contenus ou à organiser l'évaluation des réponses. Mais exécuter le modèle ne pousse pas, à lui seul, un moteur externe à lire une page, à la juger utile et à la citer.
Google précise que les fondamentaux du SEO s'appliquent à la présence comme source dans AI Overviews et AI Mode. Une page doit être indexée et pouvoir apparaître avec un extrait textuel. Respecter les exigences ne garantit pas sa présence. Ces consignes concernent les fonctionnalités Google, pas une spécification commune à tous les assistants. Google Search Central : fonctionnalités d'IA et votre site.
Utilisez l'évaluation pour mieux répondre au lecteur : préciser des conditions, expliquer les limites, ajouter une source ou distinguer des guides similaires. Google recommande des contenus utiles conçus pour les personnes. Ses règles antispam couvrent les contenus produits à grande échelle principalement pour manipuler les résultats. Contenus utiles et règles antispam.
Par où commencer dans votre entreprise ?
Définissez d'abord la question métier. Voulez-vous savoir si l'IA recommande votre marque ? Si elle décrit correctement l'offre ? Si les sources étayent des affirmations précises ? Chaque tâche demande des critères différents.
Si vous débutez, vérifiez la présence de l'entreprise et lisez les réponses complètes. Une fois l'objet de l'évaluation défini, préparez un échantillon annoté manuellement. Jev mérite un test lorsque la tâche est répétitive et que vous savez expliquer comment reconnaître un résultat correct.
Questions fréquentes sur Jev et le GEO
Jev peut-il rédiger un article pour le GEO ?
Jev sert à produire des évaluations structurées, pas à rédiger librement des articles. Dans le processus proposé, il peut évaluer une caractéristique précise du texte. La création et la révision restent des tâches séparées.
Jev vérifie-t-il lui-même ce que dit ChatGPT ?
Dans le processus décrit, vous fournissez la réponse et le contexte nécessaire. La collecte des réponses, la conservation des sources et la documentation des conditions de mesure nécessitent un traitement distinct.
Peut-on positionner une entreprise dans Jev ?
Cet article ne décrit pas Jev comme un moteur présentant aux clients un classement d'entreprises. Il peut soutenir l'analyse des éléments utilisés pour travailler la visibilité.
Une confiance élevée permet-elle de se passer d'un humain ?
La décision dépend de la précision vérifiée sur votre tâche et des conséquences d'une erreur. La confiance du modèle ne confirme pas à elle seule l'exactitude. Conservez un circuit de contrôle et vérifiez régulièrement les résultats acceptés automatiquement.
Semly utilise-t-il Jev ?
Cet article ne confirme aucun déploiement de Jev dans Semly. Il présente des usages possibles du modèle en analyse GEO et SEO, leurs limites et une proposition de test.
La documentation et les sources ont été vérifiées le 20 octobre 2026. Les descriptions des fonctions et des tarifs proviennent de TypeSafe. Les scénarios, schémas et données d'exemple sont des créations éditoriales et ne représentent pas des résultats de marques ou de clients de Semly.
Partager :
