

AI में अपनी कंपनी की दृश्यता जाँचें
निःशुल्क, क्रेडिट कार्ड की आवश्यकता नहीं।
Semly के शोध के प्रमुख निष्कर्ष
AI में ब्रांड दृश्यता प्रश्न पूछने वाले की ज़रूरत और मॉडल से बातचीत के क्रम के अनुसार आँकनी चाहिए। सामान्य प्रश्न के उत्तर में ब्रांड आना नहीं बताता कि प्रणाली उसे उचित प्रस्ताव वाले व्यक्ति को सुझाती है या नहीं। Semly की विधि में Leon रूपरेखा से परिभाषित उपयोगकर्ता बनता है और लक्षित खरीद प्रश्न से पहले बातचीत से संदर्भ बनाता है।
Semly में हम AI Agent Leon के साथ यह तरीका विकसित कर रहे हैं। छह महीनों तक ChatGPT और Gemini से प्रश्न करने पर शोध और प्रयोग किए। रिपोर्ट का दिया डेटा 1.2 मिलियन प्रश्न, 24 समेकित रिकॉर्ड और 12 मिलान की गई तुलनाएँ शामिल करता है। विश्लेषण में छह समूह और सामग्री तैयारी के दो तरीके हैं: उपयोगकर्ता रूपरेखा के बिना और उसके साथ।
समान दृश्यता लक्ष्य तक औसत समय रूपरेखा के बिना 100 दिन और साथ 70 दिन था। यह 30% कमी या औसतन 30 दिन है। सामग्री प्रासंगिकता 61.5% से 77.5% बढ़ी — 16 प्रतिशत अंक। दोनों प्रणालियों में अंतर की समान दिशा दिखती है।
निष्कर्ष सामग्री योजना और दृश्यता विश्लेषण में रूपरेखाएँ इस्तेमाल करने का समर्थन करते हैं। वे अधिक विशिष्ट निर्देश का आधार हैं: सामग्री किसके लिए है, चयन के किन मानदंडों को समझाए और किन आपत्तियों का उत्तर दे। उत्तर दोहराव और रूपांतरण प्रभाव के अलग माप चाहिए; डेटा दोनों का संख्यात्मक प्रभाव नहीं देता।
| जानकारी | मान | आधार |
|---|---|---|
| दायरा | छह महीने, ChatGPT और Gemini | Semly का शोध विवरण |
| डेटा में प्रश्न | 1 200 000 | मापन की शुरुआत और अंत के प्रश्न काउंटरों का योग |
| तुलना संरचना | 24 रिकॉर्ड, 12 जोड़ियाँ | 6 समूह × 2 प्रणालियाँ × 2 तरीके |
| लक्ष्य तक औसत समय | 100 बनाम 70 दिन | 30% कमी |
| सामग्री प्रासंगिकता | 61.5% बनाम 77.5% | 16 प्रतिशत अंक; प्रति तरीका 1200 मूल्यांकन |
| दोहराव और रूपांतरण | डेटा में संख्यात्मक माप नहीं | मूल्यांकन के अलग क्षेत्र |
केवल प्रश्न ग्राहक की ज़रूरत क्यों नहीं बताता
आरामदायक रनिंग शूज़ कहाँ खरीद सकता हूँ? में सतह, अनुभव, बजट या उपयोग नहीं है। इसलिए सिफ़ारिश व्यापक श्रेणी की हो सकती है, लेकिन ब्रांड को जानना है कि वह जंगल में शौकिया दौड़ने वाले, पक्के रास्ते के शुरुआती या प्रतिस्पर्धी धावक तक पहुँचती है या नहीं।
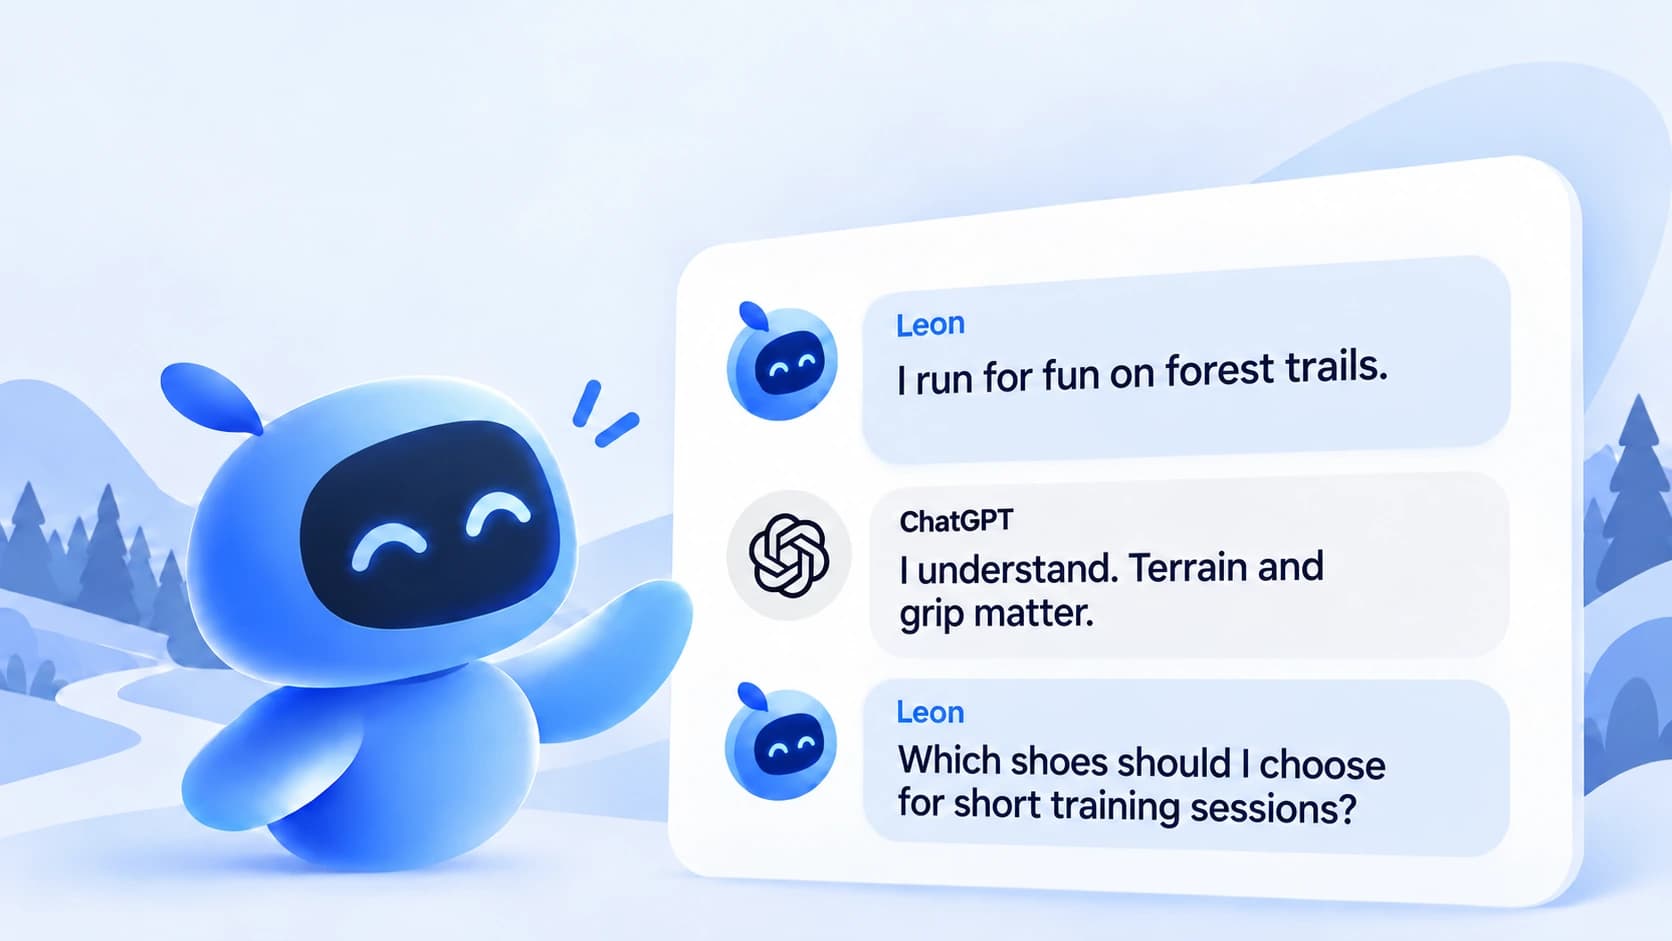
मैं मुख्यतः जंगल के रास्तों पर शौकिया दौड़ता हूँ और छोटे प्रशिक्षण के जूते चाहिए स्थिति सीमित करता है। Semly के तरीके में Leon शुरुआत में यह संदर्भ दे सकता है और उत्तर समझने के बाद लक्ष्य प्रश्न पर जा सकता है। मुख्य खरीद ज़रूरत समान है, लेकिन मापन शर्तों में रूपरेखा, उद्देश्य और पिछली बातचीत शामिल हैं। दृश्यता के बढ़ने या घटने की व्याख्या में यह महत्वपूर्ण है।
रूपरेखा उपयोगकर्ता की भूमिका और परिदृश्य तय करती है जिसका Leon मॉडल से बातचीत में इस्तेमाल करता है। एजेंट बातचीत में अपना संदर्भ बनाता है, जिससे शोध व्यक्ति के चैट उपयोग के करीब आता है। किसी विशिष्ट असली उपयोगकर्ता का इतिहास फिर नहीं बनाता। उत्पाद संबंधी ज़रूरत और सीमाओं से शुरू करना उपयोगी है। उम्र, लिंग और जनसांख्यिकी का कारण अध्ययन वाले परिदृश्य में हो।
OpenAI और Google के आधिकारिक निर्देश बताते हैं कि प्रासंगिक संदर्भ काम और सीमाएँ तय करने में मदद करता है [1][2]। यह प्रश्न बनाने का आधार है।
AI Agent Leon ब्रांड जानकारी को उपयोगकर्ता संदर्भ से कैसे जोड़ता है
Leon ब्रांड, उत्पाद, सेवाओं और मौजूदा सामग्री की जानकारी से रूपरेखाएँ बनाता है। फिर अध्ययन में चुनी प्रोफ़ाइल का उपयोगकर्ता बनता है। बातचीत शुरू करता है, मॉडल को परिचय देता और उत्तर समझता है। उसी से पहचानता है कि संदर्भ और उद्देश्य वाला लक्षित प्रॉम्प्ट कब पूछ सकता है। परिणाम व्यावहारिक प्रश्न हल करता है: क्या AI ऐसे व्यक्ति से बातचीत में ब्रांड शामिल करता है जिसकी ज़रूरत प्रस्ताव से मेल खाती है?
Leon निगरानी को सामग्री योजना से जोड़ता है। उत्तर चयन मानदंड, आपत्तियाँ और सिफ़ारिश के कारण की जानकारी दिखा सकते हैं। विशिष्ट परिदृश्य की जानकारी वेबसाइट पर न हो तो विश्लेषण कमियों वाला निर्देश बना सकता है।
Leon उपयोगकर्ता की तरह बातचीत करता है
Leon का शोध बातचीत के अनुसार चलता है। एजेंट पहले चुनी रूपरेखा के अध्ययन वाले उपयोगकर्ता की तरह परिचय देता है। इससे स्थिति और ज़रूरत स्थापित होती है। उत्तर मिलने पर पढ़ता है और बातचीत लक्ष्य के अनुसार समझता है।
उत्तर समझना एजेंट के काम का हिस्सा है। Leon आँकता है कि लक्षित प्रश्न पर जा सकता है या नहीं। समय बातचीत के क्रम और उत्तर से तय होता है। लक्षित प्रॉम्प्ट में संदर्भ और उद्देश्य है और ऐसी बातचीत में आता है जहाँ मॉडल को उपयोगकर्ता की पहले की जानकारी है।
यह प्रश्न तरीका व्यक्ति के चैट उपयोग के करीब है। उपयोगकर्ता स्थिति बताता, उत्तर पढ़ता और उसी आधार पर अगला प्रश्न बनाता है। Leon अध्ययन में यही भूमिका लेता है, जिससे बढ़ती बातचीत में ब्रांड सिफ़ारिश विश्लेषित होती है।
उद्देश्य उपयोगकर्ता का इच्छित निर्णय तय करता है। दौड़ने के उदाहरण में संदर्भ जंगल के रास्तों की शौकिया दौड़ और उद्देश्य उचित जूते चुनना तथा खरीदना हो सकता है। Leon पिछला उत्तर समझने और तय करने के बाद सिफ़ारिश पूछता है कि लक्ष्य प्रश्न पूछ सकता है।
परिणाम समझने में पूरा बातचीत इतिहास प्रासंगिक है। अंतिम प्रश्न के समान शब्द अलग उत्तर दे सकते हैं यदि पहले के संदेश अलग ज़रूरत बताएँ। इसलिए अध्ययन लक्ष्य प्रॉम्प्ट और उसकी बातचीत दोनों पहचानें।
प्रक्रिया Leon की भूमिका और शोध का चैट जैसा होना समझाती है। लेकिन दिए समेकित आँकड़े परिचय, उत्तर समझने या प्रश्न समय चुनने के प्रभाव अलग नहीं करते। हम 30% और 16 प्रतिशत अंक के परिणाम किसी अलग चरण को नहीं देते।
| बातचीत का चरण | Leon का काम | शोध का महत्व |
|---|---|---|
| परिचय | रूपरेखा वाली उपयोगकर्ता भूमिका लेकर बातचीत शुरू करता है | उपयोगकर्ता की स्थिति और ज़रूरत स्थापित करता है |
| मॉडल का उत्तर | उत्तर प्राप्त करता और समझता है | बातचीत का क्रम ध्यान में रखता है |
| अगले प्रश्न का निर्णय | पहचानता है कि लक्ष्य प्रॉम्प्ट कब पूछना है | समय को उत्तर के अनुसार ढालता है |
| उद्देश्य वाला प्रॉम्प्ट | उसी बातचीत में संदर्भ और उद्देश्य वाला लक्ष्य प्रश्न पूछता है | उपयोगकर्ता संदर्भ में सिफ़ारिश आँकने देता है |
समय में 30% कमी का अर्थ
डेटा साझा शुरुआती दृश्यता 20% और साझा लक्ष्य 40% मानता है। दृश्यता ब्रांड सुझाने वाले उत्तरों की संख्या को प्रश्न संख्या से भाग देना है। यह 20 प्रतिशत अंकों की वृद्धि है। तरीके सामग्री तैयारी बताते हैं; परिणाम समान लक्ष्य और प्रश्न पैनल पर डेटा की मान्यताओं के अनुसार आँके जाते हैं।
लक्ष्य तक औसत समय बिना रूपरेखा 100 दिन और साथ 70 दिन है। कमी (100 - 70) / 100 × 100% यानी 30% है। अंतर 30 दिन है। सटीक विवरण है: समान लक्ष्य तक 30% कम समय।
दृश्यता बनाने वाली टीम के लिए संभावित अर्थ ज़रूरत पहचानने से इच्छित परिणाम तक छोटा चक्र है। संचालन व्याख्या महत्वपूर्ण है: अधिक लक्षित सामग्री बाद के सुधार की ज़रूरत घटा सकती है। लेकिन डेटा संपादकीय काम का समय या अंतर के अलग कारण नहीं बताता, इसलिए पूरा प्रभाव केवल Leon के स्वचालन को नहीं देते।
दिए डेटा में शुरुआती दृश्यता, अंतिम दृश्यता और लक्ष्य समय है, रोज़ की समय शृंखला नहीं। इसलिए चार्ट साझा परिणाम का समय दिखाता है। इससे ऐसा वक्र नहीं बनाते जो समान गति से प्रभाव जुड़ना सुझाए।
चार्ट 1. साझा 40% दृश्यता लक्ष्य तक औसत समय: 100 और 70 दिन। आधार: Semly डेटा की 12 मिलान तुलनाएँ। अंतर: 30 दिन, 30% कमी।
सामग्री प्रासंगिकता और उत्तर सटीकता अलग माप हैं
डेटा में सामग्री प्रासंगिकता उन आँकी सामग्रियों का हिस्सा है जिन्हें रूपरेखा की ज़रूरत के अनुकूल माना गया। हर रिकॉर्ड में 100 मूल्यांकन हैं। बिना रूपरेखा 1200 में 738 प्रासंगिक सामग्री; साथ 1200 में 930 हैं। यह 61.5% और 77.5% है।
अंतर 16 प्रतिशत अंक है। 61.5% शुरुआती स्तर से सापेक्ष वृद्धि लगभग 26.0% है। यह समान डेटा के दो विवरण हैं, समान इकाई नहीं। पाठ और चार्ट का मुख्य माप प्रतिशत अंक का अंतर है।
सामग्री प्रासंगिकता मॉडल उत्तर की सत्यता नहीं है। उत्तर ज़रूरत से मेल खाते हुए गलत उत्पाद विवरण दे सकता है। इसलिए सटीकता अलग आँकें: क्या आवश्यकता ध्यान में है, सिफ़ारिश उचित है और तथ्य स्रोत समर्थित हैं?
77.5% परिणाम रूपरेखा वाले तरीके में उपयोगकर्ता ज़रूरत पूरी करने वाली सामग्री का अधिक हिस्सा दिखाता है। यह इस डेटा में चयन को अधिक प्रासंगिक बताने का समर्थन है। केवल समेकित डेटा मिलने और व्यक्तिगत मूल्यांकन या विस्तृत अंक नियम न होने के कारण रिपोर्ट सांख्यिकीय महत्व का दावा नहीं करती और प्रासंगिकता को हर उत्तर की तथ्य सटीकता के बराबर नहीं मानती।
चार्ट 2. सामग्री प्रासंगिकता: 61.5% और 77.5%, अंतर 16 प्रतिशत अंक। आधार: Semly डेटा में प्रति तरीका 1200 मूल्यांकन। माप रूपरेखा ज़रूरत से मेल का है; रूपांतरण दर नहीं।
ChatGPT और Gemini के परिणाम
ChatGPT में लक्ष्य तक औसत समय बिना रूपरेखा 95 दिन और साथ 66.5 दिन है। Gemini में 105 और 73.5 दिन। दोनों 30% कमी दिखाते हैं। तुलना विश्लेषित समूहों में समान अंतर दिशा बताती है।
ChatGPT रिकॉर्ड में सामग्री प्रासंगिकता बिना रूपरेखा 60.5% और साथ 76.5% है। Gemini में 62.5% और 78.5%। हर प्रणाली में अंतर 16 प्रतिशत अंक है। प्रणाली और तरीके के हर संयोजन में 600 सामग्री मूल्यांकन हैं।
प्रणाली अनुसार अलग परिणाम जाँचते हैं कि कुल औसत अलग नतीजे छिपाता है या नहीं। इस डेटा में तरीके का अंतर ChatGPT और Gemini दोनों में सुसंगत है। यह मॉडलों की गुणवत्ता रैंकिंग नहीं: समय और प्रासंगिकता विश्लेषित काम और सामग्री बताते हैं।
व्यवहार में हर प्रणाली की अलग दृश्यता प्रोफ़ाइल उपयोगी है। समान सामग्री और ज़रूरत अलग प्रस्तुत हो सकती हैं। Leon की सिफ़ारिश तब विशिष्ट प्रणाली और परिदृश्य के अनुसार आँकी जा सकती है, पूरी ब्रांड मौजूदगी एक संख्या में नहीं समेटनी पड़ती।
चार्ट 3. ChatGPT और Gemini में साझा लक्ष्य का औसत समय। आधार: प्रति प्रणाली 6 मिलान तुलनाएँ, Semly डेटा। परिणाम विश्लेषित तरीके बताता है, मॉडल गुणवत्ता रैंकिंग नहीं।
| AI प्रणाली | बिना / साथ रूपरेखा का समय | बिना / साथ रूपरेखा की प्रासंगिकता |
|---|---|---|
| ChatGPT | 95 / 66.5 दिन | 60.5% / 76.5% |
| Gemini | 105 / 73.5 दिन | 62.5% / 78.5% |
छह समूहों के परिणाम
डेटा में M1-M6 समूह हैं। हर समूह में दोनों प्रणालियों का औसत लक्ष्य समय बिना रूपरेखा 75, 85, 95, 105, 115 और 125 दिन है। साथ 52.5, 59.5, 66.5, 73.5, 80.5 और 87.5 दिन।
तरीकों का अंतर कम और अधिक समय दोनों में दिखता है। M1 में 22.5 दिन और M6 में 37.5 दिन। डेटा की हर जोड़ी में रूपरेखा का समय बिना रूपरेखा समय का 70% है। यह स्थिर संबंध स्पष्ट दिखाते हैं; मॉडल उत्तर दोहराव का माप नहीं मानते।
M1-M6 समूह हैं, एक ब्रांड की छह लगातार दृश्यता रीडिंग नहीं। बढ़ता समय अगले महीनों में घटती प्रभावशीलता न माना जाए। मौसम और समय बदलाव के लिए कैलेंडर तारीख और रोज़ या साप्ताहिक रीडिंग चाहिए।
पूर्ण लक्ष्य समय आकलन में उन मामलों को भी बताएँ जो अवलोकन खत्म होने से पहले सीमा तक नहीं पहुँचे। दिया डेटा उन्हें अलग नहीं पहचानता। आगे की तुलना बनाते समय ध्यान में रखें।
चार्ट 4. छह समूहों का लक्ष्य समय, दो प्रणालियों का औसत, Semly डेटा। M1-M6 एक ब्रांड की मासिक दृश्यता समय शृंखला नहीं।
कई रूपरेखाओं में समान प्रश्न
Semly के काम में हमने कई रूपरेखाओं में समान मूल प्रश्न भी अध्ययन किया। Leon हर प्रोफ़ाइल के उपयोगकर्ता की तरह लक्ष्य प्रश्न से पहले बातचीत करता है। इससे ज़रूरत, उद्देश्य और पिछला संदर्भ सिफ़ारिश तथा खरीद निर्णय की उपयोगी जानकारी को कैसे प्रभावित करते हैं पहचानते हैं। रनिंग शूज़ में पक्के रास्ते का शुरुआती, जंगल का शौकिया धावक और लंबे ट्रेल प्रशिक्षण वाला व्यक्ति हो सकते हैं। नीचे की तालिका विधि का उपयोग दिखाती है। अध्ययन उत्तरों का प्रतिलेख नहीं।
हर उत्तर के लिए सुझाई ब्रांड, चयन तर्क, तकनीकी आवश्यकताएँ, आपत्तियाँ और उद्धृत URLs लिखना उपयोगी है। तुलना दिखाती है कि कौन सी जानकारी परिदृश्यों में दोहराती है और कौन सी विशिष्ट ज़रूरत की है। निर्देश में साझा आधार और अंतर के अतिरिक्त खंड हो सकते हैं।
Semly कई रूपरेखाओं के काम के अवलोकन को अधिक प्रासंगिक सामग्री सिफ़ारिश का आधार बनाता है। लेकिन दिए डेटा में रूपरेखा पहचान, पूरे प्रॉम्प्ट या मॉडल उत्तर नहीं हैं। इसलिए रिपोर्ट विशिष्ट रूपरेखा को संख्यात्मक प्रभाव नहीं देती या उसकी सुझाई ब्रांडों की रैंकिंग नहीं बनाती।
| परिदृश्य का उदाहरण | उत्तर विश्लेषण के प्रश्न | संभावित सामग्री दायरा |
|---|---|---|
| शुरुआती, छोटे पक्के रास्ते | क्या आराम और सही फ़िट के मानदंड हैं? | पहली जोड़ी, आकार और उपयोग चुनना |
| जंगल के रास्तों पर शौकिया दौड़ | क्या उत्तर सतह और पकड़ ध्यान में रखता है? | इलाके की परिस्थितियाँ और तलवों की तुलना |
| लंबे ट्रेल प्रशिक्षण | मॉडल कौन सी सीमाएँ और विवरण पहचानता है? | लंबे प्रयास के विकल्पों की तुलना |
कई रूपरेखाओं के उत्तर सामग्री निर्देश कैसे बनते हैं
अंतिम सिफ़ारिश से पहले भी बातचीत निर्देश की जानकारी दे सकती है। पहले का उत्तर समझाने वाले मानदंड दिखा सकता है और Leon का लक्षित प्रश्न उन्हें उद्देश्य से जोड़ता है। पूरी बातचीत विश्लेषित करना अगले निर्णय चरणों की उपयोगी सामग्री पहचानता है।
पहले चयन मानदंड ब्रांड नामों से अलग करें। केवल सुझाई कंपनियों की सूची नहीं बताती कि क्यों आती हैं। किसी उपयोगकर्ता को उपयोग तुलना, अनुकूलता की व्याख्या या स्पष्ट वापसी शर्तें चाहिए, यह संपादकीय टीम के लिए अधिक उपयोगी है।
फिर ज़रूरत की तुलना ब्रांड सामग्री से करें। महत्वपूर्ण प्रश्न का छूटा उत्तर मौजूदा पृष्ठ अपडेट करने का कारण हो सकता है। समूहों का अंतर अलग खंड या तुलना का कारण हो सकता है। निर्णय लोगों की उपयोगिता का हो, हर रूपरेखा के लिए यांत्रिक रूप से पृष्ठ बढ़ाने का नहीं।
उदाहरण निर्देश में परिदृश्य, निर्णय, प्रमुख मानदंड, सत्यापित उत्पाद डेटा, आपत्तियाँ और स्रोत हो सकते हैं। विश्लेषण जंगल के रास्तों का हो तो सामग्री उत्पाद का उपयोग और सीमाएँ समझाए।
इस तरह की सामग्री AI उत्तर से आने वाले के लिए अधिक प्रासंगिक हो सकती है। इससे बेहतर रूपांतरण की परिकल्पना का समर्थन है। पुष्टि के लिए लागू करने के बाद उपयोगकर्ता व्यवहार और बिक्री परिणाम तुलना चाहिए।
दोहराव के लिए बार-बार मापन चाहिए
निश्चित रूपरेखा और सुसंगत बातचीत नियम मापन तुलना आसान कर सकते हैं। Leon लक्ष्य प्रश्न से पहले उत्तर समझता है, इसलिए बातचीत इतिहास और निर्णय नियम नियंत्रित होने चाहिए। प्रक्रिया दोहराव और अंतिम उत्तरों का मेल अलग मापें।
सुझाए परीक्षण में मॉडल संस्करण, खोज मोड, भाषा, स्थान और सेशन शुरू करने के नियम समान हों। समान रूपरेखा और लक्ष्य से शुरू पूरी बातचीत तथा समान रूप से फिर बनाए संदर्भ के उत्तर दोनों तुलना करना उपयोगी है। पहली तुलना पूरी प्रक्रिया की विविधता आँकती है; दूसरी अंतिम उत्तर की। शुरुआती और रूपरेखा पैनल साथ चलें।
संभावित माप में ब्रांड मौजूदगी की स्थिरता, सुझाई ब्रांड समूह का मेल और उद्धृत स्रोतों का मेल हैं। A और B समूहों का सरल मेल माप दोनों उत्तरों की सभी ब्रांडों के समूह में साझा ब्रांडों का हिस्सा है। दोनों खाली हों तो अलग रिपोर्ट नियम चाहिए।
एक रूपरेखा के भीतर दोहराव और रूपरेखाओं के अंतर अलग प्रश्न हैं। एक प्रोफ़ाइल की स्थिर सिफ़ारिश के साथ प्रोफ़ाइलों के स्पष्ट अंतर हो सकते हैं। Leon के संरचित विवरण सुसंगत प्रश्न शर्तें रखते हैं। लेकिन दिए डेटा में लगातार उत्तरों के मेल का माप नहीं है, इसलिए दोहराव सुधार की मात्रा नहीं बताते।
रूपांतरण पर प्रभाव कैसे सत्यापित करें
व्यावसायिक मापन उत्तर में ब्रांड मौजूदगी, वेबसाइट उद्धरण, उपयोगकर्ता विज़िट और कार्रवाई पूरी करना अलग करे। हर चरण का अपना माप चाहिए। सिफ़ारिश संख्या विज़िट संख्या नहीं और विज़िट संख्या खरीद संख्या नहीं।
सामग्री लागू करने के बाद पहचाने AI स्रोतों के सेशन, जुड़ाव, प्रश्न, लेन-देन और राजस्व देखना उपयोगी है। कुछ ट्रैफ़िक का स्पष्ट स्रोत नहीं हो सकता, इसलिए पहचाने सेशन का दायरा बताएँ। रूपांतरण दर का हर स्पष्ट हो, जैसे योग्य सेशन।
समान पृष्ठ या सामग्री समूहों की समान रूपांतरण परिभाषा और अवलोकन अवधि के साथ तुलना अधिक विश्वसनीय आकलन देती है। प्रचार, कीमत, उत्पाद उपलब्धता और अभियान जैसे अन्य बदलाव दर्ज हों। अन्यथा बिक्री वृद्धि सामग्री रणनीति बदलाव को गलत दी जा सकती है।
इसलिए रिपोर्ट विशिष्ट परिकल्पना देती है: वास्तविक ज़रूरत से जुड़ी सामग्री निर्णय में मदद कर सकती है। बिक्री प्रभाव का आकार मापना बाकी है। स्प्रेडशीट में सेशन, संभावित ग्राहक या लेन-देन नहीं हैं।
पद्धति बदलाव का दृश्यता परिणाम के लिए अर्थ
रूपरेखा और Leon की बातचीत जोड़ना मॉडल से प्रश्न का तरीका बदलता है। लक्षित प्रॉम्प्ट के उत्तर में पुराने संदेश भी हैं। ब्रांड ज़रूरत से बेहतर मेल करे तो परिणाम बढ़ सकता है या प्रणाली दूसरा प्रस्ताव चुने तो घट सकता है। तुलना प्रश्न शब्द और बातचीत संदर्भ तैयार करने का तरीका दोनों देखे।
सबसे स्पष्ट तरीका शुरुआती और रूपरेखा पैनल साथ दिखाना है। संयुक्त औसत चाहिए तो रूपरेखा हिस्से पाठकों की स्पष्ट मान्यताओं पर हों। बराबर महत्व सरल विकल्प है, लेकिन वास्तविक माँग में हर समूह का समान हिस्सा नहीं साबित करता।
रूपरेखा चुनते समय ज़रूरत से मेल भी महत्वपूर्ण है। केवल प्रस्ताव के दृष्टिकोण से प्रोफ़ाइल खरीद बाधाएँ या अनुचित उत्पाद की स्थितियाँ छोड़ सकती है। केवल आसानी से सुझाई जाने वाली ब्रांड के उपयोगकर्ताओं पर पैनल बनाने के बजाय कठिन परिदृश्य भी रखें।
रिपोर्ट का सार
Semly का शोध दिखाता है कि रूपरेखाएँ सामग्री को उपयोगकर्ता ज़रूरत से जोड़ने और AI दृश्यता बनाने का समय घटाने में मदद करती हैं। विश्लेषित डेटा में साझा लक्ष्य का औसत बिना रूपरेखा 100 दिन और साथ 70 दिन — 30% कम था। सामग्री प्रासंगिकता 61.5% से 77.5% यानी 16 प्रतिशत अंक बढ़ी। समान अंतर दिशा ChatGPT और Gemini में थी।
Leon इसे बातचीत का रूप देता है। एजेंट उपयोगकर्ता बनता है: रूपरेखा का परिचय देता, मॉडल उत्तर समझता और संदर्भ तथा उद्देश्य वाला लक्ष्य प्रश्न कब पूछना है पहचानता है। इससे Semly लोगों के चैट उपयोग के करीब शर्तों में सिफ़ारिश विश्लेषित करता है।
कई रूपरेखाओं में समान मूल प्रश्न अलग चयन मानदंड, आपत्तियाँ और जानकारी ज़रूरतें पहचानता है। इससे अधिक विशिष्ट निर्देश, तुलनाएँ और निर्णय सहायता सामग्री बन सकती है। अधिक प्रासंगिकता इस तरीके का समर्थन है; रूपांतरण प्रभाव के लिए अलग व्यवहार और व्यावसायिक परिणाम मापन चाहिए।
सुसंगत रूपरेखा और बातचीत नियम तुलनीय निगरानी का आधार हैं। फिर भी उत्तर दोहराव आगे के मापनों में बातचीत इतिहास और प्रश्न शर्तों के साथ आँकना होगा। प्रस्तुत परिणाम दोहराव सुधार या रूपांतरण वृद्धि की मात्रा नहीं बताते।
ब्रांड के लिए व्यावहारिक अर्थ स्पष्ट है: अध्ययन करें कि AI किसे और किस स्थिति में प्रस्ताव सुझाता है, फिर सामग्री विकसित करने में जानकारी इस्तेमाल करें। Semly इस तरह दृश्यता निगरानी को संदर्भ, उद्देश्य और मॉडल सिफ़ारिश के शोध से जोड़ता है।
स्रोत
Semly सामग्री: दस लाख से अधिक प्रश्न, छह महीनों का शोध। Semly AI दृश्यता निगरानी में रूपरेखाएँ क्यों जोड़ रहा है, साथ में Leon की बातचीत का Semly विवरण — एजेंट और शोध विवरण के स्रोत।
[1] OpenAI, Prompt engineering. प्रश्न में प्रासंगिक संदर्भ देने के दिशानिर्देश। https://developers.openai.com/api/docs/guides/prompt-engineering
[2] Google AI for Developers, Prompt design strategies. संदर्भ और काम की सीमाओं के दिशानिर्देश। https://ai.google.dev/gemini-api/docs/prompting-strategies
[3] Franziska Weeber, Vera Neplenbroek, Jan Batzner, Sebastian Padó, एक रूपरेखा, कई संकेत, अलग परिणाम: सामाजिक और जनसांख्यिकीय संकेत LLM के व्यक्तिगत अनुभव को कैसे प्रभावित करते हैं, ACL 2026। https://aclanthology.org/2026.acl-long.2079/
साझा करें:
