

AIにおける自社の可視性を確認しましょう
無料。クレジットカードは不要です。
ほとんどの人は、何かを書いたり、説明したり、要約したりするために AI を使用します。 TypeSafe AI の Jev は、提供された情報に基づいて特定の決定を下すという別の目的を果たします。 AI の可視性に焦点を当てているチームにとって、これにより、顧客の質問の整理から応答の分析、コンテンツの評価に至るまで、興味深い応用分野が開かれます。
ジェブとは何ですか?
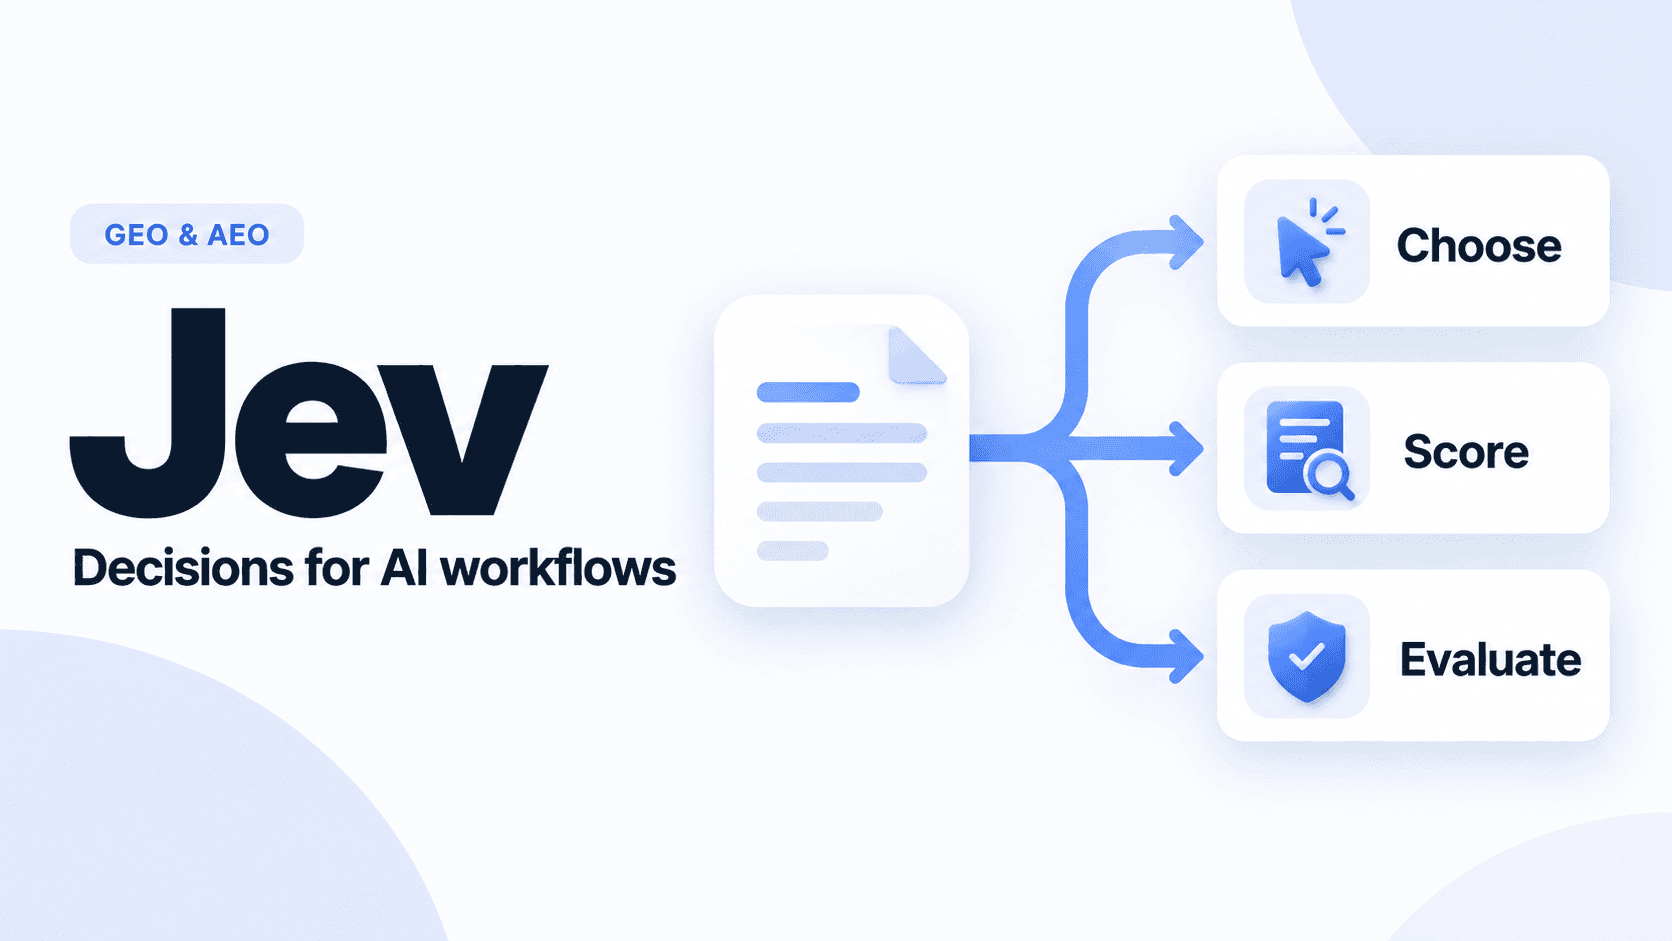
Jev は TypeSafe の AI モデルで、ソフトウェアが直接利用できる構造化された決定を返すように設計されています。
評価のための情報を提供し、質問と受け入れられる種類の回答を指定します。このモデルは、自由に書かれたテキストの代わりに、選択肢、評価、または確率を返します。その動作を次のように説明します。 TypeSafe ドキュメント.
あなたの業界に関する 100 件の AI 回答を分析することを想像してください。そのブランドが単に言及されただけなのか、実際に推奨されているのかを判断する必要があります。生成モデルに各応答を記述するように依頼できますが、後でこれらの記述を比較可能なデータに変換する必要があります。
Jev アプローチでは、事前にカテゴリを定義する必要があります。結果は、テーブル、レポート、または分析の次の段階に進むことができます。
TypeSafe がこれを System One モデルと呼ぶのはなぜですか?
TypeSafe は、同社が開発中の System One カテゴリの最初の公開モデルとして、2026 年 9 月 15 日に Jev を導入しました。この名前は、迅速で直感的な判断と、よりゆっくりで複雑な推論との区別を指します。
メーカーによると、Jev は調整された意思決定のための強化学習 (RLCD) と呼ばれるトレーニング方法を使用して自動化するように設計されています。同社はまた、逐次テキスト生成ではなく並列スコアリングについても説明しています。TypeSafe の発表
実際には、このケースはどのカテゴリーに属するのか、与えられた基準に従ってそれをどのように評価するのか、提供された情報が特定のステートメントを裏付けるかどうかなど、明確に定義された質問が含まれます。
ジェブはどのように機能しますか?データ、質問、結果
モデルの操作は、ドキュメントでは次のように呼ばれるコンテキストを提供することから始まります。 状態。これは、たとえば、AI アシスタントの応答、記事の抜粋、顧客の質問などです。
このコンテキストに質問を追加します。 Jev は 3 つの基本的なタイプをサポートしています。
| タイプ | 目的 | コンテンツ作品での使用例 |
|---|---|---|
| 選択 | 指定されたオプションの 1 つを選択する | 質問をトピックに割り当てる: 価格、実装、比較、またはサポート |
| スコア | 記載された順序付けられたレベルに基づく評価 | フラグメントが質問にどの程度よく答えているかの評価 |
| 新しい | 発言が真実である確率 | 提供されたテキストに価格条件が含まれているかどうかを確認します |
1 回の通話で複数の質問を組み合わせることができます。それぞれが同じコンテキストに対して独立して評価されます。 ジェブの紹介
したがって、最も重要な作業はモデルを起動する前に行われます。つまり、何を測定するかを正確に決定する必要があります。
Jev は GEO および AEO とどのような関係がありますか?
GEO は、生成 AI 応答におけるブランドの可視性とそのコンテンツの取り組みに関連しています。 AEO は、ユーザーの質問に効果的に回答し、応答システムで利用できる情報を準備することに重点を置いています。
どちらの領域でも、多くの反復分析が必要になります。
- 潜在的な顧客はどのような質問をしますか?
- AI の応答はその会社を推奨しますか、それともその名前を言及するだけですか?
- この記事はタイトルに記載されている問題を実際に解決しますか?
- 編集者によるレビューが必要なセクションはどれですか?
Jev は、そのようなタスクを実行するツールのコンポーネントにすることができます。ただし、その結果は ChatGPT または Google に引用される可能性の尺度ではありません。
以下のアプリケーションは、モデルの動作に基づいた Semly からの編集提案です。これらは、テストの結果や、Jev と Semly の統合が完了したことを表すものではありません。
1. お客様からの質問の整理
検索エンジン、営業上の会話、顧客サービスからのクエリのリストは、すぐに閲覧するのが困難になります。質問によっては、表現が異なっていても、同じ問題を扱っているものもあります。
Jev を使用すると、以前に定義したカテゴリに質問を割り当てることができます。
WordPress で Web サイトを運営している会社の場合、この部門は次のようになります。
| 質問 | 提案されたカテゴリー |
|---|---|
| ウェブサイトの毎月の維持費はいくらですか? | 価格 |
| サブスクリプションには何が含まれますか? | サービス範囲 |
| サイトを新しい代理店に移管するにはどうすればよいですか? | 連携開始 |
| サブスクリプションと時間課金のどちらが良いでしょうか? | オプションの比較 |
これは予想される分類方法を示すものであり、モデル呼び出しの結果ではありません。
整理されたリストは、どのニーズがサイトですでに満たされているか、どのニーズに新しい資料が必要かを認識するのに役立ちます。ただし、カテゴリは実際の質問、特に複数のグループに当てはまる質問に対してチェックする必要があります。
2. AI回答における言及と推奨の区別
会社名が登場するだけでは、それがどのように表現されているかについてはほとんどわかりません。
2 つの文を比較します。
X 社は、他のいくつかのプロバイダーと協力してこの市場で事業を行っています。
説明されているアプリケーションについては、サービスの範囲から X 社を検討する価値があります。
一つ目は言及です。 2 番目のセクションには、推奨事項とその根拠が含まれています。
提案された分析プロセスでは、Jev は記録された応答を明確に定義されたカテゴリに従って分類できました。ブランドの存在、推奨事項、アシスタントが提供するソースへのリンクもチェックする価値があります。これらは異なる情報です。
モデルは分析用のマテリアルを受け取る必要があります。引用を評価している場合は、出典のリストも提供してください。リンクのないテキストに基づいて、アシスタントがどのアドレスを示したかを確実に判断することは不可能です。
3. 内容が質問に答えているかどうかの評価
記事に適切なタイトルが付いていても、有用な答えが得られない場合があります。
「WordPress サイトの維持にはいくらかかりますか?」というガイドを分析していると仮定しましょう。 「価格は多くの要因に依存する」という一般的な記述では、何がコストを構成するのかが読者に説明されません。
評価には 3 つの記述レベルを用意できます。
- 文章は質問に答えていない
- テキストにはコスト構成要素が示されていますが、前提条件は説明されていません。
- 本文では、原価構成要素とその解釈に必要な条件について説明します。
これは、スコア タイプのタスクの例です。ドキュメントでは、特定の状況を説明し、一度に 1 つの側面を評価することを推奨しています。したがって、応答の完全性、オファーの遵守、例の存在を個別に分析する価値があります。スコアに関するドキュメント
このようにして得られた評価は、編集作業を整理するのに役立ちます。これを「Googleのランキング結果」や「AIによる引用の可能性」と呼ぶべきではありません。
4. 確認が必要な材料の選定
出版物の数が多い場合、注意が必要なセクションを事前に示すと便利です。
テキストに次の内容が含まれているかどうかを確認するためのチェック質問を設計できます。
- 結果の具体的な約束
- 価格または納期
- 競合他社との比較
- 顧客の結果に関するクレーム
このような分析は、資料を適切な人に送るのに役立ちます。ファクトチェックに代わるものではありません。
記事がオファーに準拠しているかを評価したい場合は、現在のオファーも必要です。モデルは、企業が実際にサービスを提供しているかどうかを 24 時間以内に推測すべきではありません。
ジェブは間違っているでしょうか?
TypeSafe通信では「幻覚ゼロ」という言葉が出てきます。その範囲を理解することが重要です。メーカーはそれを、結果が特定のタイプおよび応答パターンに準拠しているかどうかに関連付けます。正しい形式が自動的に正しい判断を意味するわけではありません。メーカーの説明
モデルは、許可されたカテゴリの 1 つを選択しても、ケースを間違ったカテゴリに割り当てることができます。
Choice と Score の場合、Jev は確率分布と 自信 インジケーター。ドキュメントでは、この指標は回答の分布から得られると説明されています。 0.9 という値を 90% の精度が自動的に保証されると解釈すべきではありません。 Noul には別のフィールドがありません 自信. 応答の信頼性に関する文書化
GEO アプリケーションでは、これは、サンプルをレポートで使用する前に、サンプルの手動評価と結果を比較する必要があることを意味します。
Jev を使い始めるにはどうすればよいですか?
TypeSafe は、ログイン、データの入力、質問の定義ができるプレイグラウンドを提供します。 API は、モデルを独自のツールに接続するために使用されます。メーカーは SDK の使用についても説明しています。スタートガイド
最初のテストは 1 つのタスクに限定する必要があります。たとえば:
- 1 つの業界に関連する 50 件の記録された AI 応答を収集する
- 指定したブランドの推奨事項を含むものを手動でマークします
- 推奨事項と通常の言及を区別する基準を保存します
- Jev を使用して分類を実行する
- 結果を比較し、不一致を分析する
- 基準を調整した後、新しい例で別のテストを実施します
50 という数字は小規模なパイロット向けの提案であり、検証基準ではありません。このようなテストにより、大規模な統合を構築する前にアイデアの有用性を評価できます。
WordPress サイト所有者は、すぐに Jev を実装する必要はありません。これは主に、プロセスとソフトウェアを構築するためのツールです。コンテンツ分析システムのバックエンドでは機能しますが、ブログを運営するためのすぐに使えるソリューションではありません。
スピードと低コストの約束についてはどうでしょうか?
TypeSafe は、選択された自動化タスクにおける Jev の大きな利点を示す比較を公開しています。ただし、最も印象的な結果は、実際に達成可能な利益の上限に相当する可能性があると同社は指摘しています。テストと制限事項の説明
マーケティング チームにとって、賢明なテストとは、特定の数の回答を分析するためのコスト、かかった時間、修正が必要なケースの数などの独自のプロセスです。
割り当てたいタスクに対して十分な精度がある場合、迅速な分類は価値があります。
Jev と GEO に関するよくある質問
Jev はブログ記事を書きますか?
Jev は構造化された意思決定を目的としており、フリーテキストを書くためのものではありません。編集プロセスでは、資料の評価または分類ツールとして機能します。
Jev にページを配置できますか?
TypeSafe が説明する製品は、ユーザーにページランキングを提示する検索エンジンではありません。 GEO の賢明なアプリケーションは、分析をサポートすることであり、「Jev 内」での位置を競うことではありません。
Jev で記事の評価が高いということは、ChatGPT がその記事を引用することを意味しますか?
いいえ、評価は定義された基準と提供されたデータに基づいています。これは、別の AI システムによって行われる決定を予測するものではありません。
説明されているアプリケーションの機能は Semly ですか?
提示されたシナリオは、Jev を使用するための提案です。この記事は、モデルと Semly の統合についての発表または確認を構成するものではありません。
新しいモデルから特定のタスクまで
GEO と AEO における Jev の最も興味深い応用は、適切に設定された質問から始まります。言及と推奨を一貫して区別できるでしょうか?質問に答えていないテキストを特定しますか?何百もの顧客からの問い合わせを整理しますか?
その場合、Jev がこの作業を効率化するかどうかを確認できます。基準が不明確な場合は、まず評価方法を改善する価値があります。
また、自分の会社から始めたい場合は、AI の応答にどのように表示されるかを確認してください。
情報状況:2026年9月24日 Jevの動作はTypeSafe資料に基づいています。 GEO および AEO のアプリケーションの例は編集提案であり、モデル テストの結果ではありません。
共有:
