更新日: 2026年10月20日
数百件のAI回答を確認し、自社を推奨している回答、名前に触れるだけの回答、サービス内容を誤って説明する回答を見分けたいとします。ブランド名の出現回数だけでは判断できません。繰り返し使える評価方法が必要です。
TypeSafe AIのJevは、その工程で評価モデルとして使える可能性があります。資料と範囲を明確にした質問を受け取り、プログラムが比較、集計し、次の作業に振り分けられる結果を返します。GEOでは、生成AIの回答分析を支える仕組みとして役立つ可能性があります。
最も大切な注意点は、モデルが評価するのは渡された資料だけだということです。その結果は、インターネット全体でのブランドの可視性を証明しません。本記事は考えられる用途と検証方法を説明するもので、Jevの実測テストやSemlyとの連携を確認した記事ではありません。
Jevとは何か。GEOとどう関係するのか?
TypeSafeはJevを、素早く範囲を絞った評価を行うSystem Oneモデルと説明しています。記事や長い分析を書く代わりに、質問に対して構造化された回答を返します。入力の基本は、APIで「state」と呼ぶ文脈と、評価対象の説明です。出典: Jevの概要。
GEOはGenerative Engine Optimizationの略で、生成AIの回答におけるブランドやコンテンツの存在感を高める取り組みです。Jevは判断材料の整理を支援できますが、検索エンジンのように順位を獲得する場ではありません。ChatGPT、Gemini、Perplexityの回答を収集するシステムの代わりにもなりません。
役割は、別の工程で回答と出典を収集し、Jevが特定の特徴を評価し、プログラムがルールを適用し、人が解釈の必要な事例を確認する、と分けると明確です。その後にページの改善文を書く場合は、別の編集作業になります。
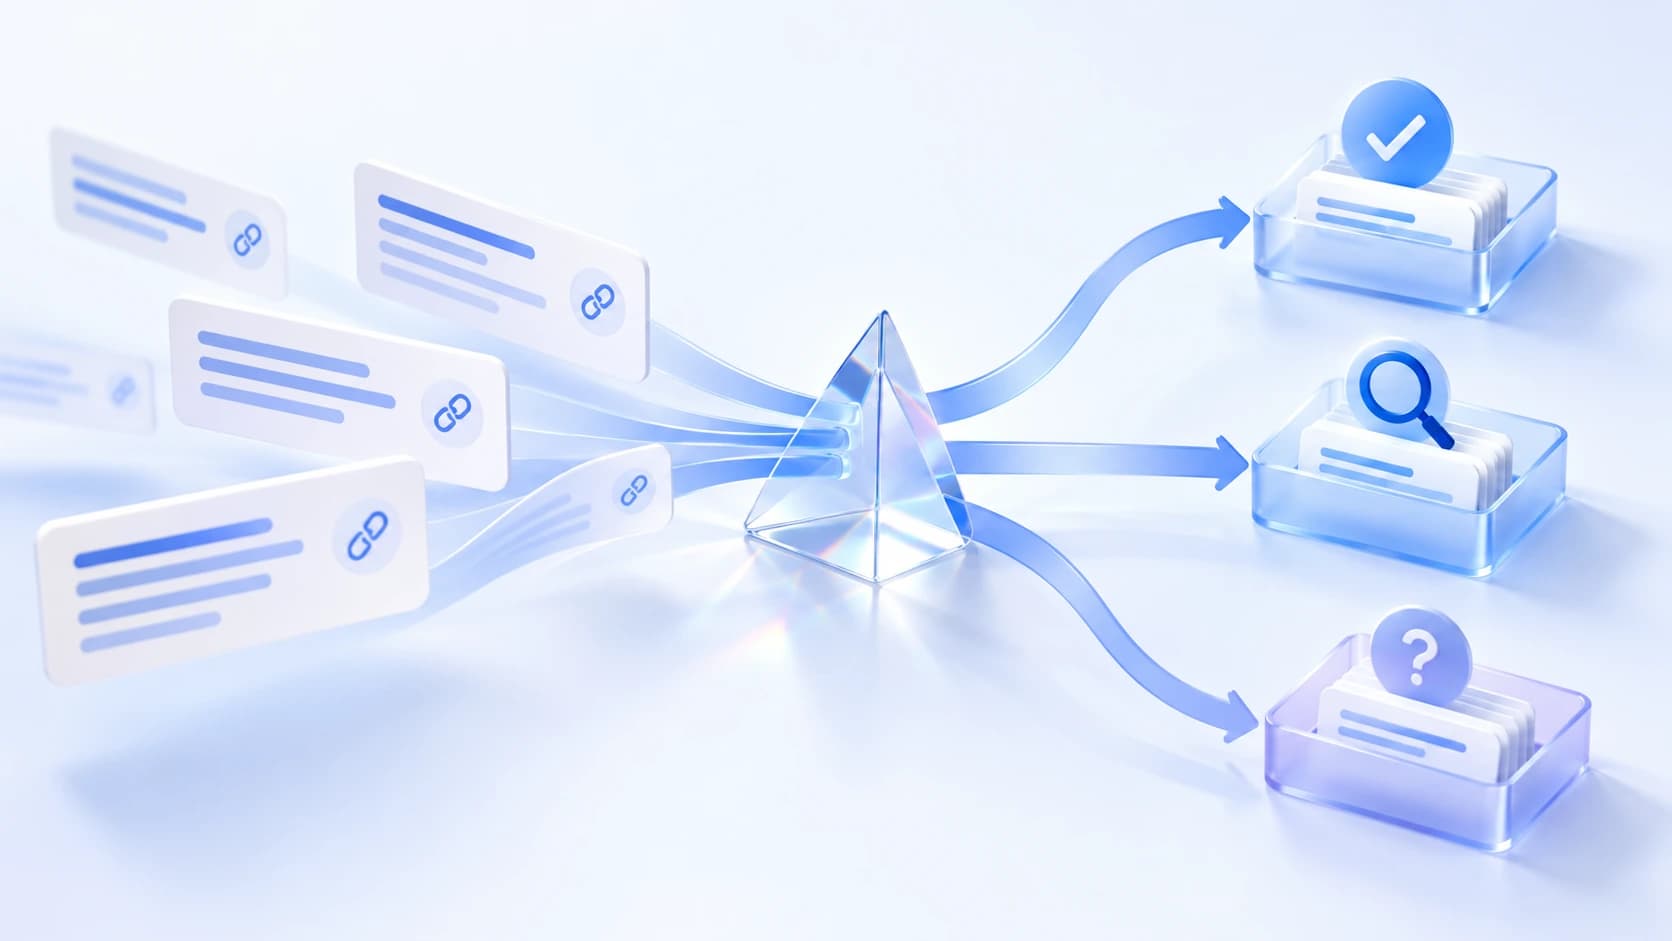
概念図: 回答の保存、独立した質問、結果の確認。TypeSafeの文書を基に独自に作成しました。アニメーションは提案する工程を示し、完成した連携機能の動作を示すものではありません。
Choice、Score、Noul: 質問する3つの方法
実際に下したい判断に合わせて質問形式を選びます。「この回答は良いか?」では範囲が広すぎます。推奨の有無、事実との一致、顧客の条件に対する回答の完全性などに分けられます。
| 種類 | どんな質問か | GEOでの例 |
|---|---|---|
| Choice | 指定した分類のどれか? | 中立的な言及、推奨、非推奨。 |
| Score | 定義した尺度のどの水準か? | 回答なし、一部の回答、全条件への回答。 |
| Noul | 指定した命題は真か? | 回答は対象ブランドを明確に推奨しているか? |
Choiceは指定した選択肢から1つを選びます。分類は互いに区別できるものとし、境界事例も基準に含めます。推奨の有無とサービス内容との一致など、複数の特徴を評価する場合は質問を分けます。Choiceの文書。
Scoreには、順序のある水準の説明が必要です。「回答していない」「一部に回答」「指定された全条件に回答」の方が、尺度の説明がない「品質1〜10」より明確です。結果は、あなたが定義した品質に対する評価です。Scoreの文書。
Noulは「はい」の確率を返します。0.5に近い値は不確実性を示し、条件を半分満たすという意味ではありません。「はい」が何を意味するかを質問で明示します。Noulの文書。
2026年10月時点で何が最新か?
10月20日に確認した文書では、最新の掲載バージョンは2026年10月14日公開のJev 1.14です。文書ではバージョン識別子と、参照先が変わる「latest」「preview」の別名を区別しています。別名の変更で結果も変わり得るため、テスト時には実際のモデルのバージョンを記録します。Jevのモデルとバージョン。
1.14の告知では、画像、より大きいコンテキスト、型「box」の実験的な対応も説明されています。提供元は、これらの本番利用への準備が限定的であるとしています。そのため、ここで説明するテキスト評価工程では使用を前提にしていません。TypeSafeの10月14日の告知。
結果の形式が正しくても、評価が正しいとは限りません。モデルは許可された分類を返しながら、誤った事例に割り当てることがあります。
GEOとSEOにおけるJevの7つの用途
以下はモデルの活用案です。Semlyの機能一覧や導入実績ではありません。どの用途も基準を定義し、実際の目的に合った資料で精度を確認する必要があります。
1. 言及、推奨、非推奨を区別する
「ブランドXはこの市場で事業を行っている」と「この用途ならブランドXを検討するとよい」は同じではありません。「ブランドXはこの用途に対応していない」も別の意味です。すべてに企業名が出ますが、その文脈で推奨しているのは1つだけです。
Jevに、特定のブランドに対する回答の姿勢を評価させることが考えられます。推奨には条件が付くため、利用者の質問全文も渡します。小規模店舗には適していても、大企業の要件を満たさない製品もあります。
名前の出現、肯定的な推奨、リンクは別々に記録します。メーカーのサイトへのリンクは、推奨にも批判的な評価にも付く場合があります。
サンプルデータは方法を説明するためのもので、いかなるブランドの測定結果も示していません。アニメーションと以降の例のラベルは編集時に作成したもので、Jevの実行結果ではありません。本文でも同じ点を示しています。中立的な言及、推奨、非推奨は、リンクの有無とは別の評価です。
2. 主張と出典の一致を事前評価する
URLの検出自体は通常、プログラムのルールで行うとよい作業です。判断を要するのは、出典の特定の箇所がAI回答の特定の一文を裏付けるかどうかです。
複数の約束を含む文は、個々の主張に分けます。それぞれに適切なページの抜粋、サービス範囲、閲覧日を添えます。出典を取得できなければ資料不足として記録し、「出典による裏付けがない」という評価に置き換えません。
設計した質問に応じて、モデルが一致、矛盾、要確認を予備的に示せます。監査の詳しい方法は別記事で説明しています。引用された出典は企業情報を裏付けているか?。
3. 顧客の質問を整理する
価格、導入、制限、サービス比較の質問には、それぞれ異なる回答が必要です。分類すると分析対象を整理し、担当者へ割り当てやすくなります。
1つの質問に複数の意図があるかを決めます。「導入費はいくらで、移行も含まれるか?」は価格と範囲の両方です。2つの作業に分けるか、両面を別々に評価できます。1つの分類への強制的な割り当ては、重要なニーズを隠すことがあります。
質問数から需要の規模を自動的に推測しないでください。似た表現が多くても、同じ出所から生まれた1つのニーズかもしれません。
4. ページが質問の条件に答えているか確認する
顧客が、特定用途、特定の連携、予算上限を満たす製品を探しているとします。ページには製品説明があっても、互換性の説明がありません。モデルは、定義した完全性の尺度に沿って、この不足を予備的に示せます。
各条件を別々に評価します。連携の情報がないことは、製品が非対応であるという意味ではありません。提供された文章では判断できないという意味です。次に事実を確認し、読者の役に立つなら説明を補います。
高いScoreはGoogleの順位指標でも、ChatGPTに引用される確率でもありません。自分で定めた基準による、特定資料の評価です。
5. カニバリゼーションを確認すべきページの組を選ぶ
まずテーマ、検索クエリ、文章の類似性から候補の組を選びます。その後、同じニーズに答えているのか、異なる判断を助けているのかを評価できます。
モデルには、両ページの主な質問、対象読者、本文を渡します。タイトルの単語が似ているだけでは不十分です。結果は編集者の確認リストに使います。統合の判断には、各ページの価値、流入、サイト内での役割の検討が必要です。
実用的なテーマの分け方は、ブログとナレッジベースのカニバリゼーションを防ぐ方法で説明しています。
6. 内部リンク案の意味を評価する
リンク候補のうち、読者の次の行動を助けるものを選びます。製品選びの記事なら、意思決定後に必要となるデータ準備の手順へつなげられます。
モデルへの質問は、特定の段落でそのリンクが役に立つかを問うものにします。テーマの近さだけでは不十分です。URLが開くかはプログラムで、リンク文言の自然さは編集者が別途確認できます。
7. 約束や比較を確認担当者へ回す
公開前に、価格、期限、成果保証、競合比較を含む箇所を抽出できます。こうした検出は、最新のサービス内容を知る担当者へ文章を回す助けになります。
これは確認工程であり、真実であるとの自動認定ではありません。信頼できる出典がなければ、企業が本当に1日でサービスを開始できるかをモデルは判断できません。出典がない記事には編集作業が必要です。
検証できる工程をどう設計するか?
まず、特定ブランドの推奨を判別するなど、1つの作業から始めます。推奨の定義、除外事例、不完全な回答の扱いを書き出し、その後に自動化を組み立てます。
元の資料を、質問、AI製品名、モード、言語、日付と一緒に保存します。切り出した一文と回答全体では、評価が変わる可能性があります。回答なし、取得エラー、ブランドのない回答には、それぞれ別のラベルを使います。
同じ資料への独立した複数の質問は、1つのリクエストで送れます。結果はプログラムのルールで組み合わせます。次の質問に最初の結果を受けて取得するデータが必要なら、工程を分けます。TypeSafeの質問設計の原則。
資料 -> 個別の質問 -> ルール -> 結果または人の確認。
出典不足 -> 資料を補う。不確かな評価 -> 検証。定義変更 -> 再テスト。
レポートには評価だけでなく基準のバージョンも保存します。推奨の定義を変えたら、比較期間を同じルールで再計算するか、比較可能性が途切れたことを明示します。そうしないと分類器の改善が、ブランド可視性の上昇に見えてしまいます。
Confidenceは正答率の保証ではない
ChoiceとScoreについて、文書では確率分布から計算する「confidence」フィールドを説明しています。これはモデルの判断がどれだけ一方に定まっているかを示す情報です。0.9を、自社のAI回答における検証済みの90%の正答率と自動的に解釈してはいけません。Noulは別の「confidence」フィールドを返しません。TypeSafeによる確信度の説明。
人の確認へ回す閾値は、対象作業のテストを基に決めます。待ち行列の並べ替えと、顧客向けレポートに評価を使う場合では、必要な水準が異なり得ます。高い確信度でも品質確認は必要です。
不確かな事例を、件数を示さず測定から除外しないでください。ある言語で判断できない回答が多ければ、容易な事例だけのレポートは比較を歪める可能性があります。
精度の確認方法: 120件の回答による例
サンプルデータでは、編集者が120件の回答を評価しました。モデルは30件を推奨と判定し、編集者との比較で24件が正しく、6件が誤りでした。さらに、推奨8件を見逃しました。
| モデルの評価 | 編集者の判断: 推奨あり | 編集者の判断: 推奨なし |
|---|---|---|
| 推奨あり | 正しく検出: 24件 | 誤検出: 6件 |
| 推奨なし | 見逃した推奨: 8件 | 正しく推奨なしと判定: 82件 |
| 合計 | 32件 | 88件 |
この場合の適合率は24 / 30 = 80%です。検出した推奨の5件に1件が誤検出となります。編集者の評価では実際の推奨が合計32件あるため、再現率は24 / 32 = 75%です。モデルは4分の1を見逃しています。
全体の一致率は106 / 120、約88.3%です。回答の大半に推奨がなかったため、こちらの数値は良く見えます。この値だけでは分類器の有用性は判断できません。
実務では、基準調整用の例と最終確認用のデータを分けます。否定、条件付き推奨、似た企業名、不完全な出典も含めます。一部は2人で評価します。意見の不一致から、モデル評価の前に定義の曖昧さが見つかることがあります。
120という件数は計算の説明用で、検証の標準ではありません。標本数と許容誤り率は目的次第です。ポーランド語の資料はポーランド語で検証します。TypeSafeは、現時点で英語が最も高い精度を得られる言語と説明しています。文書の言語対応。
Jevの費用とGEO工程全体の費用はいくらか?
2026年10月20日に確認したモデル料金は、入力100万トークン当たり0.042米ドルです。トークンはAPIが課金に使うテキストの単位です。文書によると出力トークンは無料です。これは確認日現在の提供元の料金で、将来の価格保証ではありません。モデル文書の料金。
サンプルデータとして、2000件の回答を評価し、各リクエストの入力が文脈と質問を含め平均1200トークンとします。計算は2000 × 1200 = 2,400,000トークン、2.4 × 0.042米ドル = 0.1008米ドルです。この工程の費用は約0.10米ドルとなります。
これは想定入力サイズによる計算で、実際のAPI実行の測定ではありません。同じ規模で全件を再評価すれば約0.20米ドルに倍増します。文脈が長くなる場合や再試行でも消費は増えます。
| 工程 | 約0.10米ドルに含むか? | 考慮すること |
|---|---|---|
| Jevでの評価 | はい。例の前提による | 実際の入力トークン数。 |
| AI回答の取得 | いいえ | API、収集サービス、または手作業。 |
| 出典の取得と保存 | いいえ | ページへのアクセス、文章抽出、保存。 |
| 品質確認 | いいえ | 標本へのラベル付け、相違、人の確認。 |
| コンテンツ変更の準備 | いいえ | 編集、事実確認、実装。 |
したがって、分類が安くてもGEOのモニタリング全体が数セントで済むとは限りません。工程全体の費用と、正しく有用な結果を得る費用を比較します。毎回手作業で修正するなら、1回の評価の低価格は意味を失いかねません。
提供元のベンチマークが証明しないこと
TypeSafeの公開評価ページは、4つの自動化工程を説明しています。他のモデルが付けた参照ラベルを基準にモデルを評価します。特定のテスト設計内での比較であり、ポーランド語のGEOにおけるJevの精度を独立に評価したものではありません。TypeSafeの評価方法。
このようなグラフの1つの数値を、ブランド推奨、カニバリゼーション検出、引用の整合性へそのまま転用しないでください。Jevの使用が企業への推奨数を増やすことも証明しません。その主張には、可視性の変化と測定条件の別途の評価が必要です。
JevはGoogleやChatGPTでの引用獲得に役立つか?
コンテンツの不足を見つけたり、回答評価を整理したりする助けにはなります。しかしモデルを動かすだけで、外部の検索エンジンがページを読み、価値を認め、回答で引用するわけではありません。
Googleは、AI OverviewsとAI Modeで出典として表示されるためにもSEOの基本が適用されると説明しています。ページはインデックスに登録され、テキストスニペット付きで表示される資格を持つ必要があります。条件を満たしても表示の保証はありません。これはGoogleの機能向けの指針であり、全アシスタント共通の仕様ではありません。Google Search Central: AI機能とウェブサイト。
ページ改善では、条件を補い、制限を説明し、出典を加え、似た記事を区別するなど、読者への回答を良くするために評価を使います。Googleは読者を第一にした有用なコンテンツを推奨しています。スパムポリシーは、検索結果の操作を主目的とする大量生成コンテンツも対象とします。有用なコンテンツとスパムポリシー。
自社では何から始めればよいか?
まず、答えが必要な事業上の質問を決めます。AIがブランドを推奨しているか、サービスを事実どおりに説明しているか、出典が個々の主張を支えるか。それぞれ異なる基準が必要です。
始めたばかりなら、企業の登場状況を調べ、回答全文を読みます。評価したい内容が分かったら、人がラベルを付けた標本を準備します。繰り返し発生する作業で、正しい結果の見分け方を説明できる場合に、Jevを試す価値があります。
JevとGEOのよくある質問
JevはGEO向けの記事を書けるか?
Jevの用途は構造化された評価であり、自由形式の記事執筆ではありません。提案する工程では文章の特定の特徴を評価できます。コンテンツの作成と編集は別の作業です。
JevはChatGPTの回答を自動で調べるか?
本記事の工程では、回答と必要な文脈をこちらから渡します。回答の収集、出典の保存、測定条件の記録には別の処理が必要です。
Jev内で企業の順位を上げられるか?
本記事で扱うJevは、顧客に企業ランキングを示す検索エンジンではありません。可視性向上の取り組みに使う資料の分析を支援できます。
確信度が高ければ人の確認は不要か?
対象作業で検証した精度と、誤りの影響次第です。モデルの確信度だけでは正しさを証明できません。確認経路を残し、自動承認した結果も定期的に点検します。
SemlyはJevを使っているか?
本記事はSemlyでのJev導入を確認するものではありません。GEOとSEO分析におけるモデルの活用案、制限、テスト案を示しています。
文書と出典は2026年10月20日に確認しました。機能と料金の説明はTypeSafeの資料に基づきます。用途、図、サンプルデータは編集上の作成物であり、Semlyのブランドや顧客の結果を示すものではありません。