

Sprawdź widoczność swojej firmy w AI
Za darmo, bez karty kredytowej.
Zaktualizowano dnia 20 października 2026 r.
Masz kilkaset odpowiedzi AI do przejrzenia. Chcesz ustalić, które polecają Twoją firmę, które tylko wymieniają nazwę, a które przekazują błędną informację o ofercie. Sam licznik wystąpień marki tego nie wyjaśni. Potrzebujesz powtarzalnego sposobu oceny.
Jev od TypeSafe AI może pełnić w takim procesie rolę modelu oceniającego. Otrzymuje materiał oraz ściśle określone pytania, a następnie zwraca wyniki, które program może porównać, policzyć i skierować do dalszej pracy. W GEO jest to potencjalnie przydatne zaplecze analizy odpowiedzi generatywnej AI.
Najważniejsze zastrzeżenie: model ocenia to, co mu przekażesz. Wynik nie jest dowodem, że marka ma określoną widoczność w całym internecie. Ten poradnik opisuje możliwe zastosowania i sposób ich sprawdzenia. Nie przedstawia testu Jev ani potwierdzonej integracji z Semly.
Czym jest Jev i co ma wspólnego z GEO?
TypeSafe opisuje Jev jako model z kategorii System One, przeznaczony do szybkich, wąskich ocen. Zamiast pisać artykuł lub obszerną analizę, zwraca ustrukturyzowaną odpowiedź na zadane pytanie. Podstawą jest kontekst, nazywany w API „state”, oraz opis tego, co należy ocenić. Źródło: wprowadzenie do Jev.
GEO, czyli Generative Engine Optimization, obejmuje pracę nad obecnością marki i treści w odpowiedziach generatywnej AI. Jev może pomóc przy porządkowaniu materiału, na którym opierasz decyzje. Nie jest miejscem, w którym zdobywasz pozycję jak w wyszukiwarce. Nie zastępuje też systemu zbierającego odpowiedzi ChatGPT, Gemini czy Perplexity.
Przydatne rozdzielenie ról wygląda tak: osobny proces zbiera odpowiedzi i źródła, Jev ocenia określone cechy, program stosuje reguły, a człowiek sprawdza przypadki wymagające interpretacji. Jeżeli później trzeba napisać poprawiony fragment strony, jest to następne zadanie redakcyjne.
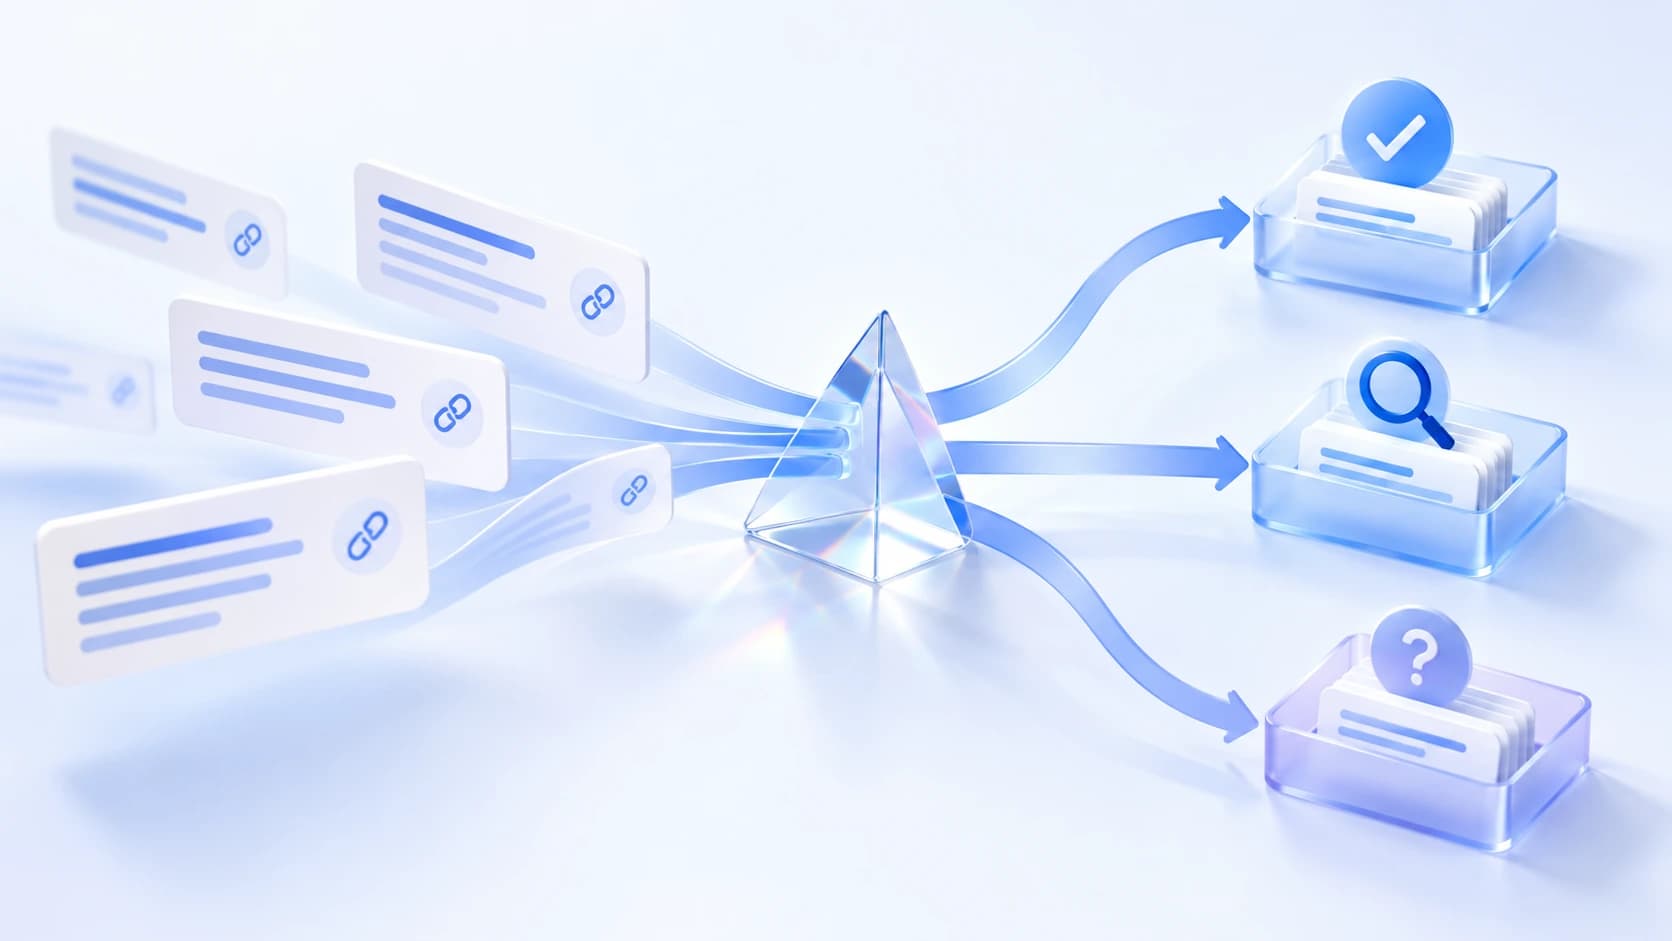
Schemat poglądowy: zapis odpowiedzi, niezależne pytania i kontrola wyniku. Opracowanie własne na podstawie dokumentacji TypeSafe. Animacja pokazuje proponowany proces, nie działanie gotowej integracji.
Choice, Score i Noul: trzy sposoby zadawania pytań
Dobierz typ pytania do decyzji, którą rzeczywiście chcesz podjąć. Pytanie „czy ta odpowiedź jest dobra?” jest zbyt szerokie. Można je rozbić na obecność rekomendacji, zgodność faktów oraz kompletność odpowiedzi na potrzebę klienta.
| Typ | Jakie pytanie? | Przykład w GEO |
|---|---|---|
| Choice | Która z opisanych kategorii? | Neutralna wzmianka, rekomendacja lub odradzenie. |
| Score | Który poziom opisanej skali? | Brak odpowiedzi, częściowa odpowiedź lub komplet warunków. |
| Noul | Czy wskazane stwierdzenie jest prawdziwe? | Czy odpowiedź wyraźnie poleca wskazaną markę? |
Choice wybiera jedną kategorię z podanego zestawu. Kategorie powinny się rozróżniać, a kryteria obejmować przypadki graniczne. Jeśli oceniasz kilka cech, np. rekomendację i zgodność z ofertą, zadaj osobne pytania. Dokumentacja Choice.
Score wymaga opisania uporządkowanych poziomów. „Nie odpowiada”, „odpowiada częściowo” i „odpowiada na wszystkie wskazane warunki” dają czytelniejsze kryterium niż ocena „jakość 1-10” bez wyjaśnienia skali. Wynik dotyczy Twojej definicji jakości. Dokumentacja Score.
Noul zwraca prawdopodobieństwo odpowiedzi „tak”. Wartość bliska 0,5 sygnalizuje niepewność, a nie częściowe spełnienie warunku. Pytanie musi jasno wskazywać, co oznacza „tak”. Dokumentacja Noul.
Co jest aktualne w październiku 2026?
Według dokumentacji sprawdzonej 20 października najnowszą opisaną wersją jest Jev 1.14, dostępny od 14 października 2026. Dokumentacja rozróżnia identyfikatory wersji i ruchome aliasy „latest” oraz „preview”. Przy testowaniu zapisuj faktyczną wersję modelu, ponieważ zmiana aliasu może zmienić wyniki. Modele i wersje Jev.
W komunikacie o wersji 1.14 TypeSafe opisuje również eksperymentalną obsługę obrazów, większego kontekstu i typu „box”. Producent zaznacza ograniczoną gotowość tych funkcji do zastosowań produkcyjnych. Dlatego tekstowy proces oceny opisany tutaj nie zakłada ich wykorzystania. Komunikat TypeSafe z 14 października.
Poprawny format wyniku nie gwarantuje poprawnej oceny. Model może zwrócić dozwoloną kategorię i przypisać ją niewłaściwemu przypadkowi.
7 zastosowań Jev w GEO i SEO
Poniższe scenariusze są propozycjami zastosowania modelu, a nie listą funkcji Semly ani wynikami wdrożeń. Każdy wymaga zdefiniowania kryteriów i sprawdzenia trafności na materiale odpowiadającym Twojemu zadaniu.
1. Rozróżnianie wzmianki, rekomendacji i odradzenia
Zdanie „marka X działa na tym rynku” nie znaczy tego samego co „do tego zastosowania warto rozważyć markę X”. Jeszcze inny sens ma „marka X nie obsługuje tego zastosowania”. W każdym z nich występuje nazwa firmy, ale tylko jedno stanowi polecenie w opisanym kontekście.
Jev można poprosić o ocenę stosunku odpowiedzi do konkretnej marki. Do kontekstu dołącz pełne pytanie użytkownika, ponieważ rekomendacja bywa warunkowa: produkt może pasować do małego sklepu, ale nie spełniać wymagań dużej organizacji.
Obecność nazwy, pozytywne polecenie oraz link zapisuj oddzielnie. Link do strony producenta może towarzyszyć zarówno rekomendacji, jak i krytycznej ocenie produktu.
Dane przykładowe służą objaśnieniu metody i nie przedstawiają wyników żadnej marki. Etykiety w animacji i dalszych przykładach są przygotowane redakcyjnie, nie pochodzą z wywołań Jev. Tę samą informację pokazujemy w tekście: neutralna wzmianka, polecenie i odradzenie to różne oceny niezależnie od obecności linku.
2. Wstępna ocena zgodności twierdzenia ze źródłem
Samo wykrycie URL-a zwykle warto wykonać regułami w programie. Pytanie wymagające oceny brzmi: czy konkretny fragment źródła wspiera konkretne zdanie odpowiedzi AI?
Rozbij zdanie z kilkoma obietnicami na pojedyncze twierdzenia. Do każdego dołącz właściwy fragment strony, zakres oferty i datę odczytu. Jeżeli źródła nie udało się pobrać, oznacz brak materiału. Nie zamieniaj go w ocenę „źródło nie potwierdza”.
Model może wstępnie wskazać zgodność, sprzeczność lub potrzebę sprawdzenia, zależnie od zaprojektowanych pytań. Pełny sposób audytu opisujemy osobno: czy cytowane źródła potwierdzają informacje o firmie?.
3. Porządkowanie pytań klientów
Pytania o cenę, wdrożenie, ograniczenia i porównanie ofert wymagają innych odpowiedzi. Klasyfikacja pomaga ułożyć listę do analizy i przypisać ją do odpowiedzialnych osób.
Ustal, czy jedno pytanie może mieć kilka intencji. „Ile kosztuje wdrożenie i czy obejmuje migrację?” dotyczy jednocześnie ceny i zakresu. Możesz rozdzielić je na dwa zadania lub oceniać oba wymiary osobno. Jedno wymuszone przypisanie potrafi ukryć ważną potrzebę.
Z liczby pytań nie wyciągaj automatycznie wniosku o wielkości popytu. Dużo podobnych sformułowań może pochodzić z tego samego źródła i dotyczyć jednej potrzeby.
4. Sprawdzanie, czy strona odpowiada na warunki pytania
Klient pyta o rozwiązanie do określonego zastosowania, z konkretną integracją i ograniczeniem budżetu. Strona opisuje produkt, ale nie wyjaśnia kompatybilności. Model może wstępnie wskazać ten brak według opisanej skali kompletności.
Osobno oceniaj każdy warunek. Brak informacji o integracji nie znaczy, że produkt jej nie obsługuje. Oznacza, że dostarczona treść nie rozstrzyga pytania. Następnym krokiem jest sprawdzenie faktu i uzupełnienie opisu, jeśli informacja będzie przydatna czytelnikowi.
Wysoki Score nie jest wynikiem rankingowym Google ani prawdopodobieństwem cytowania przez ChatGPT. To ocena konkretnego materiału według Twoich kryteriów.
5. Wskazywanie par stron do kontroli kanibalizacji
Najpierw wybierz pary kandydatów na podstawie tematyki, zapytań lub podobieństwa treści. Potem można ocenić, czy odpowiadają na tę samą potrzebę, czy pomagają w różnych decyzjach.
Model powinien otrzymać główne pytanie, odbiorcę i treść obu stron. Zbieżne słowa w tytule to zbyt mało. Wynik ma tworzyć listę do przeglądu redakcyjnego. Decyzja o połączeniu stron wymaga uwzględnienia ich wartości, ruchu i roli w serwisie.
Praktyczny podział tematów opisaliśmy w poradniku blog i baza wiedzy bez kanibalizacji.
6. Ocena sensu proponowanego linku wewnętrznego
Spośród kandydatów do podlinkowania wybierz te, które pomagają wykonać następny krok. Artykuł o wyborze rozwiązania może prowadzić do instrukcji przygotowania danych, jeżeli czytelnik potrzebuje jej po podjęciu decyzji.
Pytanie dla modelu powinno dotyczyć użyteczności połączenia w konkretnym akapicie. Sama bliskość tematów nie wystarczy. Program może osobno sprawdzić działanie URL-a, a redaktor naturalność tekstu odsyłacza.
7. Kierowanie obietnic i porównań do sprawdzenia
Przed publikacją można oznaczać fragmenty zawierające ceny, terminy, gwarancje rezultatu lub porównania konkurentów. Takie wykrywanie pomaga skierować tekst do osoby znającej aktualną ofertę.
To etap kontroli, nie automatyczne potwierdzenie prawdziwości. Model nie ustali, czy firma rzeczywiście uruchamia usługę w jeden dzień, jeżeli nie dostanie wiarygodnego źródła tej informacji. Jeśli nie ma źródła, artykuł wymaga pracy redakcyjnej.
Jak zaprojektować proces, który da się sprawdzić?
Zacznij od jednego zadania, np. rozpoznawania rekomendacji wskazanej marki. Zapisz definicję polecenia, przypadki wyłączone i zasady obsługi niepełnej odpowiedzi. Dopiero potem buduj automatyzację.
Zachowaj materiał źródłowy wraz z pytaniem, nazwą produktu AI, trybem, językiem i datą. Ocena wyrwanego zdania może być inna niż ocena całej odpowiedzi. Brak odpowiedzi, błąd pobrania i odpowiedź bez marki powinny mieć osobne oznaczenia.
Kilka niezależnych pytań o ten sam materiał można wysłać w jednym żądaniu. Ich wyniki połącz regułami programu. Jeżeli kolejne pytanie wymaga danych, które dopiero pobierzesz po pierwszym wyniku, potrzebny będzie następny etap. Zasady budowania pytań w TypeSafe.
Materiał -> osobne pytania -> reguły -> wynik lub kontrola człowieka.
Brak źródła -> uzupełnienie materiału. Niepewna ocena -> weryfikacja. Zmiana definicji -> ponowny test.
W raporcie przechowuj zarówno ocenę, jak i wersję kryteriów. Gdy zmienisz definicję rekomendacji, przelicz porównywane okresy według tych samych zasad albo oznacz przerwę w porównywalności. Inaczej poprawa klasyfikatora może wyglądać jak wzrost widoczności marki.
Confidence nie oznacza procentowej gwarancji poprawności
Dla Choice i Score dokumentacja opisuje pole „confidence”, obliczane z rozkładu prawdopodobieństw. To informacja o tym, jak rozstrzygnięty jest wynik modelu. Nie należy automatycznie interpretować 0,9 jako potwierdzonej 90-procentowej trafności na Twoich odpowiedziach AI. Noul nie zwraca osobnego pola „confidence”. Jak TypeSafe opisuje pewność odpowiedzi.
Próg kierowania do kontroli dobierz na podstawie testu konkretnego zadania. Innego poziomu pewności możesz wymagać do posortowania kolejki, a innego do wykorzystania oceny w raporcie dla klienta. Wysoka pewność nie zwalnia z kontroli jakości.
Nie wyrzucaj niepewnych przypadków z pomiaru bez pokazania ich liczby. Jeżeli model częściej nie potrafi ocenić odpowiedzi w jednym języku, raport obejmujący wyłącznie łatwe przypadki może zniekształcać porównanie.
Jak sprawdzić trafność: przykład na 120 odpowiedziach
W danych przykładowych redaktor ocenił 120 odpowiedzi. Model oznaczył 30 z nich jako rekomendacje. Po porównaniu z oceną redaktora 24 z tych oznaczeń okazały się trafne, a 6 błędne. Dodatkowo model pominął 8 rekomendacji.
| Ocena modelu | Rekomendacja według redaktora | Brak rekomendacji według redaktora |
|---|---|---|
| Rekomendacja | 24 trafne wykrycia | 6 błędnych alarmów |
| Brak rekomendacji | 8 pominiętych rekomendacji | 82 trafne oceny braku rekomendacji |
| Razem | 32 odpowiedzi | 88 odpowiedzi |
Precyzja rekomendacji wynosi tu 24 / 30 = 80%. Oznacza, że co piąta wykryta rekomendacja jest błędnym alarmem. Czułość wynosi 24 / 32 = 75%, ponieważ rzeczywistych rekomendacji według oceny redaktora jest łącznie 32. Model pominął jedną czwartą z nich.
Ogólna zgodność to 106 / 120, czyli około 88,3%. Ta liczba wygląda lepiej, bo większość odpowiedzi nie zawierała rekomendacji. Sama nie wystarcza do oceny przydatności klasyfikatora.
W praktyce przygotuj osobne przykłady do dopracowania kryteriów i osobny zbiór do końcowego sprawdzenia. Dodaj negacje, rekomendacje warunkowe, nazwy podobnych firm i niepełne źródła. Część materiału niech ocenią dwie osoby. Rozbieżności mogą ujawnić niejasną definicję, zanim zaczniesz oceniać model.
Liczba 120 służy pokazaniu obliczeń i nie jest standardem walidacji. Wielkość próby oraz tolerowany poziom błędów zależą od celu. Polski materiał sprawdzaj po polsku: TypeSafe wskazuje angielski jako język, w którym obecnie osiąga najlepszą trafność. Obsługa języków w dokumentacji.
Ile kosztuje Jev, a ile cały proces GEO?
W cenniku modeli sprawdzonym 20 października 2026 widnieje 0,042 USD za milion tokenów wejściowych. Token to jednostka tekstu rozliczana przez API. Tokeny wyjściowe są według dokumentacji bezpłatne. To stawka producenta z dnia weryfikacji, nie gwarancja przyszłej ceny. Cennik w dokumentacji modeli.
W danych przykładowych chcesz ocenić 2000 odpowiedzi, a każde żądanie ma średnio 1200 tokenów wejścia, łącznie z kontekstem i pytaniami. Rachunek wynosi: 2000 × 1200 = 2 400 000 tokenów; 2,4 × 0,042 USD = 0,1008 USD, czyli około 0,10 USD za tę część pracy.
To kalkulacja według założonego rozmiaru wejścia, nie pomiar wykonanych wywołań. Drugie pełne przejście tej samej wielkości podwoiłoby koszt do około 0,20 USD. Dłuższy kontekst i ponowienia również zwiększają zużycie.
| Element procesu | Czy obejmuje go podane 0,10 USD? | Co uwzględnić? |
|---|---|---|
| Ocena w Jev | Tak, według założeń przykładu | Rzeczywistą liczbę tokenów wejściowych. |
| Pozyskanie odpowiedzi AI | Nie | API, usługę zbierającą odpowiedzi lub pracę ręczną. |
| Pobranie i zachowanie źródeł | Nie | Dostęp do stron, ekstrakcję treści i przechowywanie. |
| Sprawdzenie jakości | Nie | Oznaczanie próby, rozbieżności i kontrolę człowieka. |
| Przygotowanie zmian w treści | Nie | Redakcję, weryfikację faktów i wdrożenie. |
Dlatego tania klasyfikacja nie oznacza monitoringu GEO za kilka centów. Porównuj koszt całego przebiegu oraz koszt uzyskania poprawnego, użytecznego wyniku. Niska cena pojedynczej oceny może stracić znaczenie, jeśli każdą trzeba później poprawiać ręcznie.
Czego nie dowodzą benchmarki producenta?
Publiczna strona ewaluacji TypeSafe opisuje cztery procesy automatyzacyjne. Ocenia modele względem etykiet referencyjnych wyznaczonych przez inne modele. Jest to porównanie w określonym układzie testowym, a nie niezależna ocena trafności Jev w polskim GEO. Metodologia ewaluacji TypeSafe.
Nie przenoś jednej liczby z takiego wykresu na rekomendacje marki, wykrywanie kanibalizacji czy zgodność cytowań. Nie dowodzi ona też, że zastosowanie Jev zwiększy liczbę poleceń firmy. Ten drugi wniosek wymagałby osobnej oceny zmian w widoczności i warunków, w których je mierzono.
Czy Jev pomoże zdobywać cytowania w Google i ChatGPT?
Może pomóc znaleźć braki w treści lub uporządkować ocenę odpowiedzi. Samo uruchomienie modelu nie sprawia jednak, że zewnętrzna wyszukiwarka odczyta stronę, uzna ją za wartościową i przywoła w odpowiedzi.
Google podaje, że dla obecności jako źródło w AI Overviews i AI Mode obowiązują podstawy SEO. Strona musi być zindeksowana i kwalifikować się do wyświetlania z fragmentem tekstu. Spełnienie wymagań nie gwarantuje obecności. To wytyczne dla funkcji Google, nie wspólna specyfikacja wszystkich asystentów. Google Search Central: funkcje AI a witryna.
W pracy nad stroną wykorzystuj ocenę do poprawienia odpowiedzi dla czytelnika: uzupełnienia warunków, wyjaśnienia ograniczeń, dodania źródła lub rozróżnienia podobnych poradników. Google zaleca treści przydatne i tworzone z myślą o odbiorcy. Jego zasady spamu obejmują masowe treści tworzone przede wszystkim w celu manipulowania wynikami. Przydatne treści i zasady dotyczące spamu.
Od czego zacząć w swojej firmie?
Najpierw ustal, na jakie pytanie biznesowe potrzebujesz odpowiedzi. Czy chcesz wiedzieć, czy AI poleca markę? Czy opisuje ofertę zgodnie z faktami? Czy źródła wspierają konkretne twierdzenia? Każde z tych zadań wymaga innych kryteriów.
Jeśli dopiero zaczynasz, sprawdź obecność firmy i przeczytaj odpowiedzi w całości. Gdy wiesz już, co chcesz oceniać, przygotuj ręcznie oznaczoną próbkę. Jev warto testować wtedy, gdy zadanie jest powtarzalne i potrafisz wyjaśnić, jak rozpoznajesz poprawny wynik.
Najczęstsze pytania o Jev i GEO
Czy Jev napisze artykuł pod GEO?
Jev służy do ustrukturyzowanych ocen, a nie pisania swobodnych artykułów. W proponowanym procesie może ocenić określoną cechę tekstu. Przygotowanie i redakcja treści pozostają osobnym zadaniem.
Czy Jev sam sprawdzi, co mówi ChatGPT?
W opisanym procesie dostarczasz odpowiedź i potrzebny kontekst. Zbieranie odpowiedzi, zachowanie źródeł i udokumentowanie warunków pomiaru wymagają osobnej obsługi.
Czy można pozycjonować firmę w Jev?
Jev nie jest opisaną w tym artykule wyszukiwarką prezentującą klientom ranking firm. Może wspierać analizę materiału wykorzystywanego w pracy nad widocznością.
Czy wysoka pewność oznacza, że można pominąć człowieka?
Decyzja zależy od trafności sprawdzonej na Twoim zadaniu i konsekwencji błędu. Pewność modelu nie jest samodzielnym potwierdzeniem poprawności. Zachowaj ścieżkę kontroli oraz regularnie sprawdzaj również wyniki zaakceptowane automatycznie.
Czy Semly wykorzystuje Jev?
Ten artykuł nie potwierdza wdrożenia Jev w Semly. Przedstawia możliwe zastosowania modelu w analizie GEO i SEO, wraz z ograniczeniami i propozycją testu.
Stan dokumentacji i źródeł sprawdzono 20 października 2026 r. Opis funkcji i stawek pochodzi z materiałów TypeSafe. Scenariusze, schematy oraz dane przykładowe są opracowaniem redakcyjnym i nie przedstawiają wyników marek ani klientów Semly.
Udostępnij:
