

Проверьте видимость вашей компании в ИИ
Бесплатно. Банковская карта не требуется.
Основные выводы исследования Semly
Видимость бренда в ИИ должна оцениваться в зависимости от потребностей человека, задающего вопрос, и хода их разговора с моделью. Бренд, появляющийся в ответе на общий запрос, еще не показывает, рекомендует ли система его кому-то, для кого подходит его предложение. В методе Semly Леон берет на себя роль пользователя, определяемого личностью, и строит контекст через разговор, прежде чем задавать целевой вопрос о покупке.
В Semly мы разрабатываем этот подход с агентом Леоном. В течение шести месяцев мы проводили исследования и эксперименты по запросу ChatGPT и Gemini. Набор данных, представленный в этом отчете, охватывает 1,2 миллиона запросов, 24 совокупных отчета и 12 сопоставимых сравнений. Анализ включает шесть когорт и два подхода к подготовке контента: без персоны и с персоной.
Среднее время достижения одной и той же цели видимости составляло 100 дней без персоны и 70 дней с персоной. Это означает сокращение на 30% или в среднем на 30 дней. Актуальность контента выросла с 61,5% до 77,5% - на 16 процентных пунктов. Мы наблюдаем одинаковое направление различий в обеих системах.
Результаты подтверждают использование персон в планировании контента и анализе видимости. Они обеспечивают основу для более конкретного резюме: для кого материал, какие критерии отбора он должен объяснить и какие возражения он должен рассмотреть. Повторяемость ответов и влияние конверсии требуют отдельных метрик; этот набор данных также не обеспечивает численного эффекта.
| Информация | ценность | Основание |
|---|---|---|
| охват | Шесть месяцев, ChatGPT и Gemini | Описание исследования Semly |
| Запросы в наборе данных | 1 200 000 | Сумма счетчиков запросов в начале и конце измерения |
| Структура сравнения | 24 записи, 12 пар | 6 когорт × 2 систем × 2 подходов |
| Среднее время для таргетинга | 100 против 70 дней | 30% сокращение |
| Актуальность содержания | 61,5% против 77,5% | 16 процентных пунктов; 1200 оценок за подход |
| Повторяемость и преобразование | Нет числовой метрики в наборе данных | Отдельные области оценки |
Почему один вопрос не описывает потребности клиента
Запрос «Где купить удобную кроссовку?» не указывает на поверхность, опыт, бюджет или предполагаемое использование. Поэтому рекомендация может касаться широкой категории продуктов, в то время как бренд должен знать, достигает ли он рекреационного лесного бегуна, новичка на мощеных маршрутах или конкурентного бегуна.
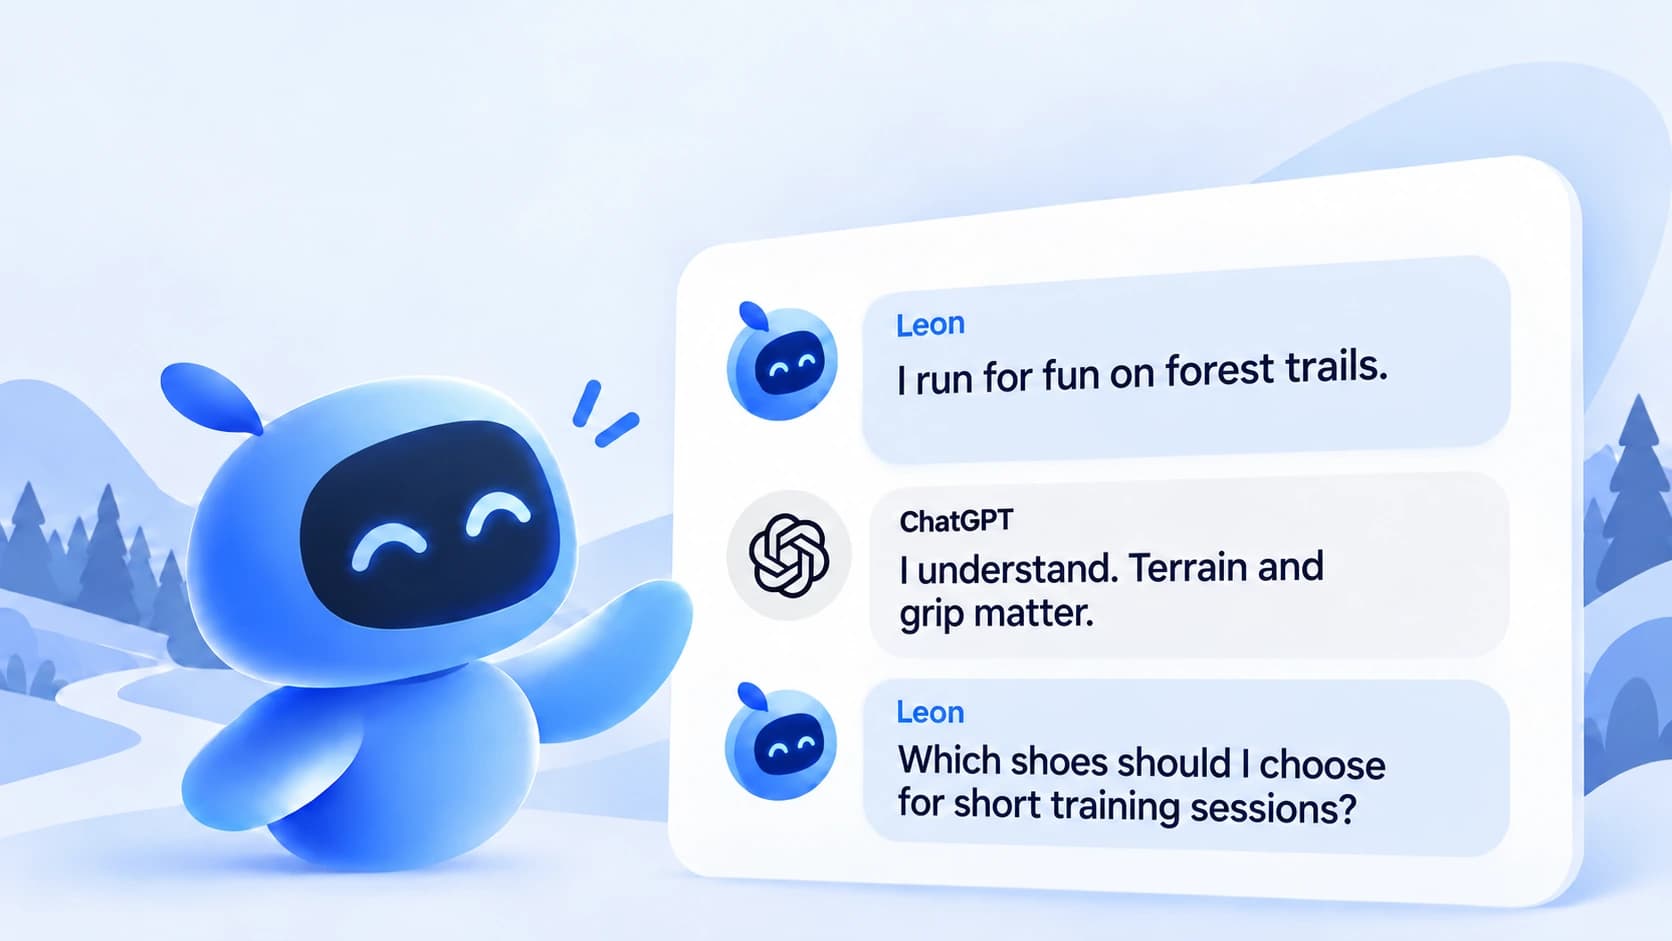
Заявление «Я в основном бегаю рекреационно по лесным тропам и нуждаюсь в обуви для коротких тренировок» сужает ситуацию. В подходе Semly Леон может ввести этот контекст в начале разговора и перейти к целевому вопросу после интерпретации ответа. Основная потребность в покупке остается той же самой, но условия измерения включают личность, намерение и предыдущие сообщения в этом разговоре. Это имеет значение, когда интерпретация увеличивается или уменьшает видимость.
Персона определяет роль и сценарий пользователя, который Леон использует при разговоре с моделью. Агент создает свой собственный контекст в этом разговоре, приближая исследование к тому, как человек использует чат. Он не реконструирует историю конкретного реального пользователя. Стоит начать с потребностей и ограничений, связанных с продуктом. Возраст, пол и другие демографические характеристики должны быть обоснованы изучаемым сценарием.
Официальное руководство OpenAI и Google указывает на то, что соответствующий контекст помогает определить задачу и ее ограничения [1][2]. Это обеспечивает основу для разработки запросов.
Как AI Agent Leon связывает знания бренда с пользовательским контекстом
Леон создает персоны из знаний о бренде, его продуктах, услугах и существующем контенте. Затем он действует в исследовании как пользователь, соответствующий выбранному профилю. Он начинает разговор, знакомится с моделью и интерпретирует ее ответ. Исходя из этого, он понимает, когда он может задать целевой запрос с контекстом и намерением. В результате возникает практический вопрос: включает ли ИИ бренд в разговор с кем-то, чьи потребности соответствуют его предложению?
Роль Леона связывает мониторинг с планированием контента. Ответы могут выявить критерии отбора, возражения и информацию, которые модель использует для обоснования рекомендаций. Если информация для конкретного сценария отсутствует на веб-сайте бренда, анализ может привести к краткому выявлению пробелов в контенте.
Леон ведет разговор как пользователь
Исследование, проведенное Леоном, следует за разговором. Агент сначала знакомится с моделью в качестве исследуемого пользователя в соответствии с выбранной персоной. Это определяет положение и потребности пользователя. Получив ответ, он читает его и интерпретирует по отношению к цели разговора.
Интерпретация ответа является частью операции агента. Леон оценивает, сможет ли он перейти к целевому вопросу. Его сроки вытекают из хода разговора и полученного ответа. Целевая подсказка содержит контекст и намерение пользователя и появляется в разговоре, в котором модель уже имеет более раннюю информацию о пользователе.
Этот способ запроса ближе к тому, как человек использует чат. Пользователь описывает свою ситуацию, читает ответ и формулирует следующий вопрос на этой основе. Леон играет эту роль в исследовании, позволяя анализировать рекомендации бренда в рамках разворачивающегося разговора.
Намерение определяет решение, которое пользователь хочет принять. В примере бега контекстом может быть рекреационный бег по лесным тропам и намерение выбрать и купить подходящую обувь. Леон просит дать ему рекомендацию после того, как он истолковал предыдущий ответ и определил, что он может задать целевой вопрос.
Вся история разговора становится актуальной при интерпретации результата. Идентичные формулировки в последнем вопросе могут давать разные ответы, если предыдущие сообщения вводят разные потребности. Таким образом, исследование должно выявить как целевую подсказку, так и разговор, в котором она была задана.
Описание процесса объясняет роль Леона и почему исследование напоминает взаимодействие в чате. Однако поставляемые агрегаты не изолируют эффект введения себя, интерпретации ответа или выбора, когда задавать вопрос. Мы не относим 30% и 16-процентные результаты отдельно ни к одному из этих этапов.
| Стадия разговора | Действие Леона | Исследовательская значимость |
|---|---|---|
| Введение | Предполагает роль пользователя, определенную личностью, и начинает разговор. | Устанавливает ситуацию и потребности пользователя |
| Типовой ответ | Получает и интерпретирует ответ | Счета за ход разговора |
| Решение по следующему вопросу | Узнает, когда спрашивать целевую подсказку | Адаптация времени к ответу |
| Быстрый с намерением | Задает целевой вопрос с контекстом и намерением в этом разговоре. | Возможность оценки рекомендаций в пользовательском контексте |
Что означает сокращение времени на 30%
Набор данных предполагает общий начальный уровень видимости 20% и общую цель 40%. Видимость определяется как количество ответов, рекомендующих бренд, деленное на количество запросов. Это означает увеличение на 20 процентных пунктов. Подходы описывают, как готовится контент; результаты оцениваются по той же целевой группе и панели вопросов в соответствии с предположениями набора данных.
Среднее время на нацеливание составляет 100 дней без персоны и 70 дней с персоной. Мы рассчитываем сокращение как (100 - 70) / 100 × 100%, или 30%. Разница составляет 30 дней. Это означает, что «на 30% меньше времени для достижения той же цели».
Для видимости построения команды это потенциально означает более короткий цикл от выявления потребностей до достижения намеченного результата. Оперативная интерпретация имеет значение: более целенаправленный контент может уменьшить потребность в последовательных изменениях. Однако набор данных не изолирует рабочее время редакции или индивидуальные причины разницы, поэтому мы не приписываем весь эффект исключительно автоматизации Леона.
Представленные данные содержат базовую видимость, окончательную видимость и время нацеливания без ежедневных временных рядов видимости. Таким образом, график показывает время для общего результата. Мы не используем эти данные, чтобы нарисовать кривую, предполагающую, что эффект накапливается с постоянной скоростью.
Таблица 1. Среднее время до общей цели 40% видимости: 100 и 70 дней. Основание: 12 сопоставимых сравнений в данных Semly. Разница: 30 дней, сокращение на 30%.
Актуальность контента и точность ответов - это разные меры.
В этом наборе данных релевантность контента - это доля оцениваемых материалов, которые считаются согласованными с потребностями человека. Каждая запись включает 100 оценок. Без персоны — 738 соответствующих материалов из 1200 оценок; с персоной — 930 из 1200. Они соответствуют 61,5% и 77,5%.
Разница составляет 16 процентных пунктов. Относительное увеличение по сравнению с исходным уровнем 61,5% составляет примерно 26,0%. Это два способа описания одного и того же набора данных, но не одного и того же блока. Основной мерой, используемой в тексте и графике, остается разница в процентных пунктах.
Актуальность контента не эквивалентна правдивости ответа модели. Ответ может соответствовать потребностям пользователя и содержать неверную спецификацию продукта. Поэтому точность ответов следует оценивать отдельно: учитывает ли модель требования, соответствует ли рекомендация и подтверждаются ли указанные факты источниками?
Результат 77,5% показывает более высокую долю материалов, отвечающих потребностям пользователей. Он поддерживает описание выбора контента как более релевантного в этом наборе данных. Поскольку были предоставлены только агрегированные данные, без индивидуальных оценок или подробной рубрики оценки, в отчете не утверждается статистическая значимость или приравнивается релевантность контента к фактической точности каждого ответа ИИ.
Таблица 2. Актуальность контента: 61,5% и 77,5%, разница в 16 процентных пунктов. База: 1200 оценок за подход в данных Semly. Метрика описывает соответствие потребностям личности; это не коэффициент конверсии.
Результаты для ChatGPT и Gemini
Для ChatGPT среднее время достижения цели составляет 95 дней без персоны и 66,5 дней с персоной. Для Близнецов цифры составляют 105 и 73,5 суток. Обе системы показывают снижение на 30%. Сравнение показывает одинаковое направление различий в анализируемых группах.
Актуальность контента в записях ChatGPT составляет 60,5% без персоны и 76,5% с персоной. Для Близнецов это 62,5% и 78,5%. Разница в каждой системе составляет 16 процентных пунктов. Каждая комбинация системы и подхода включает 600 оценок содержания.
Разделение результатов по системе проверяет, маскирует ли совокупное среднее различные результаты. В этом наборе данных различия между подходами согласуются между ChatGPT и Gemini. Это не рейтинг качества самих моделей: время и релевантность описывают анализируемые действия и содержание.
На практике полезно поддерживать отдельные профили видимости для каждой системы. Один и тот же контент и потребности пользователей могут быть представлены по-разному. Рекомендации Леона можно оценить по конкретной системе и сценарию, не сводя все присутствие бренда к одному номеру.
График 3. Среднее время до общей цели в ChatGPT и Gemini. База: 6 сопоставимых сравнений по системе, данные Semly. Результат описывает анализируемые подходы, а не ранжирование качества модели.
| Система ИИ | Время без / с персоной | Актуальность без / с персоной |
|---|---|---|
| ЧатГПТ | 95/66,5 дней | 60.5% / 76.5% |
| Близнецы | 105 / 73,5 дней | 62.5% / 78.5% |
Результаты в шести когортах
Набор данных охватывает когорты М1-М6. Среднее время нацеливания, рассчитанное для обеих систем в каждой когорте, составляет 75, 85, 95, 105, 115 и 125 дней без персоны. При персоне это 52,5, 59,5, 66,5, 73,5, 80,5 и 87,5 дней.
Разница между подходами видна как для более короткого, так и для более длительного времени нацеливания. Это 22,5 дня в М1 и 37,5 дня в М6. В каждой паре в представленном наборе данных время с персоной составляет 70% времени без нее. Мы явно показываем эту фиксированную связь; мы не рассматриваем ее как меру повторяемости реакции модели.
M1-M6 описывает когорты, а не шесть последовательных показаний видимости для одного бренда. Увеличение времени не следует интерпретировать как снижение эффективности в последующие месяцы. Анализ сезонности и изменений с течением времени требует календарных дат и ежедневных или еженедельных чтений.
Полная оценка по срокам должна также включать сообщения о случаях, которые не достигли порога до завершения наблюдения. Представленный набор данных не идентифицирует такие случаи отдельно. Это следует учитывать при разработке будущих сравнений.
График 4. Время нацеливания на шесть когорт, в среднем на две системы, данные Semly. Когорты M1-M6 не являются месячными временными рядами видимости для одного бренда.
Один и тот же вопрос в нескольких лицах
В рамках работы Semly мы также изучили один и тот же базовый вопрос по нескольким персонам. Леон действует как пользователь, соответствующий каждому профилю, и проводит беседу, прежде чем задать целевой вопрос. Это помогает определить, как потребности, намерения и более ранний контекст влияют на рекомендации и информацию, полезную для принятия решения о покупке. Для вопроса о беговой обуви сценарии могут включать новичка на мощеных маршрутах, рекреационного лесного бегуна и кого-то, кто проводит более длительные тренировки по тропе. Приведенная ниже матрица иллюстрирует использование метода. Это не стенограмма ответов на исследование.
Для каждого ответа полезно записывать рекомендуемые бренды, аргументы выбора, технические требования, возражения и цитируемые URL-адреса. Сравнение показывает, какая информация повторяется в разных сценариях и какая конкретна для конкретной потребности. Затем краткое описание может включать общее ядро и дополнительные разделы, посвященные различиям.
Semly использует наблюдения из работы с несколькими персонами в качестве основы для более релевантных содержательных рекомендаций. Однако в представленный набор данных не входят идентификаторы персон, полные подсказки или ответы моделей. Таким образом, отчет не приписывает численный эффект конкретному человеку или ранжированию брендов, которые он рекомендует.
| Пример сценария | Вопросы для анализа ответов | Возможное содержание |
|---|---|---|
| Новичок, короткие мощеные маршруты | Упомянуты ли критерии комфорта и соответствия? | Выбор первой пары, размер и использование |
| Рекреационный бег по лесным тропам | Рассматривает ли ответ поверхность и сцепление? | Условия на местности и единственные сравнения |
| Более длинные тренировочные тропы | Какие ограничения и спецификации определяет модель? | Сравнение вариантов для более длительной нагрузки |
Как ответы от нескольких лиц становятся кратким содержанием
Разговор может предоставить информацию для краткого ознакомления еще до окончательной рекомендации. Более ранний ответ может выявить критерии, требующие объяснения, в то время как целевой вопрос Леона связывает их с намерением пользователя. Анализ полной беседы помогает определить полезный контент для последовательных этапов принятия решений.
Во-первых, критерии отбора следует отделить от фирменных наименований. Список рекомендованных компаний сам по себе не объясняет, почему они появляются. Информация о том, что конкретному пользователю требуется сравнение приложений, объяснение совместимости или четкие условия возврата, более полезна редакционной группе.
Затем эти потребности следует сравнить с материалами бренда. Отсутствующий ответ на важный вопрос может оправдать обновление существующей страницы. Различия между группами пользователей могут служить основанием для отдельного раздела или сравнения. Решение должно отражать полезность для людей, а не механически умножать страницы для каждого человека.
Пример может включать в себя сценарий пользователя, решение принять решение, ключевые критерии, проверяемые данные о продукте, возражения и источники. Если анализ касается лесных троп, материал должен объяснять использование и ограничения продукта.
Контент, подготовленный таким образом, может быть более релевантным для тех, кто получает ответ от ИИ. Это подтверждает гипотезу о лучшем преобразовании. Подтверждение требует сравнения поведения пользователей и результатов продаж после внедрения.
Повторяемость требует повторных измерений
Фиксированное описание личности и согласованные правила разговора могут облегчить сравнение измерений. Поскольку Леон интерпретирует ответ, прежде чем задать целевой вопрос, необходимо также контролировать историю разговора и правила принятия решений. Повторяемость процесса и согласованность между окончательными ответами должны оцениваться отдельно.
Предлагаемый тест должен содержать ту же модельную версию, режим поиска, язык, местоположение и правила запуска сеанса. Полезно сравнивать как полноценные беседы, начатые с одной и той же персоной и целью, так и ответы с одинаково реконструированным контекстом. Первое сравнение оценивает вариации во всем процессе; второе помогает оценить вариации в конечном ответе. Базовая панель и панель персоны должны работать параллельно.
Возможные показатели включают стабильность присутствия бренда, соглашение между наборами рекомендуемых брендов и соглашение между цитируемыми источниками. Для двух наборов брендов A и B простой мерой соглашения является доля общих брендов в наборе всех брендов из обоих ответов. Случаи, когда оба набора пусты, требуют отдельного правила отчетности.
Повторяемость внутри одного человека и различия между людьми решают разные вопросы. Стабильные рекомендации для одного профиля могут сосуществовать с четкими различиями между профилями. Структурированные описания личности Леона помогают поддерживать более последовательные условия запроса. Однако в представленном наборе данных нет мер согласованности между последовательными ответами, поэтому мы не оцениваем улучшение повторяемости.
Как проверить влияние на конверсию
Бизнес-измерение должно различать присутствие бренда в ответе, цитирование его веб-сайта, посещение пользователем сайта и завершение действия. Каждый этап требует своей метрики. Рекомендательные счета не являются счетами посещений, а подсчеты посещений не являются счетами покупок.
После реализации контента полезно отслеживать сеансы из идентифицируемых источников ИИ, взаимодействия, запросов, транзакций и доходов. Некоторый трафик может не иметь однозначной метки источника, поэтому следует описать объем идентифицированных сеансов. Коэффициент конверсии должен использовать четко определенный знаменатель, например, квалифицированные сессии.
Сравнение похожих страниц или групп контента с последовательным определением конверсии и окном наблюдения поддерживает более надежную оценку. Другие изменения, такие как рекламные акции, цены, доступность продукта и кампании, должны быть зарегистрированы. В противном случае рост продаж может быть ошибочно приписан изменению контент-стратегии.
Таким образом, в отчете предлагается конкретная гипотеза: контент, связанный с реальными потребностями пользователей, может помочь людям принимать решения. Размер его влияния на продажи еще предстоит измерить. Электронная таблица не содержит сессий, лидов или транзакций.
Что изменение методологии означает для результатов видимости
Представление персонажей и разговоры Леона меняют то, как запрашиваются модели. Ответ целевого запроса также учитывает более ранние сообщения. Результат может расти, когда бренд лучше соответствует заявленным потребностям, или падать, когда система выбирает другое предложение. Поэтому при сопоставлении следует учитывать как формулировку вопроса, так и способ подготовки разговорного контекста.
Наиболее четкий подход заключается в том, чтобы показать результаты базовой и персональной панели бок о бок. Если требуется комбинированное среднее значение, акции должны следовать явным предположениям о аудитории. Равные веса являются простым аналитическим вариантом, но не доказывают, что на каждую группу приходится равная доля реального спроса.
Согласование с потребностями также имеет значение при выборе людей. Профиль, построенный исключительно с точки зрения предложения, может не учитывать барьеры покупки или ситуации, в которых продукт не подходит. Полезно включать требовательные сценарии, вместо того чтобы проектировать панель только вокруг пользователей, для которых бренд легко рекомендовать.
Резюме доклада
Исследования Semly показывают, что включение персон помогает согласовать контент с потребностями пользователей и сократить время, необходимое для создания видимости в ИИ. В анализируемом наборе данных среднее время до общей цели видимости составляло 100 дней без персоны и 70 дней с персоной — на 30% меньше. Релевантность контента увеличилась с 61,5% до 77,5%, или на 16 процентных пунктов. Такое же направление разницы наблюдалось в ChatGPT и Gemini.
Леон придает этому подходу разговорную форму. Агент действует как пользователь: он представляет себя в соответствии с персоной, интерпретирует ответ модели и распознает, когда задавать целевой вопрос с контекстом и намерением. Это позволяет Semly анализировать рекомендации в условиях, приближенных к тому, как люди используют чат.
Запрос одного и того же базового вопроса у нескольких лиц определяет различные критерии отбора, возражения и информационные потребности. Эти наблюдения могут дать более конкретные сведения, сравнения и материалы, которые помогут пользователям принять решение. Более высокая релевантность контента поддерживает этот подход; влияние конверсии требует отдельного измерения поведения пользователей и бизнес-результатов.
Согласованные персоны и правила общения обеспечивают основу для сопоставимого мониторинга. Повторяемость ответа, тем не менее, должна оцениваться с помощью дополнительных измерений, учитывающих историю разговора и условия запроса. Представленные результаты не дают количественной оценки улучшения повторяемости или увеличения конверсии.
Практическое значение для брендов ясно: изучите, кому ИИ рекомендует предложение и в какой ситуации, а затем используйте эту информацию для разработки контента. Таким образом, Semly связывает инструмент мониторинга видимости с исследованиями в контексте, намерениях и модельных рекомендациях.
Источники
Грубый материал: "Более миллиона запросов, шесть месяцев исследований. Почему Semly вводит персоны в мониторинг видимости ИИ», дополненный описанием Semly разговоров Леона — источниками для агента и описанием исследования.
[1] OpenAI, быстрое проектирование. Руководство по предоставлению соответствующего контекста в запросе. https://developers.openai.com/api/docs/guides/prompt-engineering
[2] Google AI для разработчиков, стратегии быстрого проектирования. Руководство по контексту и ограничениям задач. https://ai.google.dev/gemini-api/docs/prompting-strategies
[3] Franziska Weeber, Vera Neplenbroek, Jan Batzner, Sebastian Padó, One Persona, Many Cues, Different Results: How Sociodemographic Cues Impact LLM Personalization, ACL 2026. https://aclanthology.org/2026.acl-long.2079/
Поделиться:
