

AI 会推荐你的商品吗?
进行免费审核
基础
Query Fanout 究竟是什么?
Query Fanout 是一种机制,通过该机制人工智能(例如 Google AI 模式、ChatGPT、电子商务聊天机器人)理解并处理用户查询。系统会自动 将一个问题分解为多个相关的子问题 并搜索各种来源,然后 将结果综合成一个整体答案。
“扇出”一词意味着分支、扩散——在这里:将查询分发到多个搜索渠道,例如 Google、Bing 或 Semly 等数据聚合器。
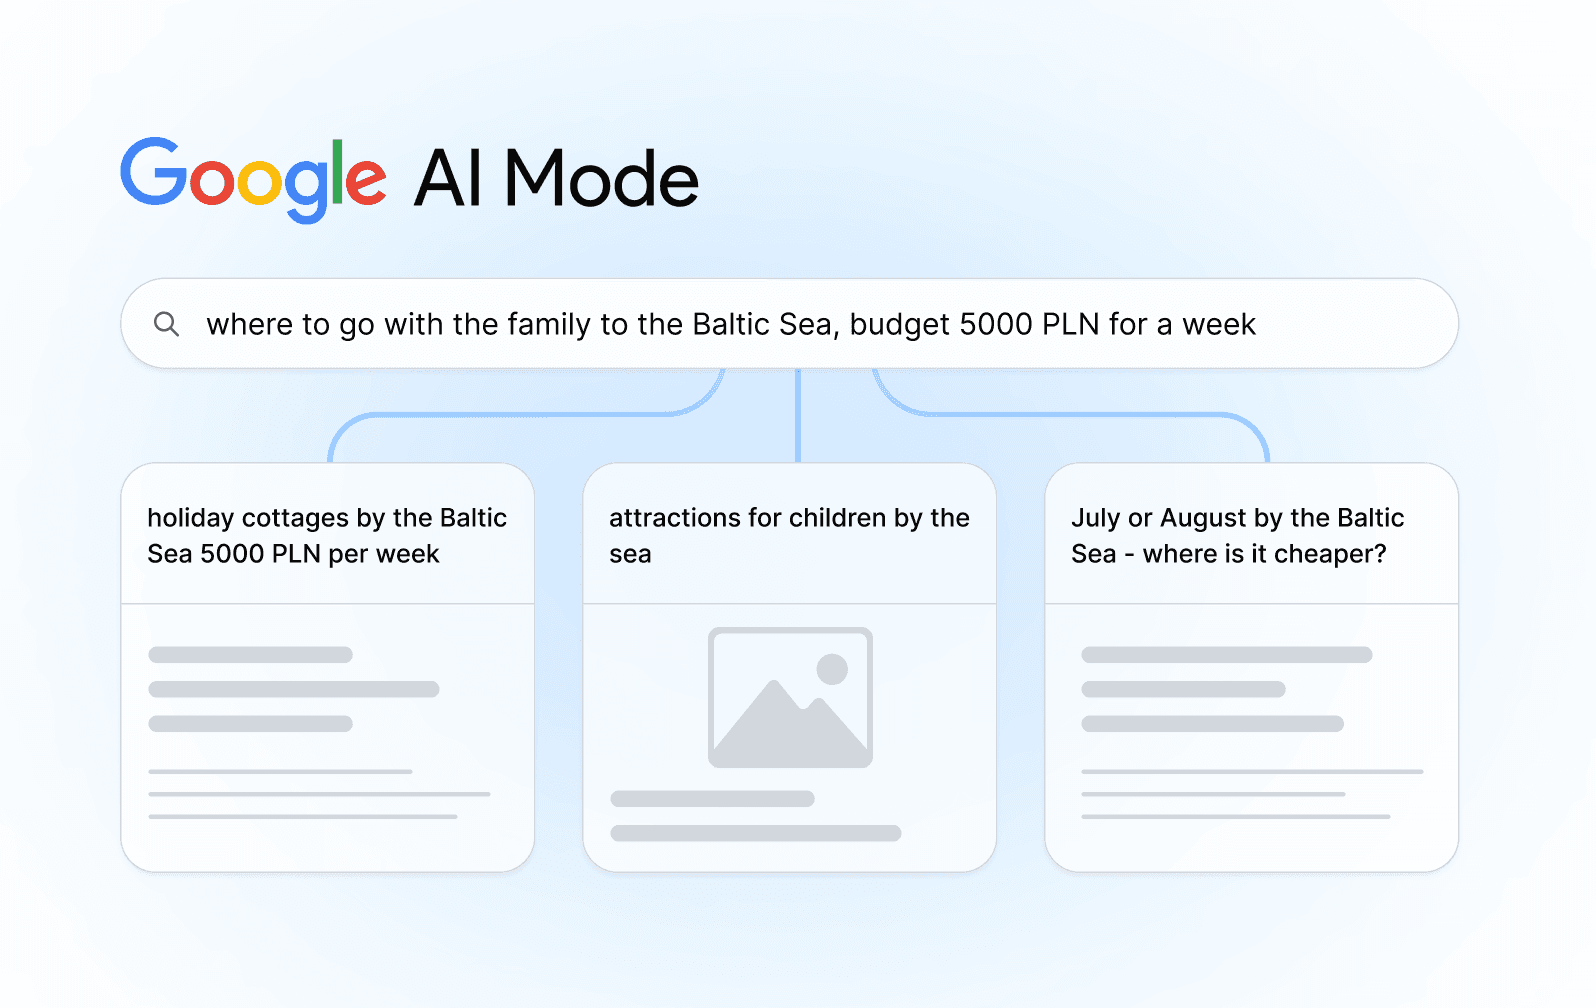
您在 Google AI 模式中输入:“带家人去波罗的海度假,预算为 5000 波兰兹罗提,为期一周。”
在传统搜索中,系统会寻找包含确切关键词的页面。而在查询扇出中,系统正是这样做的:
识别意图:
- 寻求者:有孩子的家庭
- 目的地:海滨度假
- 限制条件:每周预算为 1000 欧元
- 地点:波罗的海(波兰海岸)
- 时间:未定义,但建议夏季度假
分解为子问题:
- “波罗的海最适合家庭的最便宜住宿”
- “波罗的海夏季别墅,每周 1000 欧元”
- "七月带孩子去哪里海边便宜"
- "海边儿童娱乐设施"
- "哪个城市在波罗的海地区2025年受欢迎"
- "如何带家人便宜地去波罗的海旅行"
- "不含餐饮的波罗的海度假 - 预算选择"
- "波罗的海最适合儿童的海滩"
- "带孩子住在海边哪里住 - 论坛"
- "七月或八月在波罗的海 - 哪里更便宜"
"同步搜索:"
"同步搜索:这些查询会同时发送到各种来源——预订门户、旅游博客、论坛、度假村网站、YouTube、Google地图上的评论。"
"综合:"
"综合:系统从所有来源收集片段,对其进行整理(例如,最受欢迎/最推荐的内容将显示在前面),并以如下形式呈现给用户:‘在波罗的海,最佳地点是达洛沃,这里有热门度假村及其价格,这里有儿童海滩,这里还有旅行选择。’"
Google 为什么引入 Query Fanout?
搜索变更历史
Google多年来一直以如下方式运营:
- 用户输入关键词
- 算法查找包含这些词汇的页面
- 按受欢迎程度和相关性对其进行排序
- 显示链接列表
这对简单问题("一头大象有多重?")效果很好。但当问题变得更加复杂时("如果我经常在城里开车,有两个孩子,喜欢节省燃油,但也希望可靠和方便,应该开什么类型的车?"),传统模型开始失效
当系统识别出一个问题需要高级推理时,它会启动我们版本的Gemini模型。它将问题分解为各种子主题,并代表您并行发送多个查询。系统不再为您提供链接列表,而是从每个来源的最佳文本、表格、图片中查找内容,并为您组装一个连贯的答案
Google搜索负责人伊丽莎白·里德,GoogleI/O 2025
对用户的实际好处
- 快速回答 - 无需点击多个页面
- 完整性 - 所有方面的问题都得到解决
- 比较 - 系统自动比较选项
- 反馈 - 系统找到其他用户的体验
- 更新 - 答案包含最新信息
Query Fanout的技术工作原理是什么?
步骤1:意图分析(意图识别)
当用户输入一个问题时,AI系统首先关注的不是词汇,而是问题背后的意图
电子产品商店的一个例子:
问题"为初学者博主选择什么摄像机"
识别出的意图:
- 产品类别:相机
- 用户级别:初学者
- 应用场景:vlogging(YouTube/社交媒体视频)
- 现有技能:最少
- 优先级:易用性,而非专业功能
系统理解到,该用户不会购买价值5,000欧元的相机,而是会购买价格在£500-2000范围内的产品,要求界面简单、防抖效果好,并且内置麦克风。
步骤2:查询分解
基于识别出的意图,系统执行 分解 - 将单一问题拆分为多个逻辑相关的子查询。
对于vlogger相机,这些可以是:
- “2025年最适合初学者使用的相机”
- “一款好的vlogging相机多少钱”
- “vlogging用相机还是智能手机——对比”
- “哪款相机的图像防抖效果最好”
- “评测——最佳YouTube摄像机”
- “vlogging相机必备什么功能(麦克风、屏幕)”
- “在波兰哪里可以买到vlogging相机”
- “vloggers推荐——入门相机”
每个子问题都回答了购买决策的不同方面。
步骤3:并行检索
这是关键部分。系统不会逐一搜索(先查价格,再查评论,再查规格——这会耗费时间),而是同时搜索所有子查询 同时进行.
伪代码示例(Python):
# Simplified pseudocode of what happens in the background
import asyncio
async def query_fanout_search(main_query):
    """
    Concurrent search for all subqueries
    """
    # We break down the main question
    sub_queries = decompose_query(main_query)
    # Result: ["vlogging camera beginner", "camera for YT reviews", ...]
    # We create tasks for each subquery
    tasks = []
    for sub_query in sub_queries:
        tasks.append(search_google(sub_query))
        tasks.append(search_youtube_reviews(sub_query))
        tasks.append(search_forums(sub_query))
        tasks.append(search_prices(sub_query))
    # We run everything simultaneously (asyncio)
    all_results = await asyncio.gather(*tasks)
    return all_results
传统的搜索是顺序的。Query Fanout 则并行处理它们(同时进行)。这将响应时间从几秒钟减少到大约1-2秒。
第4步:合并结果(聚合与排序)
现在系统必须做困难的事情: 以一种有意义的方式合并来自数十个不同来源的结果 算法使用的是 倒数排名融合(RRF) 我用一个简单的例子来解释:
假设我们正在寻找“最佳无线耳机”
结果 z 子问题1 (“适用于办公工作的耳机”):
- 索尼 WH-1000XM5
- Bose QC45
- 森海塞尔 Momentum
子问题2的结果 (“耳机 - 舒适度测试”):
- Bose QC45
- 苹果 AirPods Max
- 索尼 WH-1000XM5
子问题3的结果 (“耳机 - 2025年价格”):
- JBL Live Pro 2
- 索尼 WH-1000XM5
- Anker Soundcore
RRF 工作原理如下:
- 索尼 WH-1000XM5:出现在第1、3、2名结果中 → 获得最高分数
- Bose QC45:出现在第2、1名结果中 → 平均分数
- 其余的得分较低
最终列表:
- 索尼 WH-1000XM5(在许多方面最受欢迎的推荐)
- Bose QC45
- JBL Live Pro 2
第5步:综合与展示
现在系统从每个来源提取内容 最相关的段落:
- 来自评测:“8小时工作舒适度”
- 来自测试:“主动降噪降低噪音95%”
- 来自论坛:“非常适合远程办公”
- 来自价格标签:“£349 促销价”
他最终以包含来源引用的连贯文本形式向用户呈现这些结果。
对网店的实际影响
这意味着传统SEO的终结吗?
不。传统的搜索仍然存在,并将继续存在。但除了传统搜索之外,一个新的渠道正在出现——即在AI响应中的可见度。
传统SEO(为特定关键词排名):
User searches for: "laptop for learning programming"
→ Your site appears in position 3
→ The user clicks the link
→ They land on your page
Query Fanout(作为AI响应的一部分出现):
→ AI Mode generates a response with a sentence:
"Popular choices are: [quote from site A], [quote from site B],
[quote from your site]"
→ The user sometimes clicks the links, sometimes not, but your brand
appears in the answer
这两个渠道现在并行运作。
对网店来说发生了什么变化?
1. 网站上的内容结构需要改变
旧的方法(针对传统SEO优化):
Title: Laptop for programming
The best laptop for programming is something that has...
[two pages of dense text]
这对人类读者有效,但AI模式需要更多结构。
新方法(在Query Fanout下):
# Laptop for Programming – Full Guide 2025
## What do you need to know before buying a laptop for programming?
### 1. Processor – Intel or AMD?
AMD Ryzen 7 is faster for code compilation...
[specific tests]
### 2. RAM – how much do you need?
- For Python: 8-16 GB
- For Web Dev: 16 GB minimum
- For AI/ML: 32 GB
### 3. SSD Drive – how much?
Minimum: 512 GB
Recommendation: 1 TB
[Each point has a clear, self-contained answer]
## Comparison of popular models
| Model | Processor | RAM | SSD | Price | Rating |
| --- | --- | --- | --- | --- | --- |
| Model A | Ryzen 7 | 16GB | 512GB | 3999 | 9.2 |
| Model B | i7-13 | 16GB | 1TB | 4499 | 9.5 |
[Each row is a fragment that AI can extract]
## FAQ – frequently asked questions
Q: Is a MacBook good for programming?
A: Yes, but...
Q: How much does a good laptop for coding cost?
A: From 700 EUR...
[Each Q&A pair is a potential sub-query]
## User Reviews
"I bought this laptop, I code in Python and now I'm earning..." (15 positive reviews)
你能看出区别吗?第二种结构允许AI为每个子查询提取片段。
2. 结构化数据(Schema Markup)现在成为强制性要求
Schema.org 是一种"告诉"AI页面上数字和文字确切含义的方法。
示例:
The laptop costs 1000 EUR
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Programming Laptop Model X",
  "image": "https://example.com/laptop-x.jpg",
  "description": "High-performance laptop for coding.",
  "brand": {
    "@type": "Brand",
    "name": "BrandName"
  },
  "offers": {
    "@type": "Offer",
    "price": "945",
    "priceCurrency": "EUR",
    "availability": "https://schema.org/InStock"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.8",
    "ratingCount": "125"
  }
}
</script>
这样一来,当AI搜索"适用于编程的笔记本电脑,价格不超过945欧元"时,你的网站就会出现在搜索结果中。
3. 权威性和引用比以往更重要
Query Fanout偏好在AI答案中被多次引用的来源。如果您的网站出现在多个子查询的答案中——这意味着您是权威来源。
如何建立权威?
- 撰写您最擅长的内容
- 添加具体数据、测试和数字
- 引用他人并提供链接——这表明您知识渊博
- 从声誉良好的来源建立反向链接
- 定期更新内容
实用建议
指南1:为您的产品绘制Query Fanout图
假设您经营一家移动电源商店。
步骤1:选择核心查询(core query)
"价格不超过150欧元的最佳移动电源"
步骤2:添加上下文扩展
应用场景:
- 用于手机
- 用于笔记本电脑
- 用于旅行
- 用于工作
功能:
- 容量(毫安时)
- 充电速度
- 尺寸
- 重量
用户画像:
- 学生
- 职员
- 旅行者
- 游戏玩家
比较类型:
- 竞争产品
- 上一代产品
- 替代品
步骤3:生成具体的子查询
ZASTOSOWANIE:
USAGE:
- "power bank for iPhone"
- "power bank for laptop"
- "power bank for vacation – test"
- "power bank for office work"
FEATURES:
- "how many times will a power bank charge a phone"
- "power bank 20000 mAh vs 30000 mAh"
- "power bank fast charging – how many watts"
COMPARISONS:
- "Xiaomi vs Samsung power bank"
- "cheap vs expensive power bank – difference"
- "best power bank 2025 – ranking"
PROBLEM-SOLVING:
- "power bank is not charging – what to do"
- "power bank discharges quickly"
- "power bank gets hot"
步骤4:对于每个子查询,在页面上准备一个部分
## How many times will a 20000 mAh power bank charge my phone?
It depends on your phone's battery capacity:
- iPhone 14 (3200 mAh): ~6 times
- Samsung Galaxy S24 (4000 mAh): ~5 times
- OnePlus 12 (5400 mAh): ~3.5 times
- iPad Air (8600 mAh): ~2 times
**How is it calculated?**
20000 mAh (power bank) / 4000 mAh (phone) = 5 charges
(in practice less due to energy loss)
## Will a 20000 mAh power bank charge a laptop?
Yes, but...
- It must have a USB-C Power Delivery output
- It must be at least 65W
- Older laptops (with Micro USB) – no
Our model: 100W, USB-C PD, charges MacBook Air in 2.5 hours.
## Power bank for vacation – will it fit?
- Dimensions: 12 x 7 x 3 cm
- Weight: 420 g
- Fits in a backpack, toiletry bag, pocket of a large handbag
- Ideal for vacation (doesn't take up space)
[etc.]
指南2:在Query Fanout下撰写内容——模板
标题模板(针对每个方面)
# [Product] – Complete Guide [Year]
## What should you know before buying [product]?
### 1. [First Critical Aspect]
- Definition for beginners
- Why is it important
- How to check it in practice
### 2. [Second Aspect]
[same as above]
### 3. [Third Aspect]
[same as above]
## Comparison of popular models
| Name | Spec1 | Spec2 | Price | Review |
| --- | --- | --- | --- | --- |
| Model A | | | | |
## FAQ – frequently asked questions
Q: [Question that appeared in Google Trends]
A: [Specific answer]
## User Reviews
"User story, why they bought it, what are their experiences"
指南3:实施 Schema.org 对于该产品
<!DOCTYPE html>
<html>
<head>
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "Power Bank 20000 mAh SuperCharge",
  "image": ["https://...1.jpg"],
  "description": "Power bank under 35 EUR with fast charging",
  "brand": {
    "@type": "Brand",
    "name": "TechBrand"
  },
  "offers": {
    "@type": "Offer",
    "url": "https://...product",
    "priceCurrency": "EUR",
    "price": "29.99",
    "availability": "https://schema.org/InStock"
  },
  "aggregateRating": {
    "@type": "AggregateRating",
    "ratingValue": "4.7",
    "ratingCount": "348",
    "bestRating": "5",
    "worstRating": "1"
  },
  "review": [
    {
      "@type": "Review",
      "author": {
        "@type": "Person",
        "name": "User John"
      },
      "reviewRating": {
        "@type": "Rating",
        "ratingValue": "5"
      },
      "reviewBody": "Great power bank, highly recommended"
    }
  ]
}
</script>
</head>
</html>
因此,AI确切知道:
- 价格是多少
- 有多少评价
- 是否有货
- 用户对该产品的评价
Query Fanout在现实场景中的应用
场景1:客户寻找“比较”
"碎石自行车或公路自行车——选择哪一种?"
AI生成的子查询:
- "碎石自行车——是什么,用于什么"
- "公路自行车——参数、用途"
- "碎石自行车与公路自行车——技术差异"
- "用于自行车旅游的碎石自行车或公路自行车"
- "碎石自行车或公路自行车——波兰的价格"
- "观点——哪种自行车更适合初学者"
- "测试——碎石自行车与公路自行车的抓地力"
您的网站应包含什么内容才能出现:
- 定义(碎石+公路)
- 表格中的比较
- 真实用户评价
- 价格(链接到商店)
- 实践测试
- 每种类型适合谁
场景2:客户有具体问题
子问题:
- "无线耳机为什么耗电很快"
- "蓝牙耳机——如何延长使用时间"
- "哪种耳机续航最长"
- "更换耳机电池——是否可能"
- "耳机电池问题——论坛"
您的内容应包括:
- 原因(为什么会发生)
- 指南(如何延长寿命)
- 电池最佳的手机对比
- 服务信息
- 技术建议(电池校准)
场景3:客户比较品牌
“小米或三星 - 2025智能手机”
子问题:
- “小米 vs 三星 - 规格对比”
- “小米或三星 - 专家推荐”
- “小米 - 用户评论 2025”
- “三星 - 用户评论 2025”
- “小米或三星 - 哪个更适合拍照”
- “小米 vs 三星 价格”
- “小米 vs 三星 在波兰的服务”
它应包括:
- 表格中的技术对比
- 编辑观点
- 相机照片(拍照对比)
- 波兰商店的价格
- 服务可用性
- 保修
技术 - 代码和实现
代码1:从GPT-5生成子查询(python)
import openai

def generate_sub_queries(main_query, num_queries=10):
    """
    Generates sub-queries for the main question
    """
    prompt = f"""
    You are an expert in SEO and AI Search Optimization.
    The user asked the following question:
    "{main_query}"
    Generate {num_queries} related sub-queries that the user
    might have had in mind or that an AI Mode could generate.
    The sub-queries should cover:
    - Definitions and explanations
    - Comparisons and alternatives
    - Prices and availability
    - Reviews and experiences
    - Problem-solving
    Return only the list of sub-queries, one per line.
    """

    response = openai.ChatCompletion.create(
        model="gpt-5",
        messages=[
            {"role": "user", "content": prompt}
        ],
        temperature=0.7,
        max_tokens=1000
    )

    sub_queries = response.choices[0].message.content.strip().split('\n')
    return [q.strip() for q in sub_queries if q.strip()]

# Example usage:
main_q = "Which power bank to choose under 50 EUR"
subs = generate_sub_queries(main_q)

for i, sub in enumerate(subs, 1):
    print(f"{i}. {sub}")

# Result:
# 1. How many mAh should a phone power bank have
# 2. Power bank 20000 mAh vs 30000 mAh – which is better
# 3. Best power banks under 43 EUR 2025
# etc.
代码2:Query Fanout模拟——多渠道搜索(python)
import asyncio
from typing import List, Dict

class QueryFanoutSimulator:
    """
    Simulates query fanout operation
    """
    def __init__(self):
        self.databases = {
            'products': self.search_products,
            'reviews': self.search_reviews,
            'forums': self.search_forums,
            'prices': self.search_prices,
            'youtube': self.search_youtube
        }

    async def execute_fanout(self, main_query: str, sub_queries: List[str]) -> Dict:
        """
        Executes query fanout for the main question
        """
        print(f"Main query: {main_query}\n")
        print(f"Generated sub-queries ({len(sub_queries)}):")
        for sq in sub_queries:
            print(f"  - {sq}")

        print("\n--- Simultaneous searching ---\n")

        # For each sub-query, we search all databases simultaneously
        tasks = []
        for sub_query in sub_queries:
            for db_name, search_func in self.databases.items():
                tasks.append(
                    self._search_with_metadata(db_name, search_func, sub_query)
                )

        # Execute all simultaneously
        results = await asyncio.gather(*tasks)

        # Aggregation of results
        aggregated = self._aggregate_results(results)
        return aggregated

    async def _search_with_metadata(self, source: str, search_func, query: str):
        """
        Search with metadata (which source, ranking)
        """
        results = await search_func(query)
        return {
            'source': source,
            'query': query,
            'results': results,
            'count': len(results)
        }

    async def search_products(self, query: str) -> List[Dict]:
        """Simulation of product search"""
        await asyncio.sleep(0.5)  # Delay simulation
        return [
            {'title': f'Product A for "{query}"', 'rank': 1},
            {'title': f'Product B for "{query}"', 'rank': 2}
        ]

    async def search_reviews(self, query: str) -> List[Dict]:
        """Simulation of reviews search"""
        await asyncio.sleep(0.3)
        return [
            {'title': f'Review: {query}', 'rank': 1, 'rating
代码3:段落提取(python)
import re
from typing import List

def extract_passages_for_fanout(content: str, query: str) -> List[str]:
    """
    Extracts content passages that answer the sub-query
    """
    # Splitting into paragraphs
    paragraphs = content.split('\n\n')
    relevant_passages = []

    for para in paragraphs:
        # Searching for important words from the query
        score = calculate_relevance(para, query)

        if score > 0.6:  # Threshold: 60% relevance
            # Limiting to 2-3 sentences (fragment)
            sentences = para.split('. ')
            passage = '. '.join(sentences[:3]) + '.'

            relevant_passages.append({
                'text': passage,
                'score': score,
                'length': len(passage)
            })

    # Sorting by score
    relevant_passages = sorted(
        relevant_passages,
        key=lambda x: x['score'],
        reverse=True
    )

    return relevant_passages[:5]  # Top 5 fragments

def calculate_relevance(text: str, query: str) -> float:
    """
    Calculates how relevant the text is to the query (0-1)
    """
    query_words = query.lower().split()
    text_lower = text.lower()

    # Generator expression to count matches
    matches = sum(1 for word in query_words if word in text_lower)

    relevance = matches / len(query_words) if query_words else 0
    return min(relevance, 1.0)  # Max 100%

# Example usage:
content = """
A power bank is a device that stores energy and charges your phone.

20000 mAh means capacity – the more mAh, the more times it charges the phone.

A power bank for office work should be compact and convenient.

Our power bank weighs only 300 grams and fits in a handbag.

Fast charging is an important feature. Our model supports 65W fast charging.
"""

passages = extract_passages_for_fanout(content, "power bank for office work")

for i, p in enumerate(passages, 1):
    print(f"{i}. (score: {p['score']:.2f})")
    print(f"   {p['text']}\n")

# Result:
# 1. (score: 0.80)
#    A power bank for office work should be compact and convenient.
#
# 2. (score: 0.40)
# Our power bank weighs only 300 grams...错误与陷阱
错误1:只为人类写作,而非为AI
缺点:
2025 Bestseller Power Bank! Our products guarantee satisfaction.
Buy now and save 10 EUR. Free shipping on orders over 30 EUR...
为什么不好?AI模式不知道:
- 它是为手机还是笔记本电脑设计的充电宝
- 它的容量是多少毫安时(mAh)
- 它的价格是多少
- 它有什么样的评价
好的网站:
## What is a 20000 mAh power bank?
A power bank is a charging device with a capacity of 20000 mAh.
### How many times will it charge a phone?
- iPhone 14: 6 times
- Samsung S24: 5 times
### Price
40 EUR (promotion from 47 EUR)
### Reviews
Rating: 4.8/5 (348 reviews)
AI可以从这里提取信息:容量、用途、价格、评价。
错误2:文章未完成
许多商店的文章如“文章正在准备中”或“即将上线”。这对AI模式来说是不可见的——文章被忽略了。
规则: 发布完整文章。如果没有时间,许多短文章比一篇未完成的长文更好。
错误3:没有结构化数据
Without Schema:
Headphones cost 70 EUR
With Schema:
<span itemscope itemtype="https://schema.org/Offer">
  <span itemprop="price">70</span>
  <span itemprop="priceCurrency">EUR</span>
</span>
没有Schema,AI可能会误认为这是年份或型号。有了Schema——它就知道这是价格。
错误4:复制竞争对手
如果所有商店都写得一模一样(“最好的充电宝是...”),那么谁也不会脱颖而出。Query Fanout更青睐 独特的视角。
最佳实践:
- 你的故事(你是如何产生这个想法的)
- 您的测试(您自己检查过)
- 您的观点(您认为)
这个AI会更容易接受。
常见问题解答 - 频繁提出的问题
Query Fanout是否适用于所有行业?
不适用。它最适用于决策复杂的行业:
- 电子商务(产品选择)
- 旅游(旅行规划)
- 技巧(如何做某事)
- 教育(学习某事)
不太适用:
- 事实查询(“谁在2025年成为波兰总统?”)
- 实时信息(天气、汇率)
采用Query Fanout适应商店需要多长时间?
对于小型商店(50-100个产品):2-4周,中型(1000个产品):2-3个月,大型(10000+个产品):6个月以上。这不是一次性工作——而是一个持续的过程。
一个传统上排名良好的产品是否会在AI模式下可见?
通常会,但不总是。AI模式的标准与传统SEO不同。您可能在传统搜索中排名很高,但在AI模式下不排名(或反之亦然)。这就是为什么两种策略都很重要。
Query Fanout是否改变了从Google Ads获取流量的方式?
目前没有——Google Ads仍然有效。但长期来看,如果越来越多的人使用AI模式而不是传统搜索,商业模式可能会改变。值得投资其他渠道(电子邮件、社交媒体、合作伙伴关系)。
ChatGPT是否也使用Query Fanout?
ChatGPT使用了一种高级版本(要求用户解释、内部自行分解查询)。但它没有像Google AI模式那样的可见度。其他工具:
- Perplexity AI - 明确使用Query Fanout
- Claude - 有自己的方法
- 商店聊天机器人 - 可能有简化版本
我的内容必须完全出现在我的网站上吗?
不必。AI 模式也可以引用其他来源的段落。但如果你有自己的网站——这将大大增加在回复中获得可见度的机会。
AMP 或移动优先对 Query Fanout 是否重要?
是的,但不像传统 SEO 那样重要。AI 模式的关键因素包括:
- 检查内容的能力
- 数据结构
- 权威性
- 更新
但站点的速度并不一定重要(尽管快速的网站总是有帮助的)。
我现在应该雇用一位文案撰写者吗?
如果你以前没有这样做过——是的。Query Fanout 需要大量高质量的内容。一位文案撰写者应每周写一篇文章(至少)。
术语表
AI 模式 - Google 搜索模式,其中答案由 AI 生成(而不是链接列表)
聚合 - 将来自多个来源的结果合并为一个答案
Asyncio - 用于并发执行任务的 Python 库
权威性 - Google 认为网站在特定主题上是可信的知识
反向链接 - 来自其他网站到你的链接
聊天机器人 - 与用户交谈的程序
分块(片段) - 一小段文本(例如,一个段落)
核心查询 我们从的主要问题
分解 - 将一个问题分解为许多更小的问题
嵌入 - 将文本转换为表示意义的数字(向量)
扩散 - 传播,原子化(此处:查询的传播)
Gemini - 谷歌的AI模型(相当于ChatGPT)
生成器(LLM) - 生成文本的AI模型
幻觉 - AI编造不存在的信息
意图识别 - 识别用户真正想要的内容(不仅仅是他们写的)
LLM(大型语言模型) - 大语言模型(ChatGPT、Gemini、Claude)
段落提取 - 提取文本中相关的部分
查询 - 问题,查询
查询分解 - 将一个问题分解为子问题
Query Fanout - AI将问题传播为多个子查询
RAG(检索增强生成) - 信息检索+答案生成
倒数排名融合(RRF) - 一种将来自多个来源的结果进行合并的算法
相关性 - 结果是否与查询相关
检索 - 搜索,查找信息
Schema.org - 页面数据标记的标准
语义学 - 词汇和文本的含义
SEO - 搜索引擎优化
子查询 - 子查询,较小的问题
综合 - 将来自多个来源的信息进行合并
向量数据库 - 存储文本为向量的数据库
向量相似度 - 两个文本的相似程度
清单 - 在您的网店中应该做什么?
- 分析 - 检查 Query Fanout 如何为您的主要产品工作(在 Google AI 模式中搜索)
- 映射 - 为前10个产品创建子查询列表
- 内容审核 - 检查哪些页面已经包含解决子查询的片段
- 结构 - 重新组织产品页面:添加常见问题、添加表格中的比较、添加用户评价、添加“你需要知道”的部分
- 模式 - 在所有产品页面上实施 Schema.org
- 内容 - 为顶级类别撰写“购买指南”文章
- 反向链接 - 开始建立权威(在外部网站上发布文章)
- 监控 - 跟踪 AI 模式下的可见度(新工具使这成为可能)
- 迭代 - 分析子查询并每月更新内容
总结
Query Fanout 并非未来——它已经是现在。截至 2025 年 5 月,Google AI 模式已投入生产,竞争对手也在跟进(ChatGPT、Claude、Perplexity)
需要记住的关键点:
- Query Fanout 将一个问题分解为子查询 - AI 同时查找它们
- 传统 SEO 仍然存在 - 但一个新的渠道出现在它旁边(AI 模式下的可见度)
- 内容结构正在改变 - 不再是为一个关键词写一段文字,而是撰写涵盖多个方面的完整指南
- Schema.org 现在是必须的 - AI 必须理解页面上的数字和文字的含义
- 权威性比以往更重要 - AI 更青睐在响应中反复出现的来源
- 这是一场马拉松,不是短跑 - 慢慢实施,测试,迭代
Query Fanout 为你商店提供了新的可能性。你不必是程序员——你可以从分析 Query Fanout 如何用于你的产品开始,映射子查询,并准备更好的内容。
其余的将会自然发生。
来源
- Google I/O 2025 - Elizabeth Reid,Google Search 主管 - "AI 模式和 Query Fanout 技术"
- fillrank.co.uk, Senuto.com, seo-www.pl, digital.rp.pl, 4media.com
- Google AI 模式官方
- Microsoft Azure AI 文档
- Haystack.deepset.ai - 高级 RAG 模式
- OpenAI API 文档 - LLM 提示
分享:
