

查看你公司的 AI 可见度
免费,无需信用卡。
Semly研究的关键发现
在AI中,品牌可见度应根据提问者的需求及其与模型的对话过程来评估。一个品牌出现在一般查询的答案中,并不表明系统是否向适合其产品或服务的用户推荐该品牌。在Semly的方法中,Leon扮演由人物画像定义的用户角色,并通过对话构建上下文,然后提出目标购买问题。
在Semly,我们正在通过AI 智能体Leon开发这种方法。六个月来,我们对查询ChatGPT和Gemini进行了研究和实验。本报告提供的数据集涵盖120万次查询、24个聚合记录和12组匹配对比。分析包括六个群体和2种内容准备方法:不使用人物画像和使用人物画像。
在没有人物画像的情况下,达到相同可见度目标的平均时间为100天,在使用人物画像的情况下为70天。这代表了30%的减少,即平均减少30天。内容相关性从61.5%提高到77.5%——增加了16个百分点。我们在两个系统中观察到了相同的方向差异。
这些发现支持在内容规划和可见度分析中使用人物画像。它们为更具体的简报提供了基础:材料是为谁准备的,应解释哪些选择标准,以及应解决哪些异议。回答的可重复性和转化影响需要单独的指标;该数据集未提供这两者的数值效果。
| 信息 | 价值 | 基础 |
|---|---|---|
| 范围 | 六个月、ChatGPT和Gemini | Semly的研究描述 |
| 数据集中的查询 | 1 200 000 | 测量开始和结束时的查询计数器总和 |
| 对比结构 | 24个记录,12对 | 6个群体 × 2个系统 × 2种方法 |
| 达到目标的平均时间 | 100天 vs 70天 | 减少30% |
| 内容相关性 | 61.5% 对 77.5% | 16 个百分点;每种方法 1200 次评估 |
| 可重复性和转化率 | 数据集中没有数值指标 | 独立的评估领域 |
为什么仅凭一个问题无法描述客户的需求
查询“我在哪里可以买到舒适的跑步鞋?”并未明确表面、体验、预算或预期用途。因此,推荐可能涵盖广泛的产品类别,而品牌需要知道它是否触及了休闲森林跑步者、初学者在铺装路线上跑步或竞技跑步者等不同用户群体。
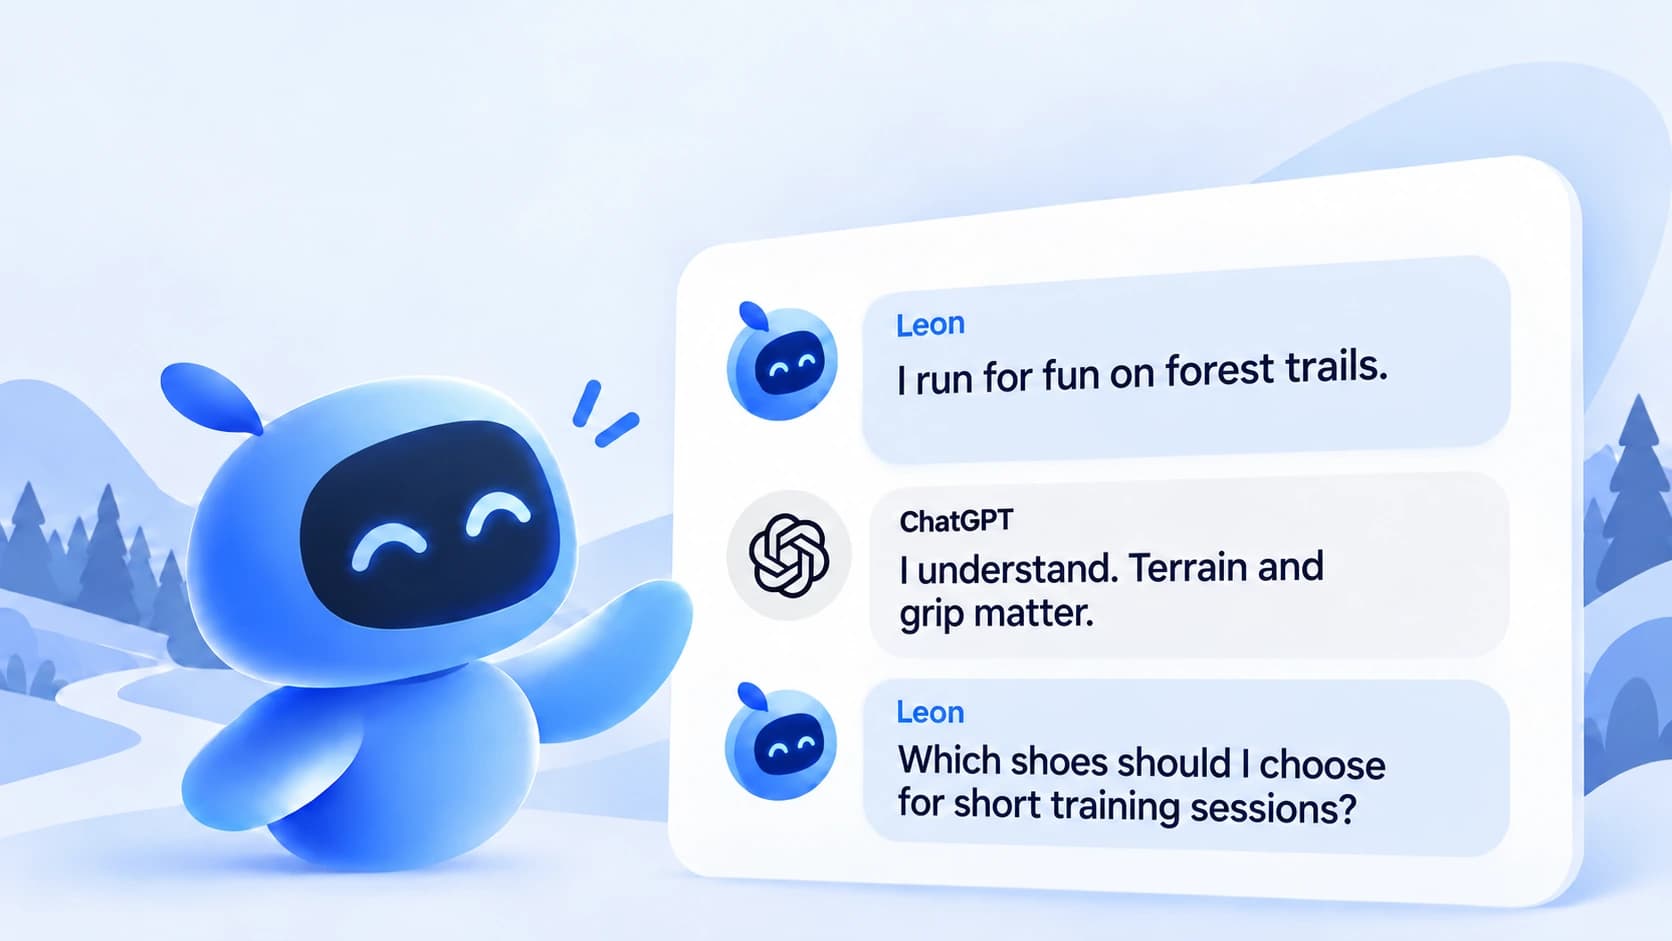
“我主要在森林小径上休闲跑步,需要适合短时间训练的鞋子”这一陈述缩小了情境范围。在 Semly 的方法中,Leon 可以在对话开始时引入这一背景,并在解读回复后转向目标问题。主要购买需求保持不变,但衡量条件包括对话中的人物角色、意图和先前消息。当解释可见度的增加或减少时,这一点很重要。
人物角色定义了用户的职责和场景,Leon 在与模型对话时会使用这些信息。该智能体在该对话中构建自己的上下文,使研究更贴近人们使用聊天的方式。它不会重建特定真实用户的完整历史记录。值得从与产品相关的需要和限制开始。年龄、性别和其他人口统计特征应由研究场景加以合理化。
官方 OpenAI 和 Google 指导表明,相关上下文有助于定义任务及其约束条件 [1][2]。这为设计查询提供了基础。
AI 智能体 Leon 如何将品牌知识与用户上下文联系起来
Leon 从关于品牌、其产品、服务和现有内容的知识中创建人物角色。然后他以匹配所选档案的用户身份参与研究。他开始一次对话,向模型介绍自己并解读其回复。基于此,他能识别何时可以带着上下文和意图提出目标提示。结果回答了一个实际问题:AI 是否会在与需求匹配的用户的对话中包含该品牌?
Leon 的角色连接了监控与内容规划。回复可以揭示选择标准、异议和模型用于证明推荐的信息。如果品牌网站缺少特定场景的信息,分析可以导致简短的内容缺口识别。
Leon 以用户身份进行对话
Leon 进行的研究遵循一次对话的流程。该智能体首先以研究中选定的人物角色身份向模型介绍自己。这确立了用户的状况和需求。在收到回复后,他阅读并将其与对话目标相关联进行解读。
解读回复是智能体操作的一部分。Leon 评估是否可以转向目标问题。其时机取决于对话的进程和所收到的回复。目标提示包含用户的上下文和意图,并出现在模型已了解用户先前信息的对话中。
这种方式更贴近人们使用聊天的方式。用户描述其情况,阅读回复并基于此提出下一个问题。Leon 在研究中扮演这一角色,使品牌推荐可以在展开的对话中进行分析。
意图定义了用户希望做出的决策。在跑步示例中,上下文可能是森林小径上的休闲跑步,意图是选择和购买合适的鞋子。Leon 在解读了早期回复并确定可以提出目标问题后,会请求推荐。
在解释结果时,整个对话历史都变得相关。如果最终问题中出现相同的措辞,但早期消息引入了不同的需求,则可能产生不同的回复。因此,研究应识别目标提示及其被提出时的对话。
过程描述解释了 Leon 的角色以及为什么研究类似于聊天交互。然而,提供的汇总数据并未将引入自己、解读回复或选择提问时机的效果单独分离出来。我们无法将 30% 和 16 个百分点的结果分别归因于这些阶段中的任何一项。
| 对话阶段 | Leon 的行动 | 研究意义 |
|---|---|---|
| 引言 | 假设由人物角色定义的用户角色并开始对话 | 确立用户的情况和需求 |
| 模型回应 | 接收并解读回复 | 考虑对话的进程 |
| 决定下一个问题 | 识别何时提出目标提示 | 根据回应调整时机 |
| 带有意图的提示 | 在该对话中提出带有上下文和意图的目标问题 | 使用户情境中的推荐评估成为可能 |
30%的时间减少意味着什么
该数据集假设初始可见度为20%,目标为40%。可见度定义为推荐该品牌回应的数量除以查询数量。这代表了20个百分点的增长。方法描述了内容的准备方式;结果根据数据集假设在相同的评估目标和问题面板上进行评估。
没有人物角色的情况下,达到目标的平均时间为100天,有人物角色的情况下为70天。我们将减少量计算为(100 - 70)/ 100 × 100%,即30%。差异为30天。精确描述为“达到相同目标所需时间减少30%”。
对于一个团队构建可见度的情况,这可能意味着从识别需求到实现预期结果的周期更短。操作上的解释很重要:更精准的内容可能减少对连续修订的需求。然而,数据集并未将编辑工作时间或差异的个体原因分离出来,因此我们不将整个效果完全归因于Leon的自动化。
所提供的数据包含基础可见度、最终可见度和达到目标的时间,但没有每日可见度时间序列。因此图表显示了达到共享结果的时间。我们不使用这些数据来绘制曲线,表明效果以恒定速率累积。
图表1. 达到共享目标40%可见度的平均时间:100天和70天。基础:Semly数据中的12个匹配比较。差异:30天,减少30%。
内容相关性和答案准确性是不同的衡量标准
在此数据集中,内容相关性是指评估材料中与人物角色需求一致的比例。每条记录包括100次评估。没有人物角色的情况下,总数为1200次评估中的738个相关材料;有人物角色的情况下,1200次评估中的930个。这分别对应61.5%和77.5%。
差异为16个百分点。相对于61.5%的基准,相对增长约为26.0%。这是描述同一数据集的两种方式,但不是相同的单位。文本和图表中使用的主度量标准仍然是百分点差异。
内容相关性不等同于模型回应的真实性。一个回应可能符合用户需求,但包含错误的产品规格。因此应单独评估答案准确性:模型是否考虑了需求、推荐是否合适,以及陈述的事实是否有来源支持?
77.5%的结果显示,在人物角色方法中,符合用户需求的材料比例更高。这支持将内容选择描述为在此数据集中更为相关。由于仅提供了汇总数据,而没有个体评估或详细的评分标准,报告不声称统计显著性,也不将内容相关性等同于每个AI回应的事实准确性。
图表2. 内容相关性:61.5%和77.5%,差异为16个百分点。基础:Semly数据中每种方法的1200次评估。该指标描述了与人物角色需求的一致性;它不是转化率。
ChatGPT和Gemini的结果
对于 ChatGPT,不使用人物画像时的平均目标时间是 95 天,使用人物画像时是 66.5 天。对于 Gemini,分别是 105 天和 73.5 天。两种系统都显示减少 30%。比较结果表明,分析的各组之间存在相同方向的差异。
ChatGPT 记录中的内容相关性,不使用人物画像时为 60.5%,使用人物画像时为 76.5%。Gemini 的数据分别为 62.5% 和 78.5%。每个系统中的差异为 16 个百分点。每种系统与方法的组合包括 600 次内容评估。
按系统分离结果是为了检查总体平均值是否掩盖了不同的结果。在此数据集中,不同方法之间的差异在 ChatGPT 和 Gemini 中是一致的。这并非对模型本身的质量排名:时间与相关性描述的是分析的活动和内容。
在实践中,为每个系统维护独立的可见度档案是有用的。相同的内容和用户需求可能以不同方式呈现。然后可以将 Leon 的推荐与特定系统和场景进行对比,而无需将品牌整体存在简化为单一数字。
图表 3. ChatGPT 和 Gemini 的平均达到共享目标的时间。基础:每种系统 6 组匹配比较,Semly 数据。结果描述的是分析的方法,而非模型质量的排名。
| AI 系统 | 不使用/使用人物画像的时间 | 不使用/使用人物画像的相关性 |
|---|---|---|
| ChatGPT | 95 / 66.5 天 | 60.5% / 76.5% |
| Gemini | 105 / 73.5 天 | 62.5% / 78.5% |
六组结果
该数据集涵盖 M1-M6 组。在每组内计算两种系统的平均目标时间,不使用人物画像时分别为 75、85、95、105、115 和 125 天。使用人物画像时分别为 52.5、59.5、66.5、73.5、80.5 和 87.5 天。
对于较短和较长的目标时间,两种方法之间的差异都可见。M1 中为 22.5 天,M6 中为 37.5 天。在所提供的数据集中每一对中,使用人物画像的时间是不使用的 70%。我们明确展示这种固定关系;我们不将其视为模型响应可重复性的度量。
M1-M6 描述的是组,而不是一个品牌连续六个月的可见度读数。不应将递增的时间解释为连续月份效果的下降。分析季节性和时间变化需要日历日期和每日或每周读数。
完整的到达目标时间评估还应报告在观察结束前未达到阈值的案例。所提供的数据集未单独识别此类案例。在设计未来比较时应考虑这一点。
图表 4. 六组目标时间的平均值,两种系统平均,Semly 数据。M1-M6 组并非一个品牌连续的每月可见度时间序列。
多个人物画像中的同一问题
作为 Semly 工作的一部分,我们还研究了在多个不同人物画像中提出相同的基本问题。Leon 作为用户匹配每个档案并进行对话,然后提出目标问题。这有助于识别需求、意图和早期上下文如何影响推荐以及对购买决策有用的信息。对于跑鞋问题,场景可能包括在铺装路线上跑步的初学者、休闲森林跑步者和进行更长徒步训练的人。下面的矩阵展示了该方法的使用方式。这不是研究响应的摘要。
对于每次回应,记录推荐的品牌、选择理由、技术要求、异议和引用的网址是有用的。比较显示了哪些信息在不同场景中重复出现,哪些是特定需求的。然后简报可以包括一个共同的核心和额外的部分来解决差异。
Semly 使用多个人物画像工作中的观察结果作为更相关的内容推荐的基础。然而,所提供的数据集不包括人物画像标识符、完整提示或模型响应。因此报告无法将数值效应归因于特定人物画像或对推荐的品牌进行排名。
| 示例场景 | 回应分析的问题 | 可能的内容范围 |
|---|---|---|
| 初学者,短铺装路线 | 是否提到了舒适度和合脚性标准? | 选择第一双鞋时的尺码和用途 |
| 在森林小径上进行休闲跑步 | 回应是否考虑了表面和抓地力? | 地形条件与鞋底对比 |
| 较长的小径训练时段 | 模型识别出哪些约束和规格? | 为长时间用力选择选项的比较 |
多个角色的回应如何形成内容摘要
对话可以在最终推荐之前提供摘要所需的信息。早期的回应可能揭示需要解释的标准,而Leon的目标问题将它们与用户的意图联系起来。分析整个对话有助于识别决策后续阶段的有用内容。
首先,应将选择标准与品牌名称分开。仅推荐公司的列表并不能解释它们为何出现。特定用户需要应用程序比较、兼容性说明或明确退货条件的信息对编辑团队更有用。
接下来,应将这些需求与品牌材料进行比较。对重要问题的缺失回答可能证明需要更新现有页面。用户群体之间的差异可能证明需要单独的部分或比较。决策应反映对人们的实用性,而不是机械地为每个角色复制页面。
一个示例摘要可能包括用户的场景、要做出的决定、关键标准、可验证的产品数据、异议和来源。如果分析涉及森林小径,材料应解释产品的用途和限制。
这样准备的内容可能对从AI回应到达的用户更有相关性。这支持了更好的转化率假设。确认需要在实施后比较用户行为和销售结果。
可重复性需要重复测量
固定的角色描述和一致的对话规则可以使测量更容易比较。由于Leon在提出目标问题之前解释了回复,因此对话历史和决策规则也必须受到控制。过程可重复性和最终回应之间的一致性应分别进行测量。
建议的测试应保留相同的模型版本、搜索模式、语言、位置和会话开始规则。比较使用相同角色和目标启动的完整对话以及上下文完全重建的回应是有用的。第一种比较评估整个流程的变化;第二种有助于评估最终回应的变化。基准面板和角色面板应并行运行。
可能的指标包括品牌存在的稳定性、推荐品牌集之间的协议和引用来源之间的协议。对于两个品牌集A和B,简单的协议度量是两个回应中所有品牌集合中共同品牌的份额。两个集合都为空的情况需要单独的报告规则。
一个角色内的可重复性和角色之间的差异解决了不同的问题。一个配置文件的稳定推荐可以与不同配置文件之间的明确差异共存。Leon的结构化角色描述有助于维持更一致的查询条件。然而,所提供的数据集中没有关于连续回应之间协议的测量,因此我们无法量化可重复性的改进。
如何验证对转化的影响
业务测量应区分答案中的品牌存在、网站引用、用户访问网站以及完成操作。每个阶段都需要自己的指标。推荐数量不是访问数量,而访问数量也不是购买数量。
实施内容后,跟踪来自可识别AI来源的会话、参与度、查询、交易和收入是有用的。一些流量可能没有明确的来源标签,因此应描述可识别会话的范围。转化率必须使用明确定义的分母,例如合格会话。
比较相似页面或内容组,使用一致的转化定义和观察窗口,支持更可靠的评估。其他变化,如促销、价格、产品可用性和活动,必须记录下来。否则,销售增长可能错误地归因于内容策略的变化。
因此报告提出了一个具体假设:与真实用户需求相关的内容可能帮助人们做出决策。其销售影响的大小仍有待测量。电子表格中没有会话、潜在客户或交易。
可见度结果的方法论变化意味着什么
引入人物画像和Leon的对话改变了模型查询的方式。目标提示的响应还会考虑之前的对话内容。当品牌更好地匹配明确需求时,结果可能会提升;而当系统选择其他产品时,结果可能下降。因此,比较时应同时考虑问题措辞和对话上下文的准备方式。
最清晰的方法是将基准面板与人物画像面板的结果并排展示。如果需要综合平均值,则人物画像的权重应基于对受众的明确假设。相等权重是一种简单的分析选项,但并不能证明每个群体在实际需求中占相等份额。
在选择人物画像时,与需求的匹配度也很重要。仅从产品角度构建的画像可能会忽略购买障碍或产品不适用的情况。相反,应包括具有挑战性的场景,而不是仅围绕那些容易推荐该品牌的目标用户设计面板。
报告摘要
Semly的研究表明,引入人物画像有助于内容与用户需求对齐,并减少AI可见度建设所需的时间。在分析的数据集中,未使用人物画像时达到共享可见度目标的平均时间为100天,使用人物画像后为70天——减少了30%。内容相关性从61.5%提高到77.5%,即提升了16个百分点。同样的差异方向也在ChatGPT和Gemini中观察到。
Leon为这种方法赋予了对话形式。智能体扮演用户角色:他根据人物画像介绍自己,解释模型的回复,并识别何时在上下文和意图下提出目标问题。这使Semly能够更贴近人们使用聊天的方式分析推荐结果。
在多个不同人物画像中查询相同的基础问题,可以识别出不同的选择标准、异议和信息需求。这些观察结果可以为更具体的简报、比较和材料提供支持,帮助用户做出决策。更高的内容相关性支持这种方法;转化影响则需要通过单独测量用户行为和业务结果来验证。
一致的人物画像和对话规则为可比较的监控提供了基础。然而,回答的可重复性仍需通过进一步的测量来评估,这些测量需考虑对话历史和查询条件。所展示的结果并未量化可重复性的提升或转化的增加。
对品牌而言,实际影响是明确的:研究AI将推荐给谁以及在什么情境下推荐,然后利用这些信息来制定内容。Semly因此将可见度监控工具与关于上下文、意图和模型推荐的研究联系起来。
来源
Semly材料:"超过一百万个查询,六个月的研究。为什么Semly要为AI可见度监控引入人物画像",并附上Semly对Leon对话的描述——智能体和研究描述的来源。
[1] OpenAI, Prompt engineering. 关于在查询中提供相关上下文的指导。 https://developers.openai.com/api/docs/guides/prompt-engineering
[2] Google AI for Developers, Prompt design strategies. 关于上下文和任务约束的指导。 https://ai.google.dev/gemini-api/docs/prompting-strategies
[3] Franziska Weeber, Vera Neplenbroek, Jan Batzner, Sebastian Padó, One Persona, Many Cues, Different Results: How Sociodemographic Cues Impact LLM Personalization, ACL 2026. https://aclanthology.org/2026.acl-long.2079/
分享:
