

Scopri se l'AI vede la tua azienda
Esegui un audit gratuito
Aggiornato il 20 ottobre 2026.
Hai centinaia di risposte AI da esaminare. Vuoi capire quali consigliano la tua azienda, quali si limitano a citarne il nome e quali riportano informazioni errate sull'offerta. Un semplice conteggio delle menzioni del marchio non basta. Serve un metodo di valutazione ripetibile.
Jev di TypeSafe AI può svolgere in questo processo il ruolo di modello valutatore. Riceve il materiale e domande definite con precisione, poi restituisce risultati che un programma può confrontare, contare e indirizzare alle attività successive. Nella GEO può essere un supporto utile per analizzare le risposte dell'AI generativa.
La precisazione più importante: il modello valuta ciò che gli fornisci. Il risultato non dimostra che il marchio abbia una determinata visibilità nell'intero web. Questa guida descrive possibili applicazioni e come verificarle. Non presenta un test di Jev né un'integrazione confermata con Semly.
Che cos'è Jev e che rapporto ha con la GEO?
TypeSafe descrive Jev come un modello della categoria System One, progettato per valutazioni rapide e circoscritte. Invece di scrivere un articolo o un'analisi estesa, restituisce una risposta strutturata a una domanda. La base è il contesto, chiamato “state” nell'API, insieme alla descrizione di ciò che va valutato. Fonte: introduzione a Jev.
La GEO, Generative Engine Optimization, comprende il lavoro sulla presenza di un marchio e dei suoi contenuti nelle risposte dell'AI generativa. Jev può aiutarti a organizzare il materiale su cui basi le decisioni. Non è un ambiente in cui ottenere un posizionamento come su un motore di ricerca. Non sostituisce neppure un sistema che raccoglie risposte da ChatGPT, Gemini o Perplexity.
Una divisione utile dei ruoli è questa: un processo separato raccoglie risposte e fonti, Jev valuta caratteristiche specifiche, il programma applica le regole e una persona verifica i casi che richiedono interpretazione. Se poi occorre riscrivere un passaggio di una pagina, si tratta di un'attività editoriale successiva.
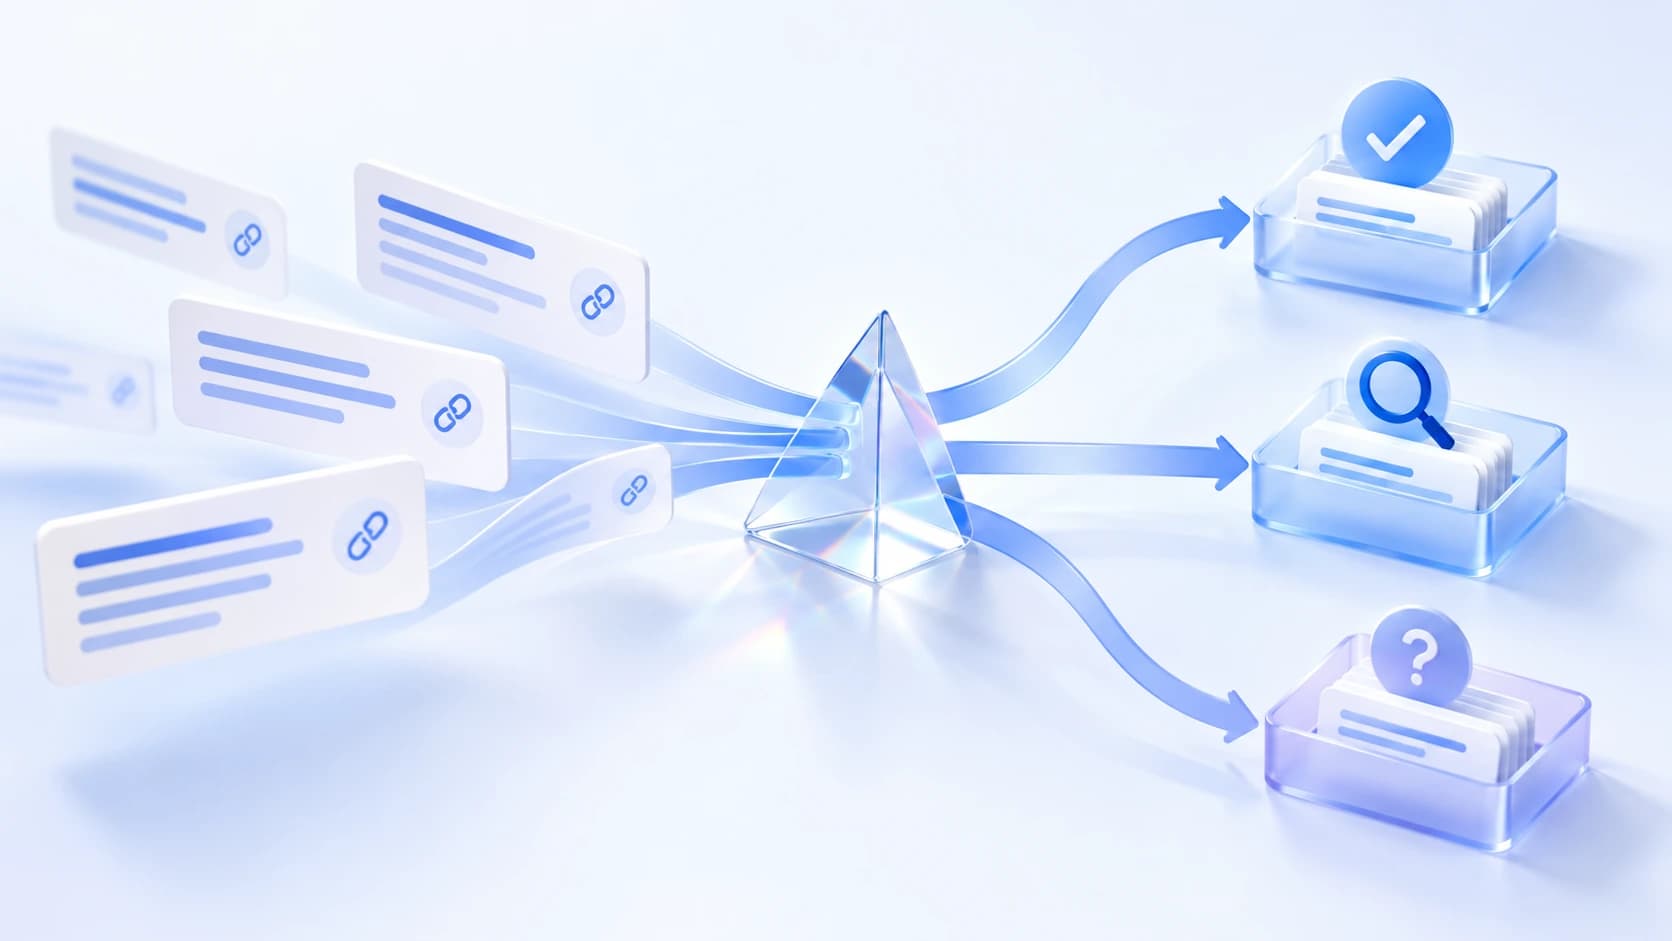
Schema illustrativo: conservazione della risposta, domande indipendenti e verifica del risultato. Elaborazione originale basata sulla documentazione TypeSafe. L'animazione mostra un processo proposto, non il funzionamento di un'integrazione già disponibile.
Choice, Score e Noul: tre modi di porre domande
Scegli il tipo di domanda in base alla decisione che vuoi realmente prendere. “Questa risposta è buona?” è troppo generico. Puoi suddividerla in presenza di una raccomandazione, correttezza dei fatti e completezza rispetto alle esigenze del cliente.
| Tipo | Quale domanda? | Esempio nella GEO |
|---|---|---|
| Choice | Quale delle categorie descritte? | Menzione neutra, raccomandazione o sconsiglio. |
| Score | Quale livello della scala descritta? | Nessuna risposta, risposta parziale o tutte le condizioni. |
| Noul | L'affermazione indicata è vera? | La risposta raccomanda esplicitamente il marchio indicato? |
Choice seleziona una categoria tra quelle fornite. Le categorie devono essere distinguibili e i criteri devono coprire i casi limite. Se valuti più caratteristiche, per esempio raccomandazione e coerenza con l'offerta, poni domande separate. Documentazione di Choice.
Score richiede di descrivere livelli ordinati. “Non risponde”, “risponde in parte” e “risponde a tutte le condizioni indicate” offrono criteri più chiari di un voto di “qualità da 1 a 10” senza spiegare la scala. Il risultato dipende dalla tua definizione di qualità. Documentazione di Score.
Noul restituisce la probabilità di una risposta “sì”. Un valore vicino a 0,5 segnala incertezza, non un soddisfacimento parziale della condizione. La domanda deve indicare chiaramente che cosa significhi “sì”. Documentazione di Noul.
Che cosa è aggiornato a ottobre 2026?
Secondo la documentazione verificata il 20 ottobre, la versione descritta più recente è Jev 1.14, disponibile dal 14 ottobre 2026. La documentazione distingue gli identificatori di versione dagli alias variabili “latest” e “preview”. Durante i test registra la versione effettiva del modello, perché un cambiamento dell'alias può modificare i risultati. Modelli e versioni di Jev.
Nell'annuncio della versione 1.14, TypeSafe descrive anche il supporto sperimentale per immagini, contesti più ampi e il tipo “box”. Il produttore segnala che queste funzioni non sono ancora pienamente pronte per l'uso in produzione. Per questo il processo di valutazione testuale descritto qui non ne prevede l'impiego. Annuncio TypeSafe del 14 ottobre.
Un formato corretto del risultato non garantisce una valutazione corretta. Il modello può restituire una categoria ammessa e assegnarla al caso sbagliato.
7 applicazioni di Jev nella GEO e nella SEO
Gli scenari seguenti sono proposte di utilizzo del modello, non un elenco di funzioni Semly né risultati di implementazioni. Ciascuno richiede criteri definiti e una verifica dell'accuratezza su materiale adatto al tuo compito.
1. Distinguere menzione, raccomandazione e sconsiglio
La frase “il marchio X opera in questo mercato” non significa la stessa cosa di “per questo utilizzo vale la pena considerare il marchio X”. “Il marchio X non supporta questo utilizzo” ha ancora un altro significato. Tutte contengono il nome dell'azienda, ma solo una è una raccomandazione nel contesto descritto.
Puoi chiedere a Jev di valutare l'atteggiamento di una risposta verso un marchio specifico. Includi nel contesto l'intera domanda dell'utente, perché una raccomandazione può essere condizionata: un prodotto può andare bene per un piccolo negozio senza soddisfare i requisiti di una grande organizzazione.
Registra separatamente presenza del nome, raccomandazione positiva e link. Un link al sito del produttore può accompagnare sia una raccomandazione sia una valutazione critica del prodotto.
I dati di esempio servono a spiegare il metodo e non rappresentano i risultati di alcun marchio. Le etichette nell'animazione e negli esempi successivi sono state preparate dalla redazione e non derivano da chiamate a Jev. Lo stesso principio è spiegato nel testo: menzione neutra, raccomandazione e sconsiglio sono valutazioni diverse, indipendentemente dalla presenza di un link.
2. Valutazione preliminare della coerenza tra affermazione e fonte
Per rilevare un URL conviene generalmente usare regole nel programma. La domanda che richiede una valutazione è: uno specifico passaggio della fonte sostiene una specifica frase della risposta AI?
Suddividi una frase con più promesse in singole affermazioni. Associa a ciascuna il passaggio pertinente della pagina, l'ambito dell'offerta e la data di lettura. Se non è stato possibile recuperare la fonte, segnala il materiale mancante. Non trasformare questa assenza in una valutazione “la fonte non conferma”.
Il modello può indicare in via preliminare coerenza, contraddizione o necessità di verifica, a seconda delle domande progettate. Il metodo completo di audit è descritto separatamente: le fonti citate confermano le informazioni sull'azienda?.
3. Organizzare le domande dei clienti
Domande su prezzo, implementazione, limiti e confronto delle offerte richiedono risposte diverse. La classificazione aiuta a organizzare l'elenco da analizzare e ad assegnarlo alle persone responsabili.
Stabilisci se una domanda può avere più intenti. “Quanto costa l'implementazione e comprende la migrazione?” riguarda sia il prezzo sia l'ambito del servizio. Puoi dividerla in due attività o valutare separatamente le due dimensioni. Un'unica assegnazione forzata può nascondere un'esigenza importante.
Non dedurre automaticamente l'entità della domanda di mercato dal numero di quesiti. Molte formulazioni simili possono provenire dalla stessa fonte e riferirsi a un'unica esigenza.
4. Verificare se una pagina risponde alle condizioni della domanda
Un cliente cerca una soluzione per un uso specifico, con una determinata integrazione e un limite di budget. La pagina descrive il prodotto, ma non chiarisce la compatibilità. Il modello può segnalare preliminarmente questa lacuna secondo la scala di completezza definita.
Valuta ogni condizione separatamente. L'assenza di informazioni su un'integrazione non significa che il prodotto non la supporti. Significa che il contenuto fornito non risolve la questione. Il passo successivo è verificare il fatto e completare la descrizione, se l'informazione è utile al lettore.
Uno Score elevato non è un punteggio di posizionamento Google né una probabilità di citazione da parte di ChatGPT. È una valutazione di un materiale specifico secondo i tuoi criteri.
5. Individuare coppie di pagine da controllare per la cannibalizzazione
Seleziona prima le coppie candidate in base ad argomento, query o somiglianza dei contenuti. Poi puoi valutare se rispondono alla stessa esigenza o aiutano a prendere decisioni diverse.
Il modello deve ricevere la domanda principale, il pubblico e il contenuto di entrambe le pagine. Parole simili nel titolo non bastano. Il risultato deve creare un elenco per la revisione editoriale. La decisione di unire le pagine richiede di considerarne valore, traffico e ruolo nel sito.
Abbiamo descritto una suddivisione pratica degli argomenti nella guida blog e knowledge base senza cannibalizzazione.
6. Valutare l'utilità di un link interno proposto
Tra le pagine candidate da collegare, scegli quelle che aiutano a compiere il passo successivo. Un articolo sulla scelta di una soluzione può rimandare a una guida sulla preparazione dei dati, se al lettore serve dopo la decisione.
La domanda per il modello deve riguardare l'utilità del collegamento in un paragrafo specifico. La sola vicinanza tematica non basta. Il programma può verificare separatamente che l'URL funzioni e il redattore può controllare la naturalezza del testo del link.
7. Inviare promesse e confronti alla verifica
Prima della pubblicazione puoi segnalare i passaggi che contengono prezzi, scadenze, garanzie di risultato o confronti con concorrenti. Rilevarli aiuta a indirizzare il testo a chi conosce l'offerta attuale.
È una fase di controllo, non una conferma automatica della veridicità. Il modello non può stabilire se un'azienda attivi davvero un servizio in un giorno senza una fonte affidabile. Se manca la fonte, l'articolo richiede lavoro editoriale.
Come progettare un processo verificabile?
Inizia da un solo compito, per esempio riconoscere le raccomandazioni di un determinato marchio. Scrivi la definizione di raccomandazione, i casi esclusi e le regole per gestire risposte incomplete. Solo dopo costruisci l'automazione.
Conserva il materiale originale insieme a domanda, nome del prodotto AI, modalità, lingua e data. La valutazione di una frase isolata può differire da quella dell'intera risposta. Mancata risposta, errore di recupero e risposta senza il marchio devono avere etichette separate.
Puoi inviare più domande indipendenti sullo stesso materiale in una sola richiesta. Combina i risultati tramite le regole del programma. Se una domanda successiva richiede dati che recupererai soltanto dopo il primo risultato, serve un'altra fase. Principi per costruire domande in TypeSafe.
Materiale -> domande separate -> regole -> risultato o verifica umana.
Fonte assente -> completare il materiale. Valutazione incerta -> verifica. Definizione modificata -> nuovo test.
Nel report conserva sia la valutazione sia la versione dei criteri. Quando modifichi la definizione di raccomandazione, ricalcola i periodi confrontati con le stesse regole oppure segnala l'interruzione della comparabilità. Altrimenti un miglioramento del classificatore può sembrare un aumento della visibilità del marchio.
Confidence non significa garanzia percentuale di correttezza
Per Choice e Score la documentazione descrive il campo “confidence”, calcolato dalla distribuzione delle probabilità. Indica quanto il risultato del modello sia netto. Non bisogna interpretare automaticamente 0,9 come un'accuratezza confermata del 90% sulle tue risposte AI. Noul non restituisce un campo “confidence” separato. Come TypeSafe descrive la confidenza delle risposte.
Scegli la soglia per l'invio alla verifica sulla base di un test del compito specifico. Puoi richiedere un livello di confidenza diverso per ordinare una coda di lavoro rispetto all'utilizzo della valutazione in un report per un cliente. Un'elevata confidenza non elimina la necessità del controllo qualità.
Non eliminare dalla misurazione i casi incerti senza mostrarne il numero. Se il modello fatica più spesso a valutare le risposte in una determinata lingua, un report che comprende solo casi facili può distorcere il confronto.
Come verificare l'accuratezza: un esempio con 120 risposte
Nei dati di esempio, un redattore ha valutato 120 risposte. Il modello ne ha contrassegnate 30 come raccomandazioni. Confrontando i risultati con la valutazione del redattore, 24 di queste classificazioni erano corrette e 6 errate. Inoltre, il modello ha mancato 8 raccomandazioni.
| Valutazione del modello | Raccomandazione secondo il redattore | Nessuna raccomandazione secondo il redattore |
|---|---|---|
| Raccomandazione | 24 rilevamenti corretti | 6 falsi allarmi |
| Nessuna raccomandazione | 8 raccomandazioni mancate | 82 valutazioni corrette di assenza |
| Totale | 32 risposte | 88 risposte |
La precisione delle raccomandazioni è 24 / 30 = 80%. Significa che una raccomandazione rilevata su cinque è un falso allarme. Il richiamo è 24 / 32 = 75%, perché secondo il redattore le raccomandazioni effettive sono 32. Il modello ne ha mancate un quarto.
L'accordo complessivo è 106 / 120, circa l'88,3%. Questo numero sembra migliore perché la maggior parte delle risposte non conteneva raccomandazioni. Da solo non basta a valutare l'utilità del classificatore.
Nella pratica prepara esempi separati per perfezionare i criteri e un insieme distinto per la verifica finale. Includi negazioni, raccomandazioni condizionate, nomi di aziende simili e fonti incomplete. Fai valutare una parte del materiale da due persone. Le divergenze possono rivelare una definizione poco chiara prima ancora di valutare il modello.
Il numero 120 serve a illustrare i calcoli e non è uno standard di validazione. La dimensione del campione e il livello di errore tollerato dipendono dall'obiettivo. Verifica il materiale polacco in polacco: TypeSafe indica l'inglese come la lingua in cui attualmente ottiene la migliore accuratezza. Lo stesso criterio vale per il materiale italiano: testalo in italiano. Supporto linguistico nella documentazione.
Quanto costa Jev e quanto costa l'intero processo GEO?
Il listino dei modelli verificato il 20 ottobre 2026 riporta 0,042 USD per milione di token in ingresso. Un token è un'unità di testo fatturata dall'API. Secondo la documentazione, i token in uscita sono gratuiti. È la tariffa del produttore alla data di verifica, non una garanzia sul prezzo futuro. Prezzi nella documentazione dei modelli.
Nei dati di esempio vuoi valutare 2000 risposte e ogni richiesta contiene in media 1200 token in ingresso, inclusi contesto e domande. Il calcolo è: 2000 × 1200 = 2 400 000 token; 2,4 × 0,042 USD = 0,1008 USD, circa 0,10 USD per questa parte del lavoro.
È un calcolo basato sulla dimensione d'ingresso ipotizzata, non una misurazione di chiamate eseguite. Una seconda elaborazione completa della stessa dimensione raddoppierebbe il costo a circa 0,20 USD. Anche contesti più lunghi e nuovi tentativi aumentano il consumo.
| Fase del processo | È inclusa negli 0,10 USD indicati? | Che cosa considerare? |
|---|---|---|
| Valutazione con Jev | Sì, secondo le ipotesi dell'esempio | Il numero effettivo di token in ingresso. |
| Raccolta delle risposte AI | No | API, servizio di raccolta delle risposte o lavoro manuale. |
| Recupero e conservazione delle fonti | No | Accesso alle pagine, estrazione dei contenuti e archiviazione. |
| Controllo qualità | No | Etichettatura del campione, divergenze e verifica umana. |
| Preparazione delle modifiche ai contenuti | No | Revisione, verifica dei fatti e implementazione. |
Perciò una classificazione economica non significa monitoraggio GEO per pochi centesimi. Confronta il costo dell'intero processo e quello necessario per ottenere un risultato corretto e utile. Un prezzo basso per singola valutazione può perdere significato se ogni risultato va poi corretto manualmente.
Che cosa non dimostrano i benchmark del produttore?
La pagina pubblica di valutazione TypeSafe descrive quattro processi di automazione. Valuta i modelli rispetto a etichette di riferimento assegnate da altri modelli. È un confronto in una configurazione di test specifica, non una valutazione indipendente dell'accuratezza di Jev nella GEO in polacco. Metodologia di valutazione TypeSafe.
Non applicare un singolo numero di quel grafico a raccomandazioni di marchi, rilevamento della cannibalizzazione o coerenza delle citazioni. Non dimostra neppure che usare Jev aumenti il numero di raccomandazioni di un'azienda. Quest'ultima conclusione richiederebbe una valutazione separata dei cambiamenti di visibilità e delle condizioni di misurazione.
Jev aiuta a ottenere citazioni su Google e ChatGPT?
Può aiutare a individuare lacune nei contenuti o a organizzare la valutazione delle risposte. L'esecuzione del modello, da sola, non fa sì che un motore di ricerca esterno legga una pagina, la consideri utile e la citi in una risposta.
Google afferma che, per apparire come fonte in AI Overviews e AI Mode, valgono i principi di base della SEO. La pagina deve essere indicizzata e idonea alla visualizzazione con uno snippet di testo. Rispettare i requisiti non garantisce la presenza. Sono linee guida per le funzioni di Google, non una specifica comune a tutti gli assistenti. Google Search Central: funzionalità AI e siti web.
Usa la valutazione per migliorare la risposta offerta al lettore: aggiungere condizioni, spiegare limiti, inserire una fonte o distinguere guide simili. Google consiglia contenuti utili e pensati per le persone. Le sue norme antispam comprendono contenuti prodotti su larga scala soprattutto per manipolare i risultati. Contenuti utili e norme antispam.
Da dove iniziare nella tua azienda?
Definisci prima la domanda aziendale a cui vuoi rispondere. Vuoi sapere se l'AI consiglia il marchio? Se descrive correttamente l'offerta? Se le fonti sostengono affermazioni specifiche? Ognuno di questi compiti richiede criteri diversi.
Se sei all'inizio, controlla la presenza dell'azienda e leggi le risposte per intero. Quando sai che cosa vuoi valutare, prepara un campione etichettato manualmente. Vale la pena testare Jev quando il compito è ripetitivo e sai spiegare come riconoscere un risultato corretto.
Domande frequenti su Jev e GEO
Jev può scrivere un articolo per la GEO?
Jev serve per valutazioni strutturate, non per scrivere articoli in forma libera. Nel processo proposto può valutare una caratteristica specifica di un testo. La creazione e la revisione dei contenuti restano attività separate.
Jev può controllare da solo che cosa dice ChatGPT?
Nel processo descritto fornisci tu la risposta e il contesto necessario. Raccolta delle risposte, conservazione delle fonti e documentazione delle condizioni di misurazione richiedono una gestione separata.
Si può posizionare un'azienda in Jev?
Jev non è il motore di ricerca descritto in questo articolo che presenta ai clienti una classifica di aziende. Può supportare l'analisi del materiale usato nel lavoro sulla visibilità.
Un'elevata confidenza permette di eliminare la verifica umana?
La decisione dipende dall'accuratezza verificata sul tuo compito e dalle conseguenze di un errore. La confidenza del modello non conferma da sola la correttezza. Mantieni un percorso di controllo e verifica regolarmente anche i risultati accettati automaticamente.
Semly utilizza Jev?
Questo articolo non conferma l'implementazione di Jev in Semly. Presenta possibili applicazioni del modello nell'analisi GEO e SEO, con limiti e una proposta di test.
La documentazione e le fonti sono state verificate il 20 ottobre 2026. Le descrizioni delle funzioni e delle tariffe provengono dai materiali TypeSafe. Scenari, schemi e dati di esempio sono elaborazioni editoriali e non rappresentano risultati di marchi o clienti Semly.
Condividi:
