

Descubra se a IA vê a sua empresa
Faça uma auditoria gratuita
Atualizado em 20 de outubro de 2026.
Tem centenas de respostas de IA para analisar. Quer saber quais recomendam a sua empresa, quais apenas mencionam o nome e quais transmitem informações erradas sobre a oferta. Uma simples contagem de menções à marca não esclarece isso. Precisa de um método de avaliação repetível.
O Jev da TypeSafe AI pode desempenhar neste processo o papel de modelo avaliador. Recebe o material e perguntas definidas com precisão, depois devolve resultados que um programa pode comparar, contar e encaminhar para o trabalho seguinte. Na GEO, pode ser um apoio útil à análise de respostas de IA generativa.
A ressalva mais importante: o modelo avalia aquilo que lhe fornece. O resultado não prova que a marca tenha determinada visibilidade em toda a Internet. Este guia descreve aplicações possíveis e como verificá-las. Não apresenta um teste do Jev nem uma integração confirmada com a Semly.
O que é o Jev e qual a sua relação com a GEO?
A TypeSafe descreve o Jev como um modelo da categoria System One, destinado a avaliações rápidas e delimitadas. Em vez de escrever um artigo ou uma análise extensa, devolve uma resposta estruturada à pergunta apresentada. A base é o contexto, chamado “state” na API, e a descrição do que deve avaliar. Fonte: introdução ao Jev.
A GEO, Generative Engine Optimization, abrange o trabalho sobre a presença de uma marca e dos seus conteúdos nas respostas da IA generativa. O Jev pode ajudar a organizar o material em que baseia as decisões. Não é um local onde se consegue uma posição como num motor de pesquisa. Também não substitui um sistema que recolha respostas do ChatGPT, Gemini ou Perplexity.
Uma divisão útil de funções é esta: um processo separado recolhe respostas e fontes, o Jev avalia características específicas, o programa aplica regras e uma pessoa verifica os casos que exigem interpretação. Se depois for necessário reescrever um trecho de uma página, isso será uma tarefa editorial seguinte.
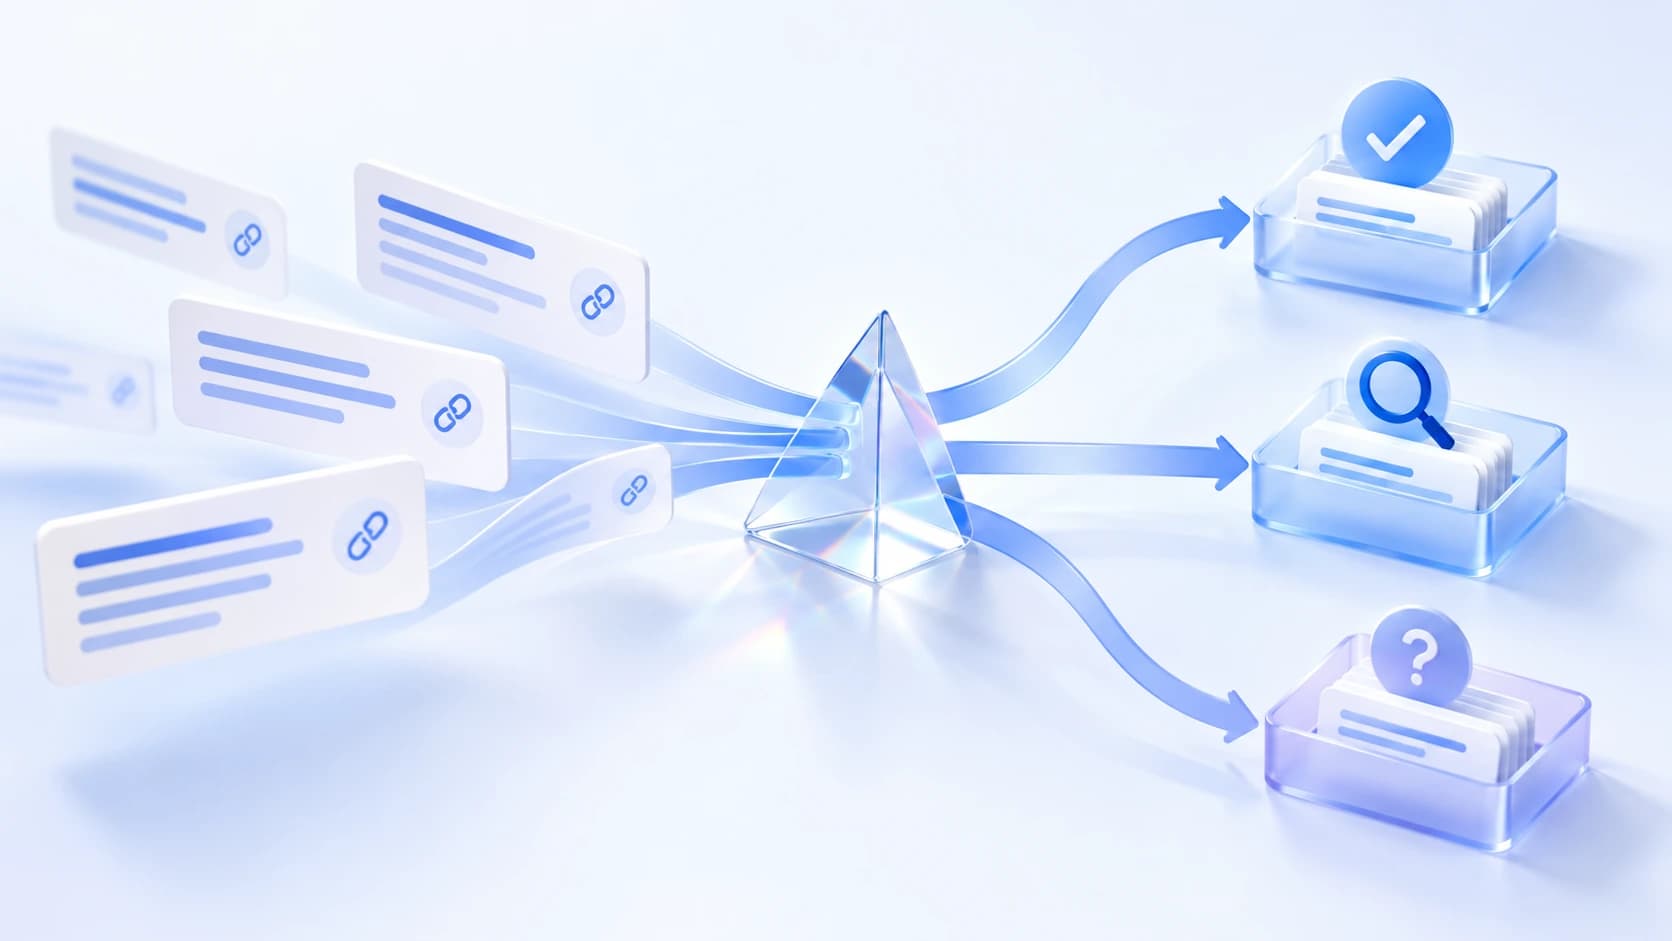
Esquema ilustrativo: guardar a resposta, fazer perguntas independentes e verificar o resultado. Elaboração própria com base na documentação da TypeSafe. A animação mostra um processo proposto, não o funcionamento de uma integração pronta.
Choice, Score e Noul: três formas de fazer perguntas
Escolha o tipo de pergunta de acordo com a decisão que realmente quer tomar. “Esta resposta é boa?” é demasiado abrangente. Pode dividi-la em presença de recomendação, correção dos factos e completude da resposta à necessidade do cliente.
| Tipo | Qual é a pergunta? | Exemplo em GEO |
|---|---|---|
| Choice | Qual das categorias descritas? | Menção neutra, recomendação ou desaconselhamento. |
| Score | Qual o nível da escala descrita? | Sem resposta, resposta parcial ou todas as condições. |
| Noul | A afirmação indicada é verdadeira? | A resposta recomenda explicitamente a marca indicada? |
O Choice escolhe uma categoria entre as fornecidas. As categorias devem ser distintas e os critérios devem abranger os casos de fronteira. Se avaliar várias características, como recomendação e coerência com a oferta, faça perguntas separadas. Documentação do Choice.
O Score exige a descrição de níveis ordenados. “Não responde”, “responde parcialmente” e “responde a todas as condições indicadas” oferecem critérios mais claros do que uma nota de “qualidade de 1 a 10” sem explicação da escala. O resultado refere-se à sua definição de qualidade. Documentação do Score.
O Noul devolve a probabilidade de uma resposta “sim”. Um valor próximo de 0,5 indica incerteza, não cumprimento parcial da condição. A pergunta deve indicar claramente o que significa “sim”. Documentação do Noul.
O que está atualizado em outubro de 2026?
Segundo a documentação verificada a 20 de outubro, a versão mais recente descrita é o Jev 1.14, disponível desde 14 de outubro de 2026. A documentação distingue os identificadores de versão dos aliases variáveis “latest” e “preview”. Nos testes, registe a versão efetiva do modelo, pois uma alteração do alias pode mudar os resultados. Modelos e versões do Jev.
No anúncio da versão 1.14, a TypeSafe também descreve suporte experimental para imagens, contexto maior e o tipo “box”. O fabricante assinala que estas funções ainda têm preparação limitada para utilização em produção. Por isso, o processo de avaliação textual aqui descrito não pressupõe a sua utilização. Anúncio da TypeSafe de 14 de outubro.
Um formato de resultado correto não garante uma avaliação correta. O modelo pode devolver uma categoria permitida e atribuí-la ao caso errado.
7 aplicações do Jev na GEO e na SEO
Os cenários seguintes são propostas de utilização do modelo, não uma lista de funcionalidades da Semly nem resultados de implementações. Cada um exige critérios definidos e uma verificação da exatidão com material adequado à sua tarefa.
1. Distinguir menção, recomendação e desaconselhamento
A frase “a marca X atua neste mercado” não significa o mesmo que “para esta utilização, vale a pena considerar a marca X”. “A marca X não suporta esta utilização” tem ainda outro significado. Todas contêm o nome da empresa, mas apenas uma constitui uma recomendação no contexto descrito.
Pode pedir ao Jev para avaliar a posição da resposta em relação a uma marca específica. Inclua no contexto a pergunta completa do utilizador, pois uma recomendação pode ser condicional: o produto pode adequar-se a uma pequena loja sem cumprir os requisitos de uma grande organização.
Registe separadamente a presença do nome, a recomendação positiva e o link. Um link para o site do fabricante pode acompanhar tanto uma recomendação como uma avaliação crítica do produto.
Os dados de exemplo servem para explicar o método e não representam resultados de nenhuma marca. As etiquetas da animação e dos exemplos seguintes foram preparadas editorialmente e não resultam de chamadas ao Jev. A mesma informação está no texto: menção neutra, recomendação e desaconselhamento são avaliações diferentes, independentemente da presença de um link.
2. Avaliação preliminar da coerência entre uma afirmação e a fonte
Normalmente, é preferível detetar um URL através de regras no programa. A pergunta que exige avaliação é: um trecho específico da fonte sustenta uma frase específica da resposta de IA?
Divida uma frase com várias promessas em afirmações individuais. Junte a cada uma o trecho adequado da página, o âmbito da oferta e a data de leitura. Se não tiver sido possível obter a fonte, assinale a falta de material. Não a transforme numa avaliação de “a fonte não confirma”.
O modelo pode indicar preliminarmente coerência, contradição ou necessidade de verificação, consoante as perguntas concebidas. O método de auditoria completo está descrito separadamente: as fontes citadas confirmam as informações sobre a empresa?.
3. Organizar as perguntas dos clientes
Perguntas sobre preço, implementação, limitações e comparação de ofertas exigem respostas diferentes. A classificação ajuda a organizar a lista para análise e a atribuí-la aos responsáveis.
Defina se uma pergunta pode ter várias intenções. “Quanto custa a implementação e inclui migração?” refere-se simultaneamente ao preço e ao âmbito. Pode dividi-la em duas tarefas ou avaliar as duas dimensões separadamente. Uma única atribuição forçada pode ocultar uma necessidade importante.
Não conclua automaticamente a dimensão da procura a partir do número de perguntas. Muitas formulações semelhantes podem vir da mesma fonte e referir-se a uma única necessidade.
4. Verificar se a página responde às condições da pergunta
Um cliente procura uma solução para uma utilização específica, com uma integração concreta e um limite de orçamento. A página descreve o produto, mas não explica a compatibilidade. O modelo pode indicar preliminarmente essa lacuna de acordo com a escala de completude definida.
Avalie cada condição separadamente. A falta de informação sobre uma integração não significa que o produto não a suporte. Significa que o conteúdo fornecido não resolve a questão. O passo seguinte é verificar o facto e completar a descrição, caso essa informação seja útil ao leitor.
Um Score elevado não é uma pontuação de posicionamento no Google nem a probabilidade de citação pelo ChatGPT. É a avaliação de um material específico segundo os seus critérios.
5. Identificar pares de páginas para verificar canibalização
Primeiro, selecione pares candidatos com base no tema, nas consultas de pesquisa ou na semelhança dos conteúdos. Depois, pode avaliar se respondem à mesma necessidade ou ajudam a tomar decisões diferentes.
O modelo deve receber a pergunta principal, o público e o conteúdo das duas páginas. Palavras semelhantes no título não chegam. O resultado deve gerar uma lista para revisão editorial. A decisão de juntar páginas exige considerar o seu valor, tráfego e papel no site.
Descrevemos uma divisão prática de temas no guia blog e base de conhecimento sem canibalização.
6. Avaliar a utilidade de um link interno proposto
Entre as páginas candidatas a ligação, escolha as que ajudam a dar o próximo passo. Um artigo sobre a escolha de uma solução pode remeter para instruções de preparação de dados, se o leitor precisar delas depois de decidir.
A pergunta para o modelo deve tratar da utilidade da ligação num parágrafo específico. A proximidade temática, por si só, não basta. O programa pode verificar separadamente o funcionamento do URL, e o editor pode avaliar a naturalidade do texto do link.
7. Encaminhar promessas e comparações para verificação
Antes de publicar, pode assinalar trechos com preços, prazos, garantias de resultados ou comparações com concorrentes. Esta deteção ajuda a encaminhar o texto para quem conhece a oferta atual.
É uma etapa de controlo, não uma confirmação automática da veracidade. O modelo não consegue determinar se uma empresa realmente ativa um serviço num dia sem receber uma fonte fiável dessa informação. Se não houver fonte, o artigo precisa de trabalho editorial.
Como conceber um processo verificável?
Comece por uma tarefa, por exemplo reconhecer recomendações de uma marca indicada. Registe a definição de recomendação, os casos excluídos e as regras para tratar respostas incompletas. Só depois construa a automação.
Guarde o material original com a pergunta, o nome do produto de IA, o modo, a língua e a data. A avaliação de uma frase isolada pode ser diferente da avaliação da resposta completa. Ausência de resposta, erro de recolha e resposta sem a marca devem ter etiquetas separadas.
Pode enviar várias perguntas independentes sobre o mesmo material num único pedido. Combine os resultados com regras do programa. Se uma pergunta seguinte precisar de dados que só vai obter depois do primeiro resultado, será necessária outra etapa. Princípios para construir perguntas na TypeSafe.
Material -> perguntas separadas -> regras -> resultado ou revisão humana.
Fonte em falta -> completar o material. Avaliação incerta -> verificação. Alteração da definição -> novo teste.
Guarde no relatório tanto a avaliação como a versão dos critérios. Quando alterar a definição de recomendação, recalcule os períodos comparados segundo as mesmas regras ou assinale a quebra de comparabilidade. Caso contrário, uma melhoria do classificador pode parecer um aumento da visibilidade da marca.
Confidence não é uma garantia percentual de correção
Para Choice e Score, a documentação descreve o campo “confidence”, calculado a partir da distribuição de probabilidades. Informa sobre o grau de definição do resultado do modelo. Não se deve interpretar automaticamente 0,9 como 90% de exatidão confirmada nas suas respostas de IA. O Noul não devolve um campo “confidence” separado. Como a TypeSafe descreve a confiança das respostas.
Escolha o limiar de encaminhamento para revisão com base num teste da tarefa específica. Pode exigir um nível de confiança diferente para ordenar uma fila de trabalho e para usar a avaliação num relatório para um cliente. Confiança elevada não dispensa o controlo de qualidade.
Não exclua casos incertos da medição sem mostrar quantos são. Se o modelo tiver mais dificuldade em avaliar respostas numa língua, um relatório que inclua apenas os casos fáceis pode distorcer a comparação.
Como verificar a exatidão: exemplo com 120 respostas
Nos dados de exemplo, um editor avaliou 120 respostas. O modelo classificou 30 como recomendações. Ao comparar com a avaliação do editor, 24 dessas classificações estavam corretas e 6 erradas. Além disso, o modelo não detetou 8 recomendações.
| Avaliação do modelo | Recomendação segundo o editor | Sem recomendação segundo o editor |
|---|---|---|
| Recomendação | 24 deteções corretas | 6 falsos alarmes |
| Sem recomendação | 8 recomendações não detetadas | 82 avaliações corretas de ausência |
| Total | 32 respostas | 88 respostas |
A precisão das recomendações é 24 / 30 = 80%. Significa que uma em cada cinco recomendações detetadas é um falso alarme. A sensibilidade é 24 / 32 = 75%, pois existem 32 recomendações efetivas segundo o editor. O modelo não detetou um quarto delas.
A concordância global é 106 / 120, cerca de 88,3%. Este número parece melhor porque a maioria das respostas não continha recomendações. Por si só, não basta para avaliar a utilidade do classificador.
Na prática, prepare exemplos separados para aperfeiçoar os critérios e um conjunto diferente para a verificação final. Inclua negações, recomendações condicionais, nomes de empresas semelhantes e fontes incompletas. Peça a duas pessoas para avaliar parte do material. As divergências podem revelar uma definição pouco clara antes de começar a avaliar o modelo.
O número 120 serve para mostrar os cálculos e não é um padrão de validação. A dimensão da amostra e o nível de erro tolerado dependem do objetivo. Verifique material polaco em polaco: a TypeSafe indica o inglês como a língua em que atualmente obtém melhor exatidão. O mesmo princípio aplica-se ao português: teste o material em português. Suporte linguístico na documentação.
Quanto custa o Jev e quanto custa todo o processo GEO?
O preçário dos modelos verificado a 20 de outubro de 2026 indica 0,042 USD por milhão de tokens de entrada. Um token é uma unidade de texto faturada pela API. Segundo a documentação, os tokens de saída são gratuitos. É o preço do fabricante na data de verificação, não uma garantia de preço futuro. Preços na documentação dos modelos.
Nos dados de exemplo, pretende avaliar 2000 respostas e cada pedido tem em média 1200 tokens de entrada, incluindo contexto e perguntas. O cálculo é: 2000 × 1200 = 2 400 000 tokens; 2,4 × 0,042 USD = 0,1008 USD, aproximadamente 0,10 USD para esta parte do trabalho.
Este cálculo usa o tamanho de entrada assumido e não mede chamadas executadas. Uma segunda passagem completa da mesma dimensão duplicaria o custo para cerca de 0,20 USD. Contextos mais longos e novas tentativas também aumentam o consumo.
| Elemento do processo | Está incluído nos 0,10 USD indicados? | O que considerar? |
|---|---|---|
| Avaliação no Jev | Sim, segundo os pressupostos do exemplo | O número real de tokens de entrada. |
| Recolha de respostas de IA | Não | API, serviço de recolha de respostas ou trabalho manual. |
| Obtenção e conservação de fontes | Não | Acesso às páginas, extração de conteúdos e armazenamento. |
| Verificação da qualidade | Não | Etiquetagem da amostra, divergências e revisão humana. |
| Preparação de alterações ao conteúdo | Não | Edição, verificação dos factos e implementação. |
Por isso, classificação barata não significa monitorização GEO por alguns cêntimos. Compare o custo de todo o processo e o custo de obter um resultado correto e útil. Um preço baixo por avaliação pode perder importância se cada resultado tiver de ser corrigido manualmente.
O que não provam os benchmarks do fabricante?
A página pública de avaliação da TypeSafe descreve quatro processos de automação. Avalia modelos relativamente a etiquetas de referência atribuídas por outros modelos. Trata-se de uma comparação numa configuração de teste específica, não de uma avaliação independente da exatidão do Jev na GEO em polaco. Metodologia de avaliação da TypeSafe.
Não aplique um único número desse gráfico a recomendações de marcas, deteção de canibalização ou coerência de citações. Também não prova que utilizar o Jev aumente o número de recomendações de uma empresa. Essa segunda conclusão exigiria uma avaliação separada das alterações de visibilidade e das condições em que foram medidas.
O Jev ajuda a obter citações no Google e no ChatGPT?
Pode ajudar a encontrar lacunas nos conteúdos ou a organizar a avaliação das respostas. Mas executar o modelo não faz, por si só, com que um motor de pesquisa externo leia a página, a considere valiosa e a cite numa resposta.
O Google informa que, para aparecer como fonte no AI Overviews e no AI Mode, aplicam-se os fundamentos da SEO. A página deve estar indexada e ser elegível para apresentação com um excerto de texto. Cumprir os requisitos não garante a presença. São orientações para as funcionalidades do Google, não uma especificação comum a todos os assistentes. Google Search Central: funcionalidades de IA e o seu site.
Use a avaliação para melhorar a resposta ao leitor: completar condições, explicar limitações, acrescentar uma fonte ou distinguir guias semelhantes. O Google recomenda conteúdos úteis e criados para as pessoas. As suas políticas de spam abrangem conteúdos produzidos em escala sobretudo para manipular resultados. Conteúdos úteis e políticas de spam.
Por onde começar na sua empresa?
Primeiro, defina a pergunta de negócio a que precisa de responder. Quer saber se a IA recomenda a marca? Se descreve a oferta de acordo com os factos? Se as fontes sustentam afirmações específicas? Cada tarefa exige critérios diferentes.
Se está a começar, verifique a presença da empresa e leia as respostas completas. Quando souber o que quer avaliar, prepare uma amostra etiquetada manualmente. Vale a pena testar o Jev quando a tarefa é repetitiva e consegue explicar como reconhece um resultado correto.
Perguntas frequentes sobre Jev e GEO
O Jev escreve um artigo para GEO?
O Jev serve para avaliações estruturadas, não para escrever artigos livres. No processo proposto, pode avaliar uma característica específica de um texto. A preparação e a edição dos conteúdos continuam a ser tarefas separadas.
O Jev verifica sozinho o que o ChatGPT diz?
No processo descrito, fornece a resposta e o contexto necessário. A recolha de respostas, a conservação das fontes e a documentação das condições de medição exigem tratamento separado.
É possível posicionar uma empresa no Jev?
O Jev não é o motor de pesquisa descrito neste artigo que apresenta aos clientes um ranking de empresas. Pode apoiar a análise de material usado no trabalho sobre visibilidade.
Confiança elevada permite dispensar uma pessoa?
A decisão depende da exatidão verificada na sua tarefa e das consequências de um erro. A confiança do modelo não confirma, por si só, a correção. Mantenha um percurso de revisão e verifique regularmente também os resultados aceites automaticamente.
A Semly utiliza o Jev?
Este artigo não confirma uma implementação do Jev na Semly. Apresenta possíveis aplicações do modelo na análise GEO e SEO, com limitações e uma proposta de teste.
O estado da documentação e das fontes foi verificado a 20 de outubro de 2026. As descrições das funcionalidades e dos preços provêm dos materiais da TypeSafe. Os cenários, esquemas e dados de exemplo são elaboração editorial e não representam resultados de marcas nem de clientes da Semly.
Compartilhar:
