

Comprueba si la IA ve tu empresa
Consigue una auditoría gratuita
Actualizado el 20 de octubre de 2026.
Tienes varios cientos de respuestas de IA que revisar. Quieres saber cuáles recomiendan tu empresa, cuáles solo mencionan su nombre y cuáles dan información incorrecta sobre tu oferta. Un contador de menciones de marca no basta. Necesitas un método de evaluación repetible.
Jev, de TypeSafe AI, puede actuar como modelo evaluador en ese proceso. Recibe material y preguntas definidas con precisión y devuelve resultados que un programa puede comparar, contar y derivar a las siguientes tareas. En GEO, puede ser una herramienta útil para analizar respuestas de IA generativa.
La advertencia principal: el modelo evalúa lo que le proporcionas. El resultado no demuestra un determinado nivel de visibilidad de la marca en todo Internet. Esta guía describe posibles aplicaciones y cómo comprobarlas. No presenta una prueba de Jev ni una integración confirmada con Semly.
¿Qué es Jev y qué relación tiene con GEO?
TypeSafe describe Jev como un modelo System One para evaluaciones rápidas y acotadas. En vez de escribir un artículo o un análisis extenso, devuelve una respuesta estructurada a una pregunta concreta. Sus bases son el contexto, llamado «state» en la API, y la descripción de lo que se debe evaluar. Fuente: introducción a Jev.
GEO, Generative Engine Optimization, abarca el trabajo sobre la presencia de marcas y contenidos en respuestas de IA generativa. Jev puede ayudar a ordenar el material en el que basas tus decisiones. No es un lugar donde conseguir una posición como en un buscador. Tampoco sustituye un sistema que recopile respuestas de ChatGPT, Gemini o Perplexity.
Una distribución útil de funciones sería: un proceso independiente recoge respuestas y fuentes, Jev evalúa características concretas, un programa aplica reglas y una persona revisa los casos que requieren interpretación. Si después hay que reescribir un fragmento de una página, esa es otra tarea editorial.
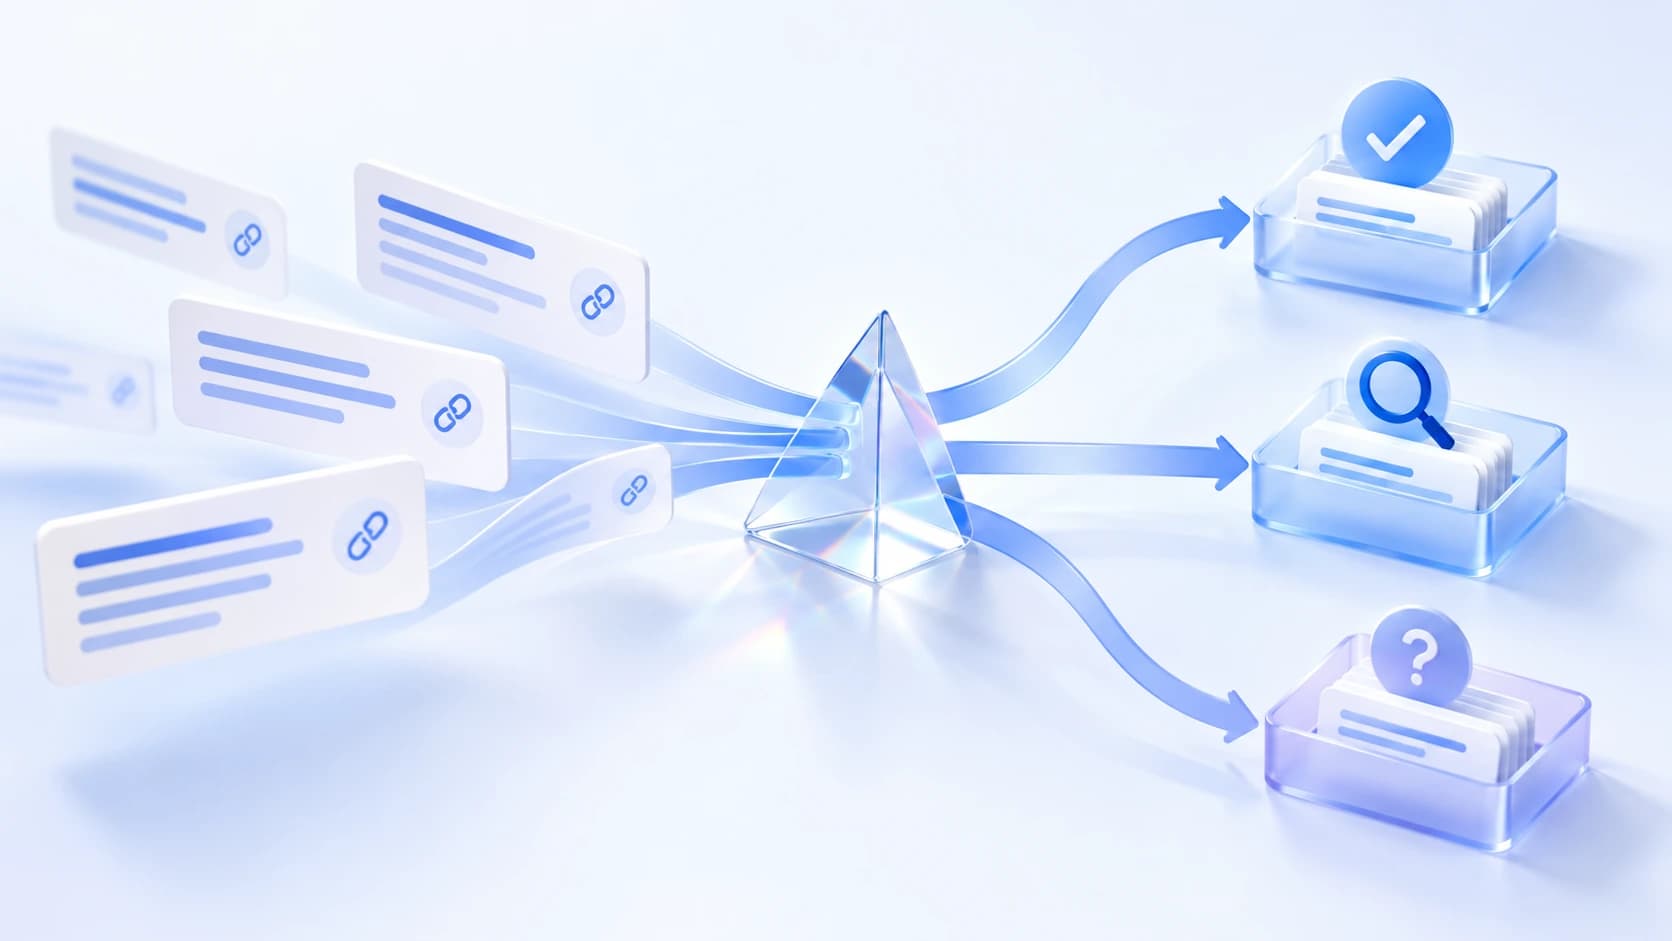
Esquema ilustrativo: conservar respuestas, plantear preguntas independientes y comprobar resultados. Elaboración editorial propia basada en la documentación de TypeSafe. La animación muestra un proceso propuesto, no una integración operativa.
Choice, Score y Noul: tres formas de preguntar
Elige el tipo de pregunta según la decisión que necesitas tomar. «¿Es buena esta respuesta?» es demasiado amplio. Puedes dividirlo en presencia de recomendación, exactitud de los hechos y cobertura de la necesidad del cliente.
| Tipo | ¿Qué pregunta? | Ejemplo en GEO |
|---|---|---|
| Choice | ¿Cuál de las categorías descritas? | Mención neutral, recomendación o desaconsejamiento. |
| Score | ¿Qué nivel de la escala descrita? | Sin respuesta, respuesta parcial o todas las condiciones cubiertas. |
| Noul | ¿Es verdadera la afirmación indicada? | ¿Recomienda la respuesta explícitamente la marca indicada? |
Choice selecciona una categoría de un conjunto proporcionado. Las categorías deben distinguirse y los criterios cubrir los casos límite. Si evalúas varias características, como recomendación y coherencia con la oferta, plantea preguntas separadas. Documentación de Choice.
Score exige definir niveles ordenados. «No responde», «responde parcialmente» y «responde a todas las condiciones indicadas» ofrecen criterios más claros que «calidad de 1 a 10» sin explicar la escala. El resultado depende de tu definición de calidad. Documentación de Score.
Noul devuelve la probabilidad de una respuesta afirmativa. Un valor próximo a 0,5 señala incertidumbre, no cumplimiento parcial de una condición. La pregunta debe dejar claro qué significa «sí». Documentación de Noul.
¿Qué está actualizado en octubre de 2026?
Según la documentación consultada el 20 de octubre, la versión más reciente descrita es Jev 1.14, disponible desde el 14 de octubre de 2026. La documentación distingue los identificadores de versión de los alias variables «latest» y «preview». Durante las pruebas, registra la versión real del modelo, ya que un cambio tras un alias puede modificar los resultados. Modelos y versiones de Jev.
En el anuncio de la versión 1.14, TypeSafe también describe compatibilidad experimental con imágenes, un contexto mayor y el tipo «box». El proveedor señala que estas funciones tienen una preparación limitada para producción. Por ello, el proceso de evaluación textual descrito aquí no presupone su uso. Anuncio de TypeSafe del 14 de octubre.
Un formato correcto no garantiza una evaluación correcta. El modelo puede devolver una categoría permitida y asignarla al caso equivocado.
7 aplicaciones de Jev en GEO y SEO
Los siguientes escenarios son propuestas de uso del modelo, no una lista de funciones de Semly ni resultados de implantaciones. Cada uno requiere definir criterios y comprobar la precisión con material adecuado para tu tarea.
1. Distinguir menciones, recomendaciones y desaconsejamientos
«La marca X opera en este mercado» no significa lo mismo que «Conviene considerar la marca X para este uso». «La marca X no admite este uso» tiene otro significado. Las tres frases incluyen el nombre de la empresa, pero solo una la recomienda en el contexto descrito.
Puedes pedir a Jev que evalúe la postura de una respuesta respecto a una marca concreta. Incluye la pregunta completa del usuario en el contexto, porque las recomendaciones pueden ser condicionales: un producto puede servir para una tienda pequeña, pero no cumplir los requisitos de una gran organización.
Registra por separado la presencia del nombre, la recomendación positiva y el enlace. Un enlace al sitio del fabricante puede acompañar tanto una recomendación como una valoración crítica del producto.
Los datos de ejemplo explican el método y no representan resultados de ninguna marca. Las etiquetas de la animación y de los ejemplos posteriores son editoriales; no proceden de llamadas a Jev. El mismo principio aparece en el texto: una mención neutral, una recomendación y un desaconsejamiento son valoraciones diferentes, haya o no un enlace.
2. Evaluación inicial de si una fuente respalda una afirmación
La detección de una URL suele resolverse mejor con reglas del programa. La pregunta que requiere evaluación es si un fragmento concreto de la fuente respalda una frase concreta de la respuesta de IA.
Divide una frase con varias promesas en afirmaciones individuales. Añade a cada una el fragmento pertinente, el alcance de la oferta y la fecha de consulta. Si no se pudo recuperar la fuente, marca la falta de material. No la conviertas en «la fuente no lo confirma».
Según las preguntas diseñadas, el modelo puede señalar provisionalmente coincidencia, contradicción o necesidad de revisión. Explicamos el método completo de auditoría por separado: ¿confirman las fuentes citadas la información sobre una empresa?.
3. Organizar las preguntas de los clientes
Las preguntas sobre precio, implantación, limitaciones y comparación de ofertas necesitan respuestas distintas. La clasificación ayuda a ordenar la lista de análisis y asignarla a las personas responsables.
Determina si una pregunta puede tener varias intenciones. «¿Cuánto cuesta la implantación e incluye la migración?» trata tanto del precio como del alcance. Puedes separarla en dos tareas o evaluar ambas dimensiones por separado. Forzar una sola categoría puede ocultar una necesidad importante.
No deduzcas automáticamente el tamaño de la demanda a partir del número de preguntas. Muchas formulaciones similares pueden proceder de la misma fuente y referirse a una sola necesidad.
4. Comprobar si una página responde a las condiciones de la pregunta
Un cliente busca una solución para un uso concreto, con una integración determinada y un límite presupuestario. La página describe el producto, pero no explica su compatibilidad. El modelo puede señalar inicialmente esa carencia con una escala de cobertura definida.
Evalúa cada condición por separado. La falta de información sobre una integración no significa que el producto no la admita. Significa que el contenido proporcionado no resuelve la pregunta. El siguiente paso es comprobar el hecho y completar la descripción si la información ayuda al lector.
Un Score elevado no es una puntuación de posicionamiento de Google ni la probabilidad de una cita en ChatGPT. Es una evaluación de material concreto conforme a tus criterios.
5. Identificar pares de páginas para revisar la canibalización
Selecciona primero pares candidatos según la temática, las consultas o la similitud del contenido. Después puedes evaluar si responden a la misma necesidad o ayudan en decisiones distintas.
El modelo debe recibir la pregunta principal, el público y el contenido de ambas páginas. Las palabras coincidentes en los títulos no bastan. El resultado debe generar una lista de revisión editorial. Decidir una fusión requiere considerar su valor, tráfico y función dentro del sitio.
Explicamos una división práctica de temas en la guía blog y base de conocimiento sin canibalización.
6. Evaluar la utilidad de un enlace interno propuesto
Entre los enlaces candidatos, elige los que ayuden a dar el siguiente paso. Un artículo sobre elegir una solución puede enlazar instrucciones para preparar datos si el lector las necesita después de decidir.
La pregunta al modelo debe referirse a la utilidad del enlace en un párrafo concreto. La cercanía temática no basta. El programa puede comprobar por separado que la URL funciona y la persona editora que el texto del enlace resulta natural.
7. Derivar promesas y comparaciones a revisión
Antes de publicar, puedes marcar fragmentos con precios, plazos, garantías de resultados o comparaciones con competidores. Esta detección ayuda a enviar el texto a alguien que conozca la oferta actual.
Es una fase de control, no una confirmación automática de veracidad. El modelo no puede determinar si una empresa realmente pone en marcha un servicio en un día sin una fuente fiable. Si no existe una fuente, el artículo requiere trabajo editorial.
¿Cómo diseñar un proceso que pueda comprobarse?
Empieza por una tarea, como reconocer recomendaciones de una marca concreta. Documenta la definición de recomendación, los casos excluidos y las reglas para respuestas incompletas. Automatiza después.
Conserva el material original junto con la pregunta, el nombre del producto de IA, el modo, el idioma y la fecha. Una frase aislada puede recibir otra evaluación que la respuesta completa. La ausencia de respuesta, un fallo de recuperación y una respuesta sin la marca deben tener etiquetas distintas.
Puedes enviar varias preguntas independientes sobre el mismo material en una solicitud. Combina sus resultados con reglas del programa. Si una pregunta posterior necesita datos que se recuperarán tras el primer resultado, hará falta otra etapa. Principios de diseño de preguntas de TypeSafe.
Material -> preguntas separadas -> reglas -> resultado o revisión humana.
Sin fuente -> completar el material. Evaluación incierta -> verificar. Cambio de definición -> repetir la prueba.
Guarda en el informe tanto la evaluación como la versión de los criterios. Si cambias la definición de recomendación, recalcula los períodos comparados con las mismas reglas o señala una ruptura de comparabilidad. De lo contrario, una mejora del clasificador puede parecer un aumento de visibilidad de marca.
Confidence no es una garantía porcentual de exactitud
Para Choice y Score, la documentación describe un campo «confidence», calculado a partir de la distribución de probabilidades. Indica lo concluyente que es el resultado del modelo. No interpretes automáticamente 0,9 como una precisión comprobada del 90 % en tus respuestas de IA. Noul no devuelve un campo «confidence» separado. Cómo describe TypeSafe la confianza.
Elige el umbral de revisión a partir de una prueba de la tarea concreta. Puedes exigir un nivel para ordenar una cola y otro para usar la evaluación en un informe para clientes. Una confianza elevada no elimina el control de calidad.
No descartes los casos inciertos de la medición sin indicar cuántos son. Si el modelo encuentra más dificultades en un idioma, un informe limitado a los casos fáciles puede distorsionar la comparación.
Cómo comprobar la precisión: ejemplo con 120 respuestas
En los datos de ejemplo, una persona editora evaluó 120 respuestas. El modelo marcó 30 como recomendaciones. Al compararlas con la evaluación editorial, 24 etiquetas fueron correctas y 6 incorrectas. Además, el modelo omitió 8 recomendaciones.
| Evaluación del modelo | Recomendación según la edición | Sin recomendación según la edición |
|---|---|---|
| Recomendación | 24 detecciones correctas | 6 falsas alarmas |
| Sin recomendación | 8 recomendaciones omitidas | 82 evaluaciones correctas sin recomendación |
| Total | 32 respuestas | 88 respuestas |
La precisión de las recomendaciones es aquí 24 / 30 = 80 %. Una de cada cinco recomendaciones detectadas es una falsa alarma. La exhaustividad es 24 / 32 = 75 %, porque según la evaluación editorial hay 32 recomendaciones reales. El modelo omitió una cuarta parte.
La concordancia global es 106 / 120, aproximadamente un 88,3 %. Esta cifra parece mejor porque la mayoría de las respuestas no contenían recomendaciones. Por sí sola no basta para evaluar la utilidad del clasificador.
En la práctica, prepara ejemplos para perfeccionar los criterios y un conjunto separado para la comprobación final. Incluye negaciones, recomendaciones condicionales, nombres de empresas similares y fuentes incompletas. Haz que dos personas evalúen parte del material. Las discrepancias pueden revelar una definición poco clara antes de evaluar el modelo.
La cifra 120 ilustra los cálculos y no es una norma de validación. El tamaño de muestra y el error tolerable dependen del objetivo. Comprueba el material polaco en polaco: TypeSafe señala que el inglés es actualmente el idioma con mejor precisión. Compatibilidad lingüística en la documentación.
¿Cuánto cuesta Jev y cuánto cuesta todo el proceso GEO?
La tarifa de modelos consultada el 20 de octubre de 2026 indica 0,042 USD por millón de tokens de entrada. Un token es una unidad de texto facturada por la API. Según la documentación, los tokens de salida son gratuitos. Es la tarifa del proveedor en la fecha de verificación, no una garantía de precios futuros. Precios en la documentación de modelos.
En los datos de ejemplo quieres evaluar 2000 respuestas y cada solicitud tiene una media de 1200 tokens de entrada, incluidos contexto y preguntas. El cálculo: 2000 × 1200 = 2 400 000 tokens; 2,4 × 0,042 USD = 0,1008 USD, unos 0,10 USD para esta parte del trabajo.
Es un cálculo según un tamaño de entrada supuesto, no la medición de llamadas realizadas. Una segunda pasada completa del mismo tamaño duplicaría el coste hasta unos 0,20 USD. Un contexto mayor y los reintentos también aumentan el consumo.
| Elemento del proceso | ¿Incluido en los 0,10 USD indicados? | ¿Qué considerar? |
|---|---|---|
| Evaluación en Jev | Sí, según las premisas del ejemplo | Número real de tokens de entrada. |
| Recopilación de respuestas de IA | No | API, servicio de recopilación o trabajo manual. |
| Recuperación y conservación de fuentes | No | Acceso a páginas, extracción y almacenamiento. |
| Control de calidad | No | Etiquetado de la muestra, discrepancias y revisión humana. |
| Preparación de cambios de contenido | No | Edición, verificación de hechos e implementación. |
Una clasificación barata no equivale, por tanto, a monitorización GEO por unos céntimos. Compara el coste de todo el proceso y el de conseguir un resultado correcto y útil. El precio reducido por evaluación pierde importancia si después hay que corregirlas todas manualmente.
¿Qué no demuestran los benchmarks del proveedor?
La página pública de evaluación de TypeSafe describe cuatro procesos de automatización. Compara modelos con etiquetas de referencia determinadas por otros modelos. Es una comparación en un entorno de prueba concreto, no una evaluación independiente de Jev para GEO en polaco. Metodología de evaluación de TypeSafe.
No traslades una cifra de ese gráfico a recomendaciones de marca, detección de canibalización o exactitud de citas. Tampoco demuestra que Jev aumente las recomendaciones de una empresa. Esa conclusión requeriría una evaluación separada de los cambios de visibilidad y sus condiciones de medición.
¿Ayudará Jev a conseguir citas en Google y ChatGPT?
Puede ayudar a encontrar carencias de contenido o a organizar la evaluación de respuestas. Sin embargo, ejecutar el modelo no hace que un buscador externo lea una página, la considere valiosa y la cite en una respuesta.
Google indica que los fundamentos de SEO se aplican para aparecer como fuente en AI Overviews y AI Mode. La página debe estar indexada y ser apta para mostrarse con un fragmento de texto. Cumplir los requisitos no garantiza la presencia. Son directrices para funciones de Google, no una especificación común a todos los asistentes. Google Search Central: funciones de IA y tu sitio.
Usa la evaluación para mejorar la respuesta al lector: completar condiciones, explicar límites, añadir una fuente o diferenciar guías parecidas. Google recomienda contenido útil creado para las personas. Sus políticas de spam incluyen contenido producido a escala principalmente para manipular resultados. Contenido útil y políticas de spam.
¿Por dónde empezar en tu empresa?
Define primero la pregunta de negocio. ¿Quieres saber si la IA recomienda tu marca? ¿Si describe la oferta con exactitud? ¿Si las fuentes respaldan afirmaciones concretas? Cada tarea necesita criterios diferentes.
Si estás empezando, comprueba la presencia de la empresa y lee las respuestas completas. Cuando sepas qué quieres evaluar, prepara una muestra etiquetada manualmente. Merece la pena probar Jev cuando la tarea es repetible y puedes explicar cómo reconocer un resultado correcto.
Preguntas frecuentes sobre Jev y GEO
¿Puede Jev escribir un artículo para GEO?
Jev sirve para evaluaciones estructuradas, no para redactar artículos de forma libre. En el proceso propuesto puede evaluar una característica concreta del texto. La creación y edición del contenido siguen siendo tareas separadas.
¿Comprueba Jev por sí mismo qué dice ChatGPT?
En el proceso descrito proporcionas la respuesta y el contexto necesario. Recoger respuestas, conservar fuentes y documentar las condiciones de medición requiere una gestión separada.
¿Se puede posicionar una empresa en Jev?
Este artículo no describe Jev como un buscador que muestre clasificaciones de empresas a los clientes. Puede apoyar el análisis del material utilizado para trabajar la visibilidad.
¿Una confianza elevada permite prescindir de una persona?
La decisión depende de la precisión comprobada para tu tarea y de las consecuencias de un error. La confianza del modelo no confirma por sí sola la exactitud. Mantén una vía de revisión y comprueba periódicamente también los resultados aceptados automáticamente.
¿Utiliza Semly Jev?
Este artículo no confirma una implantación de Jev en Semly. Presenta posibles aplicaciones del modelo en análisis GEO y SEO, con sus límites y una propuesta de prueba.
La documentación y las fuentes se comprobaron el 20 de octubre de 2026. Las descripciones de funciones y tarifas proceden de TypeSafe. Los escenarios, esquemas y datos de ejemplo son elaboraciones editoriales y no representan resultados de marcas ni clientes de Semly.
Compartir:
